Спасибо, вроде оно, почитаю. Я хочу выкатить 10% новых подов, все протестить в ручном режиме, а потом только продолжить
Тогда это вам прям 100 канарейка.
 Andrey


 Petr
30. 12 из которых я вполне успешно работаю в ИТ сфере. И я никогда себе не позволяю задать вопрос, не поискав в документации и на stackoverflow
Желаю вам вполне успешно продолжать общаться с людьми в таком же стиле ;)
 Petro
 Валентин
Спасибо, вроде оно, почитаю. Я хочу выкатить 10% новых подов, все протестить в ручном режиме, а потом только продолжить
ну обычно все автоматизировать стараются все-таки, но наверное и для ручного можно. Но это канареечный деплой, да
Andrey
Спасибо, вроде оно, почитаю. Я хочу выкатить 10% новых подов, все протестить в ручном режиме, а потом только продолжить
Там можно чать трафика перевести по условию. Например по куке или по хедеру. Катите, ставите себе куку и идете по привычным адерсам как на прод, а на самом деле попадаете на новую версию.
 Stanislav
 Константин
Коллеги, кто какой использует сторадж бэкэнд для Hashicorp Vault? Обоснуйте почему именно его используете.
мне тоже интересно, попробуй тут узнать: @ru_hashicorp
 Tadeusz
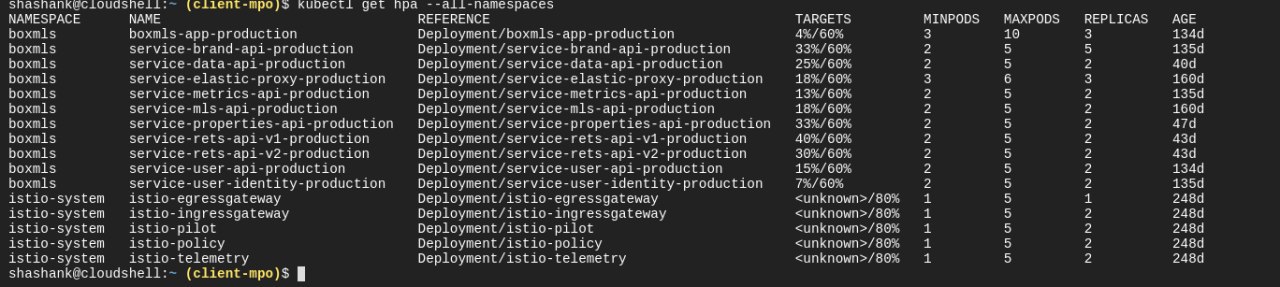
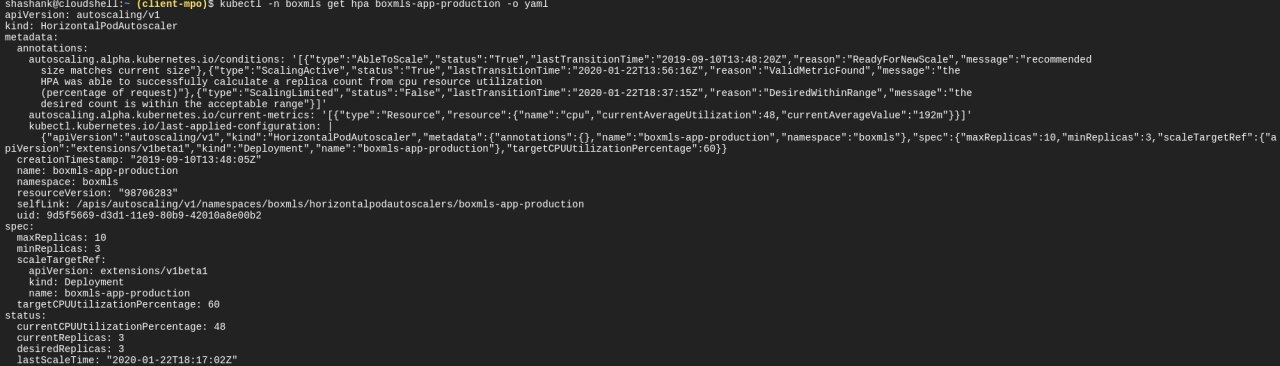
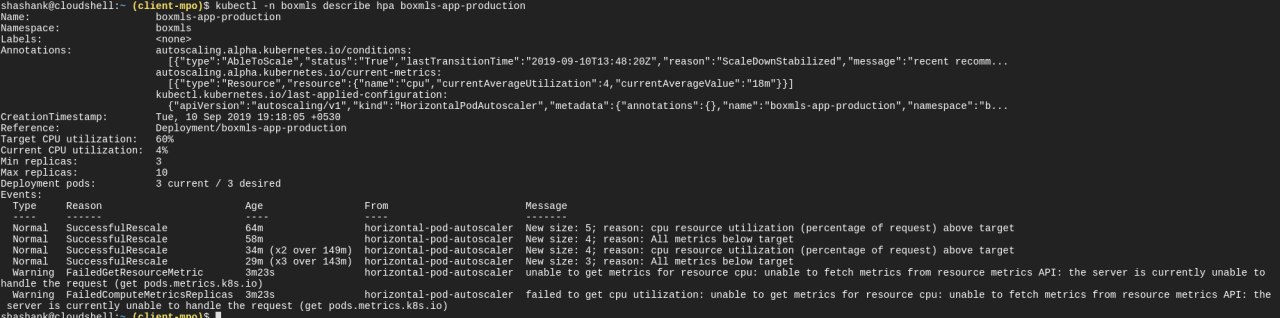
ну че, никто не знает? pod didn't trigger scale-up (it wouldn't fit if a new node is added): 3 max cluster cpu, memory limit reached
Petr
 Serhii
Лимит выюзал
Tadeusz
автоскейлер в gke...
Tadeusz
 Tadeusz
 Dmitry
ну че, никто не знает? pod didn't trigger scale-up (it wouldn't fit if a new node is added): 3 max cluster cpu, memory limit reached
У пода есть афинити какие-то которые не дадут поду приехать на новую поднятую ноду? Или селектор
Tadeusz
нет
Tadeusz
что ты имеешь в виду?
Dmitry
что ты имеешь в виду?
resources.limits, resources.requests у пода, который находится в деплойменте, на который натравлен hpa
Tadeusz
ах, сек
Dmitry
ах, сек
также посмотри, может ты уперся в максимальное количество нод? Autosclaler с каким параметром --nodes запущен?
Dmitry
автоскейлер в gke...
Сорян, у тебя же gke. Тогда где-то должно быть в настройках кластера --max-nodes
Tadeusz
 Roman
поменяй namespace, да задеплой. Зачем в рантайме менять?
создались новые сервисы и деплой и инресс а в default namespace все осталось
Tadeusz
Сорян, у тебя же gke. Тогда где-то должно быть в настройках кластера --max-nodes
а где посмотреть то?
Roman
дубликаты получились
Tadeusz
угу, ищу
Tadeusz
хм... неужели отключение auto node provisioning порешало
Tadeusz
блет
Dmitry
создались новые сервисы и деплой и инресс а в default namespace все осталось
А почему ты создал дубликат(на тот же самый домен) того же самого ingress во втором namespace? Почему не дропнул старый и не создал новый? Речь выше же была про deployment, а не про ingress
Dmitry
хм... неужели отключение auto node provisioning порешало
Ознакомся еще с FAQ, у них есть пункт на счет этой ошибки: https://github.com/kubernetes/autoscaler/blob/master/cluster-autoscaler/FAQ.md#i-have-a-couple-of-pending-pods-but-there-was-no-scale-up
Roman
А почему ты создал дубликат(на тот же самый домен) того же самого ingress во втором namespace? Почему не дропнул старый и не создал новый? Речь выше же была про deployment, а не про ingress
ну как дропить запросы не камельфо хотел както gracefully
Roman
ладно ингресс пофигу это было побольше части с деплоиментом
Roman
а потом ингресс незнал как перенести так произошло тоже самое
 Solyar
Подскажите где подкрутить кластеру гайки чтобы он понимал быстрее что нода отвалилась и поды "выселенные" передеплоил на живые тачки?
Solyar
Где-то слышал про таймаут в 5m не могу в доке найти то что нужно
Dmitry
ну как дропить запросы не камельфо хотел както gracefully
ну по идее если сделать kubectl delete ingress blbla; kubectl apply, то ingress просто за один релоад это сделает, и даунтайма не будет. Также можно это сделать через службу которая смотрит в другой namespace
Dmitry
Подскажите где подкрутить кластеру гайки чтобы он понимал быстрее что нода отвалилась и поды "выселенные" передеплоил на живые тачки?
как скоро он начнет выселять под через tollerations решается, например:
tolerations:
- effect: NoExecute
key: node.kubernetes.io/not-ready
operator: Exists
tolerationSeconds: 60
- effect: NoExecute
key: node.kubernetes.io/unreachable
operator: Exists
tolerationSeconds: 60
А вот как скоро ноду куб пометит в notReady, это вроде никак не задать, но я не уверен. Там около 60 секунд
Solyar
как скоро он начнет выселять под через tollerations решается, например:
tolerations:
- effect: NoExecute
key: node.kubernetes.io/not-ready
operator: Exists
tolerationSeconds: 60
- effect: NoExecute
key: node.kubernetes.io/unreachable
operator: Exists
tolerationSeconds: 60
А вот как скоро ноду куб пометит в notReady, это вроде никак не задать, но я не уверен. Там около 60 секунд
Ну я думаю после парочки несработавших хартбитов
Dmitry
Ну я думаю после парочки несработавших хартбитов
Я это тестил, всегда около 60-70 секунд получается
Solyar
как скоро он начнет выселять под через tollerations решается, например:
tolerations:
- effect: NoExecute
key: node.kubernetes.io/not-ready
operator: Exists
tolerationSeconds: 60
- effect: NoExecute
key: node.kubernetes.io/unreachable
operator: Exists
tolerationSeconds: 60
А вот как скоро ноду куб пометит в notReady, это вроде никак не задать, но я не уверен. Там около 60 секунд
Хмм, думал можно глобально. Ладно с толерейшенами поиграю
Solyar
Спасибо
Dmitry
Хмм, думал можно глобально. Ладно с толерейшенами поиграю
Эти дефолты для tolerations можно тоже выставить вроде в kube-apiserver
Solyar
Буду копать в эту сторону тогда
Dmitry
https://kubernetes.io/docs/reference/command-line-tools-reference/kube-apiserver/
--default-not-ready-toleration-seconds int Default: 300
--default-unreachable-toleration-seconds int Default: 300
 Victor
Кто-нибудь, интересно, использует для мониторинга кубовых компонентов нечто отличное от Прометеуса и его производных?
Solyar
https://kubernetes.io/docs/reference/command-line-tools-reference/kube-apiserver/
--default-not-ready-toleration-seconds int Default: 300
--default-unreachable-toleration-seconds int Default: 300
Ну да поковырялся нашел по поводу отметки ноды как недоступной much longer than the 40 second default timeout for unreachable nodes
Dmitry
Буду копать в эту сторону тогда
А сорян, когда тестил нода помечалась за 30-40 секунд. Хорошо что это записал +)
Solyar
Solyar
хотя это производная)
Victor
инфлюкс?
Хм. Наверное мне следует посмотреть какие экспортеры есть у какого-нибудь nginx-ingress-controller
Victor
Dmitry
Ответ: только Прометеус
наверняка есть преобразоваторы метрик прома, в то что тебе надо. Будет такой экспортер, который читает метрики в пром формате из nginx-ingress-controller, а выдает в нужном тебе
Victor
Мне скорее наоборот не хочется в своей софтине поддерживать что-то большее чем Прометеус )
Solyar
Мне скорее наоборот не хочется в своей софтине поддерживать что-то большее чем Прометеус )
Я метрики собирал двумя штуками (не только из куба а в целом) это StatsD / Prometheus
Solyar
Смею предположить что этих скрейперов просто куча
Solyar
Главное поискать
Victor
Смею предположить что этих скрейперов просто куча
Да это понятно) факт в том что когда в доку по ингресс-контроллеру смотришь раздел Monitoring - видишь там «Настройте Прометеус и Графану», всё :)
Solyar
Да это понятно) факт в том что когда в доку по ингресс-контроллеру смотришь раздел Monitoring - видишь там «Настройте Прометеус и Графану», всё :)
Ну они мейнтейнят такое решение. Хотите другое, еб... сами, я думаю такая позиция)
Victor
Вот значит я буду только такое мэйнтейнить )
Oleh
Я statsd заменил самописной приблудой (там где прометеус не получается использовать, например php демоны) https://github.com/kismia/pushd может кому нужно. Там есть пару багов но в целом работает и очень быстро
Roman
Oleh
А как экспоузить метрики без сервера? Только в файл, а в кубе это не очень удобно
Roman
может тут есть такие которые kubernetes-monitoring целый сет инсталили с Digital ocean marketplace в Kubernetes?
Roman
ну или какую тутору что бы весь мониторинг стэк в кубер запустить
Roman
тут столько много чего входит - месяц самому тут все связывать между собой
alertmanager-operated ClusterIP None <none> 9093/TCP,9094/TCP,9094/UDP 14d
prometheus-operated ClusterIP None <none> 9090/TCP 14d
prometheus-operator-alertmanager ClusterIP 10.245.73.164 <none> 9093/TCP 14d
prometheus-operator-grafana LoadBalancer 10.245.233.45 157.230.78.67 80:30444/TCP 14d
prometheus-operator-kube-state-metrics ClusterIP 10.245.84.52 <none> 8080/TCP 14d
prometheus-operator-kubelet ClusterIP None <none> 10250/TCP 14d
prometheus-operator-operator ClusterIP 10.245.38.24 <none> 8080/TCP,443/TCP 14d
prometheus-operator-prometheus ClusterIP 10.245.180.255 <none> 9090/TCP 14d
prometheus-operator-prometheus-node-exporter ClusterIP 10.245.19.6 <none> 9100/TCP 14d
Solyar
весь конфиг в сикретах где-то?
Roman
многовато
Roman
я хз - с маркетплейса заинсталил хз чего
Roman
с digital ocean market place
Solyar
Да я бы не сказал. Operator точно такой же стек деплоит
Roman
https://github.com/digitalocean/marketplace-kubernetes/tree/master/src/prometheus-operator
Roman
это форк надо понимать
Roman
он вроде как-то адаптирован под ДО
Roman
только что там адаптировано я хз
Roman
и как мне что-то override'ть здесь если вся эта лабуда с одной командой инсталится