type json_in_json
как вариант, но реп пятилетней давности и уже deprecated
 Aset


 Alexey
Чесно не нашел в дебрях того что насоздавал хелм
external_labels надо подправить
 Sn00part
Чесно не нашел в дебрях того что насоздавал хелм
external_labels надо подправить
https://github.com/coreos/prometheus-operator/issues/455
 Grisha
Ребят, подскажите плиз, есть вам нужно сделать логику всяких тайм дейвайс детекшен, ретраев и прочей лабуты, вы юзаете ингресс в кубе? и ингресс в кубе это уже просто / -> service?
Sn00part
Вопрос не очень понятен. Ингресс это для того, чтобы по hostname заэкспозить сервис наружу
 Dmitry
Ребят, подскажите плиз, есть вам нужно сделать логику всяких тайм дейвайс детекшен, ретраев и прочей лабуты, вы юзаете ингресс в кубе? и ингресс в кубе это уже просто / -> service?
например nginx ingress ретрает как и обычный nginx . ingress -> под. Поды узнает из endpoints сервиса
Grisha
я к тому что стоит ли полностью переходить на ингресс или поставить впередеи обычный nginx который будет выполнять логику, а уже в куб передавать конечный запрос чтобы ингрес в кубе просто ссылался на нужный ендпоинт без логики
Dmitry
я к тому что стоит ли полностью переходить на ингресс или поставить впередеи обычный nginx который будет выполнять логику, а уже в куб передавать конечный запрос чтобы ингрес в кубе просто ссылался на нужный ендпоинт без логики
выбор за тобой. Я для себя решил юзать ingress без какого-то балансера перед ним, с целью уменьшить количество прыжков запроса по балансерам и прокси
Grisha
---
apiVersion: extensions/v1beta1
kind: Ingress
metadata:
annotations:
nginx.ingress.kubernetes.io/configuration-snippet: |
set $args $args&host=com;
proxy_redirect off;
add_header X-Proxy-Cache $upstream_cache_status;
nginx.ingress.kubernetes.io/rewrite-target: /public/api/v0/config
name: mvp.site.com.admin.config
namespace: stage
spec:
rules:
- host: site.com
http:
paths:
- backend:
serviceName: edge
servicePort: 80
path: /admin/config
---
apiVersion: extensions/v1beta1
kind: Ingress
metadata:
annotations:
nginx.ingress.kubernetes.io/configuration-snippet: |
set $args $args&host=com;
proxy_redirect off;
add_header X-Proxy-Cache $upstream_cache_status;
nginx.ingress.kubernetes.io/rewrite-target: /public/api/v0/config/ufc
name: mvp.site.com.com.admin.config.ufc
namespace: stage
spec:
rules:
- host: site.com
http:
paths:
- backend:
serviceName: edge
servicePort: 80
path: /admin/config/ufc
и тоже пложишь вот такую шляпу?
Grisha
у меня просто таких извратов на 1000+ строк
Dmitry
у меня просто таких извратов на 1000+ строк
часть логики можно реализовать на стороне пода куда проксирует ingress. На том же nginx
Grisha
и тогда у меня будет под 1000 nginx подов))
 Злодей
Коллеги, доброго времени суток, нет ли у кого наводки на готовые нагрузочные тесты опеншифта именно в плане создания множества объектов и проверки работоспособности самого шифта. Или же, возможно, у кого-то есть объяснение, почему не удаётся нигде в репах отыскать atomic-openshift-tests, который похож именно на то, что нужно
Dmitry
и тогда у меня будет под 1000 nginx подов))
ну как правило фронт же чем-то все равно надо раздавать. Бывает нужна всякая логика - типо авторизации. У меня часто nginx есть в подах. Можно в один под с бэкендом его пихать, если сильно надо.
Hankey
Доброе утро, товарищи!
Пытаюсь развернуть kube-eagle в кластере кубернетес 1.11.3
но ингресс упорно отдаёт 503. На тестовом стенде v1.16 работает норм. Может быть кто сталкивался с подобной проблемой?
https://pastebin.com/gRjkjKcw
 Константин
Всем привет. Извините, нужна помощь небольшая, я новичок.
Не деплоится образ с докера
Константин
Containers:
testheedbookapp:
Container ID:
Image: hub.docker.com/repository/docker/gready413/myrep:latest
Image ID:
Port: <none>
Host Port: <none>
State: Waiting
Reason: ImagePullBackOff
Ready: False
Restart Count: 0
Environment: <none>
Mounts:
/var/run/secrets/kubernetes.io/serviceaccount from default-token-rp769 (ro)
Conditions:
Type Status
Initialized True
Ready False
ContainersReady False
PodScheduled True
Volumes:
default-token-rp769:
Type: Secret (a volume populated by a Secret)
SecretName: default-token-rp769
Optional: false
QoS Class: BestEffort
Node-Selectors: <none>
Tolerations: node.kubernetes.io/not-ready:NoExecute for 300s
node.kubernetes.io/unreachable:NoExecute for 300s
Events:
Type Reason Age From Message
---- ------ ---- ---- -------
Warning Failed 15s (x287 over 65m) kubelet, slave-node Error: ImagePullBackOff
 Stefan
 Sergei
gready413/myrep:latest вот так просто укажите
Sergei
или же нужна атворизация
 Pavel
@kvaps Привет, не подскажешь, в вашей конфигурации отправке логов через journalbeat обрабатывается ли как-то multiline-логи? Не нашел в journalbeat поддержки этого дела.
G72K
нуу как один из вариантов наколенко... тегать спец тегом branchname-last-build образ и при следующей сборке сначала делать git pull asas:branchname-last-build
Не подсосет без приседаний с --cache-from. У нас от этого шелл хелпер docker:build строк до 50 распух
G72K
Приходится каждый stage билдить с --target, пушить в регистри под уникальным тагом, затем перед билдом снова заглядывать в докерфайл и пулить всё что потенциально может использоваться как кеш, затем все это передать в множество --cache-from , причем уникальный --cache-from для каждого стейджа, при этом очень аккуратно следя за порядком следования, т.к. докер не анализирует все кеши, а берет первый матч
 George
какой-то гемор, ога
G72K
Разрабы nginx советуют на njs переходить.
У lua киллер фича - C ffi. Любую сишную либу можно в nginx подтянуть. Незачем писать nginx модуль для преобразования картинок, когда можно через lua libimagemagik подтянуть
Dmitry
У lua киллер фича - C ffi. Любую сишную либу можно в nginx подтянуть. Незачем писать nginx модуль для преобразования картинок, когда можно через lua libimagemagik подтянуть
Я бы не стал на лету преобразовывать картинки в nginx. Ну это вопрос нагрузки конечно.
G72K
Коллеги, есть кто работал с GKE с включенным WorkloadIdentity + Private cluster + Network Policy без Istio.
Проблема в том, что при попытке настроить egress networkpolicy с подов, при любых параметрах режется доступ на Google metaserver (используемый Workload Identity)
Добавлять в NetworkPolicy 169.254.169.254/32 пробывал - не работает. Похоже что под капотом происходит какой-то особенный роутинг на этот IP.
Там workload identity proxy на каждой ноде . Дательно не смотрел,кажется у нас не режется, но проверю
G72K
Я бы не стал на лету преобразовывать картинки в nginx. Ну это вопрос нагрузки конечно.
Ну это как пример :) часто можно на коленке собрать что-то высокопроизводительное склеив С библиотеки луой . Я как то подтянул либу для битвекторов и накостылял блумфильтры прям в nginx , здорово разгрузив приложение
Sn00part
Вот я тоже так делаю, разрабы типа нам надо 475 спринтов все исправить, садишься, пишешь на луа оно там временно как-то работает, потом допиливают со временем
G72K
 Igorь
А почему kubectl proxy может отдавать на все запросы default backend - 404?
Запросы были такие:
curl 127.0.0.1:8001/api
curl http://localhost:8001/api
curl http://localhost:8001/api/
curl http://localhost:8001/api/v1
Sn00part
Ну зато работает. Не будем же мы говорить, извините, клиенты, у нас тут приложуха закрывается на пару недель, мы пока серваков подтащим да порефакторим!
George
 Just a baka
А почему kubectl proxy может отдавать на все запросы default backend - 404?
Запросы были такие:
curl 127.0.0.1:8001/api
curl http://localhost:8001/api
curl http://localhost:8001/api/
curl http://localhost:8001/api/v1
Потому что ингресс рулит запросы по хостнеймам, например, и не знает про эти ваши локалхосты ничего.
Нужно хотя бы через заголовок передать хостнейм (curl -H 'Host: host.name' http://localhost/blah/)
George
Может хостнейм через хидер?
 David
Т.е. каждый stage может быть запушен только один раз? Как обновлять эти кеши тогда?
Не, каждое уникальное состояние каждого стейджа может быть запушено только один раз. Там контрольная сумма используется.
Igorь
Там есть скрипт, которым они призывают пользоваться https://github.com/helm/charts/tree/master/stable/hadoop
 Игорь
Потому что ингресс рулит запросы по хостнеймам, например, и не знает про эти ваши локалхосты ничего.
Нужно хотя бы через заголовок передать хостнейм (curl -H 'Host: host.name' http://localhost/blah/)
при чем тут ингресс, если он к аписерверу ломится
George
при чем тут ингресс, если он к аписерверу ломится
Я поэтому и спросил - что конкретно коллега хочет
Sn00part
Там че за кубер? Не ранчер?
Igorь
ранчер
Sn00part
Там криво работает апи
Sn00part
Надо добавлять в урл ид кластера
Igorь
лан. я уже прочитал скрипт и примерно понял, что будет на выходе после него, и внес в values.yaml результат
Sn00part
Короче погугли, у меня такое было, когда надо было вручную дёргать файналайзер и пришлось разбираться, как правильно курлануть кубер в ранчере
 𝚔𝚟𝚊𝚙𝚜
Я может опоздал, но BUILDKIT как раз пушит в регистри все промежуточные слои
Не опоздал, как оказалось кэш kaniko плохо работает с ARG/VAR при staging building
Just a baka
ну а куда еще kubectl proxy может проксировать?
Возможно, коллега имел в виду что-то другое, т.к. долбится он в результате в ингресс)
Sn00part
Да не
Sn00part
В ранчер он долбится
Sn00part
Ингресс тут не причем
𝚔𝚟𝚊𝚙𝚜
Я может опоздал, но BUILDKIT как раз пушит в регистри все промежуточные слои
Buildkit крутой тем что позволяет маунить слои предыдущих стейджей в новые во время сборки, но то что он кэшировать умеет не знал, обязательно посмотрю
Sn00part
Со слоями вы канеш круто намутили. А какие задачи решали, если не секрет? И решили ли? Выглядит очень сложно и может сломаться везде.
𝚔𝚟𝚊𝚙𝚜
@kvaps Привет, не подскажешь, в вашей конфигурации отправке логов через journalbeat обрабатывается ли как-то multiline-логи? Не нашел в journalbeat поддержки этого дела.
Привет, не знаю, у нас пока не было такой задачи
𝚔𝚟𝚊𝚙𝚜
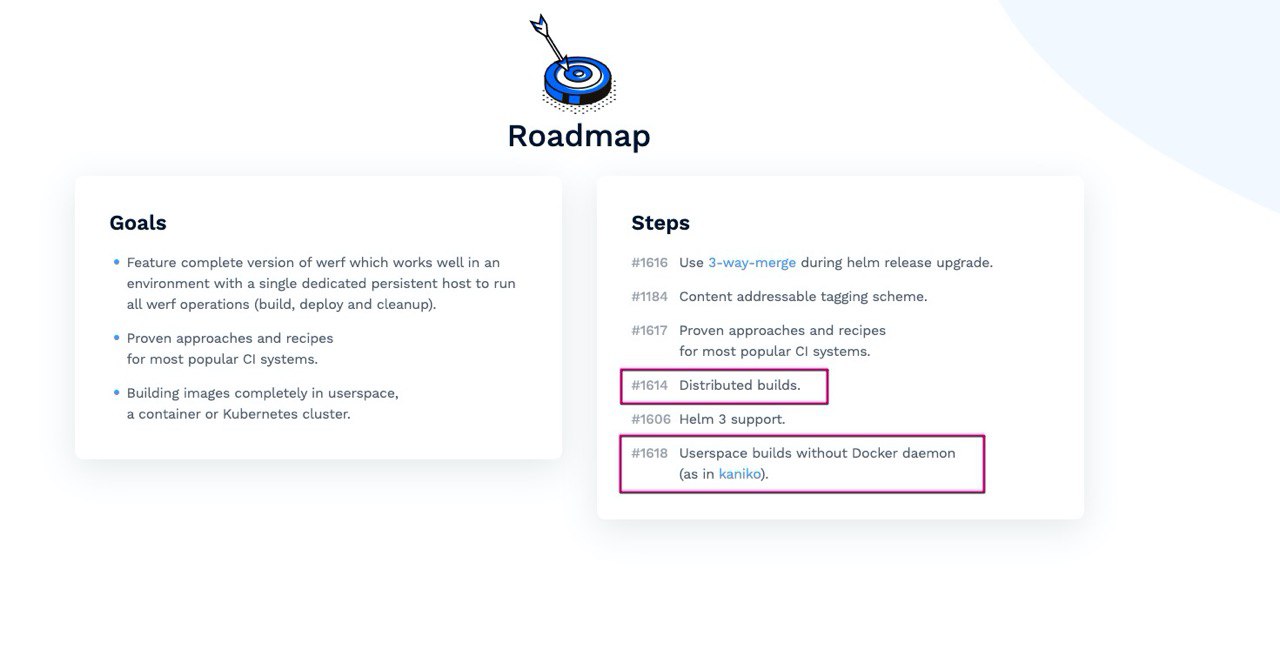
 Tadeusz
говорят, не плохой комбаин)
𝚔𝚟𝚊𝚙𝚜
говорят, не плохой комбаин)
Я просто настолько доволен QBEC, что не готов его менять на что-то другое:)
Tadeusz
наслышан, да
𝚔𝚟𝚊𝚙𝚜
Причём бюлдитб имаджи я тоже думал с его помощью:
1. создаёшь джобу в кубе с нужными параметрами
2. ждёшь завершения
3. деплоишь собранный имадж
George
George
Но ведь werf это не только про сборку образов, не будет ли оверкилом юзать его конкретно для этой задачи?
Как по мне создалось впечатление что это какой-то дикий комбайн для всего: начиная от сборки имаджей и заканчивая деплоем хелм чартов
ну, правильно, гитлаб - девопс-комбайн, а верф - CI/CD-комбайн
George
разве это плохо?
David
Но ведь werf это не только про сборку образов, не будет ли оверкилом юзать его конкретно для этой задачи?
Как по мне создалось впечатление что это какой-то дикий комбайн для всего: начиная от сборки имаджей и заканчивая деплоем хелм чартов
Не, не будет никакой проблемы. Стадия сборки отделена. Кроме этого мы везде следуем принципу что должны быть и “высокоуровневые команды”, которые покрывают наиболее частые кейсы, плюс должны быть “low level команды”, которые позволяют собрать что-то кастомное. Например у нас есть “wef build”, а есть команды отдельно работы со стейджами “werf stage xxxx”, и вот уже там будут pull и push, например.
David
Я просто настолько доволен QBEC, что не готов его менять на что-то другое:)
Мы скоро сделаем поддержку jsonnet, кстати, в хельмовых чартах. То есть рядом с yaml можно будет складывать jsonnet. По крайней мере это прямо в планах прямо на этот год.
David
И еще, кстати, мы тут запили офигительную штуку: https://werf.io/documentation/reference/deploy_process/resources_update_methods_and_adoption.html .
David
Теперь нет тупых проблем с двух сторонним мержем и теперь можно ресурсы адоптить.
𝚔𝚟𝚊𝚙𝚜
Мы скоро сделаем поддержку jsonnet, кстати, в хельмовых чартах. То есть рядом с yaml можно будет складывать jsonnet. По крайней мере это прямо в планах прямо на этот год.
Вот это уже интересно, но в QBEC меня больше всего порадовала возможность, что я могу работать с helm-charts без каких либо тарболов, то есть я могу подключить их в виде git submodule, затем через std.native('expandHelmTemplate') отрендерить чарт в переменную и дальше наложить любые мутации на него.
Это в свою очень помогло:
1) деплоить без тилера
2) не иметь чарт музеума
3) изменять официальные чарты на лету (было особенно
актуально при обновлении на 1.16)
4) всё изменения декларативно хранить в репозитории и описывать для каждого энвайромента
5) разделить зоны ответственности, например я могу задеплоить RBAC и CRD ресурсы из чарта прометеуса, предварительно просмотрев их, а остальную часть чарта делегировать человеку который занимается мониторингом