 რად


Попробуй так
 𝒦𝒶𝓁𝒶𝓎⛩
МОжно по подробнее про юзера, где его найти?
𝒦𝒶𝓁𝒶𝓎⛩
он же не на моей машине
რად
\kubectl create clusterrolebinding cluster-admin-binding --clusterrole cluster-admin --user test-user
რად
Попробуй так
რად
Только не делай это на рабочем
𝒦𝒶𝓁𝒶𝓎⛩
я уже боюсь его делать) Это только на моей машине будет?
რად
Да
რად
Это просто выдача админских прав этому твоему юзеру
რად
Потому и говорю не гонять на раб. кластере
𝒦𝒶𝓁𝒶𝓎⛩
cannot create resource "clusterrolebindings" in API group
რად
Ну вот, все равно прав нет
 Konstantin
я уже боюсь его делать) Это только на моей машине будет?
https://kubernetes.io/docs/reference/kubectl/cheatsheet/#kubectl-context-and-configuration
𝒦𝒶𝓁𝒶𝓎⛩
apiVersion: v1
clusters:
- cluster:
certificate-authority-data: DATA+OMITTED
server: server-blablabl
name: production
- cluster:
certificate-authority-data: DATA+OMITTED
server: server-blablabl
name: staging
contexts:
- context:
cluster: production
namespace: test
user: test-production
name: kubernetes-admin@production
- context:
cluster: staging
namespace: test
user: test-user
name: kubernetes-admin@staging
current-context: kubernetes-admin@staging
kind: Config
preferences: {}
users:
- name:
რად
𝒦𝒶𝓁𝒶𝓎⛩
дальше токены идут
რად
В общем у тебя в ~/.kube/config minikube должен был создать нормальные креды для доступа к миникубовскому кластеру
𝒦𝒶𝓁𝒶𝓎⛩
я не вижц миникуба почемуто
რად
Почему так произошло, сложно сказать, в таких условиях долго копать придется
𝒦𝒶𝓁𝒶𝓎⛩
попробую пересоздать перемещу пока свои конфиги
რად
Погугли issues на гитхабе и почитай что такое kube config
რად
Но да, проще всего будет пересоздать
რად
И если ты только поковыряться собираешься, то просто выруби вообще RBAC в кластере
რად
Наверняка у миникуба для этого флаг есть
𝒦𝒶𝓁𝒶𝓎⛩
Спасибо радуете, своими советами. Обычно валят в других каналах ретарическими вопросами
𝒦𝒶𝓁𝒶𝓎⛩
Лучшие
 Lucky SB
Спасибо радуете, своими советами. Обычно валят в других каналах ретарическими вопросами
https://kubernetes.io/docs/setup/learning-environment/minikube/#interacting-with-your-cluster
Anonymous
как сделать force upgrade
Anonymous
да у меня пишет, что такой сервис уже сущетсвует
Anonymous
и нужно сделать update
NM
rolling-update ?
Anonymous
release rnd-qa-stitching_storage failed: services "stitching-storage" already exists сейчас вот так пишет
NM
Через helm что нибудь ставил ?
Салтыдык
С телефона, нет возможности набрать helm upgrade --help
 dzmitry
Привет, подскажите по поводу grafana: в dashboard "Kubernetes Deployment Statefulset Daemonset metrics
" есть метрики Disk Usage - это относится к PV?
 Konstantin
А подскажите как готовить авторизацию в k8s? У меня настроена аутентификация через OpenID, так что кластер знает про id юзера и группы, в которых он состоит. Допустим я хочу разделить пользователей по неймспейсам, неймспейс на проект. Вот я добавляю юзера в openid в новую группу, а где тот механизм, который создаст новый неймспейс, роли и rolebindings в нём?
 Artyom
kvaps на хабр писал про keycloak
Artyom
Зачётная статья
Artyom
Гугли "Прикручиваем LDAP-авторизацию к Kubernetes"
Konstantin
там руками создаётся rolebinding
Konstantin
Пока придумал взять CI, и попросить пользователей перед тем, как пользоваться kubectl, закинуть id_token в джобу, которая создаст нужные ресурсы. Либо хранить какое-либо описание пользователей и их прав в репозитории, и по сути через pull request авторизовывать новых, с прогонкой джобы после мёржа в мастер. Но это не очень похоже на автоматизацию.
 🇷🇺 Vladimir
хм. а как я оказался не в группе
🇷🇺 Vladimir
рандомные расстрелы чтоли
 Siarhei
G72K
https://longhorn.io/ передали в CNCF хоспис
Georgy
Кто нибудь подскажет, есть ли возможность слушать lifecycle события в Kubernetes кластере? К примеру о том, что такой то под был создан/уничтожен и тд
G72K
Кто нибудь подскажет, есть ли возможность слушать lifecycle события в Kubernetes кластере? К примеру о том, что такой то под был создан/уничтожен и тд
Да, WATCH запрос. Можно увидеть пример через kubectl get pod -w --v=8
Georgy
Да, WATCH запрос. Можно увидеть пример через kubectl get pod -w --v=8
Я имею ввиду, можно ли создать такой под, который будет получать сообщения о ВСЕХ событиях в кластере.
 Mikhail [azalio]
Я имею ввиду, можно ли создать такой под, который будет получать сообщения о ВСЕХ событиях в кластере.
Посмотрите как сделаны event exporters для Прометея
Georgy
Посмотрите как сделаны event exporters для Прометея
Спасибо! Да, придется.
Думал может где простым языком описано :)
Yevhenii
Кто нибудь подскажет, есть ли возможность слушать lifecycle события в Kubernetes кластере? К примеру о том, что такой то под был создан/уничтожен и тд
Вам https://github.com/heptiolabs/eventrouter надо
Салтыдык
Извините, у меня тут ночной вопрос про хельм, который не отпускает меня спать.
У меня есть helm-чарт, там NodePort-сервис с одним портом.
При передеплое чарта, helm ругается на:
Error: release install failed: release rsync-srv failed: Service "rsync-srv" is invalid: spec.ports[0].nodePort: Invalid value: 873: provided port is already allocated
Это какой-то pre-install хук на выпиливание надо вкинуть или как это лечить?
Я просто не очень шарю в специфике хельма.
 Виктор
удали релиз и создай еще раз, потом еще раз попробуй передеплоить, не должно быть проблем
Салтыдык
Да, спасибо. Всё заработало.
Вроде ничего не менял, ну да ладно.
 𝚔𝚟𝚊𝚙𝚜
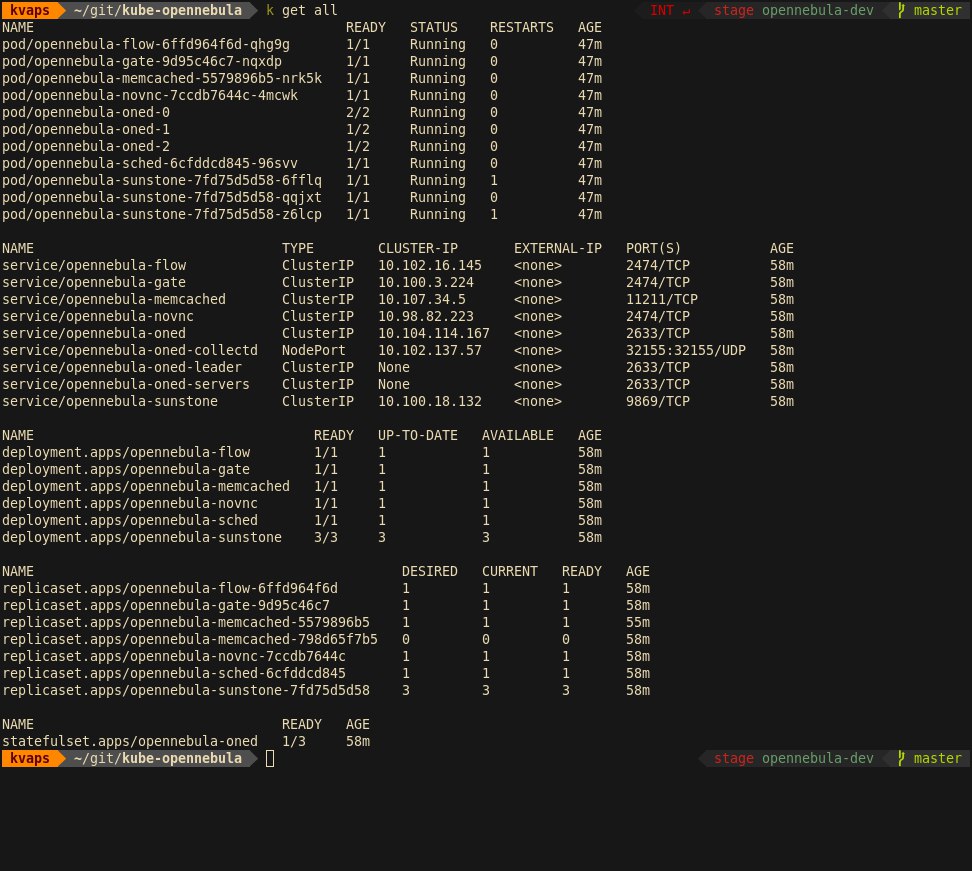
Зафигачил хелм-чарт для деплоя OpenNebula в полностью автоматическом режиме: с RAFT'ом, автообновлением и автофейловером.
https://github.com/kvaps/kube-opennebula
𝚔𝚟𝚊𝚙𝚜
 Alex
> get all
А че так можно было?
 Pavel
all покажет pod deployment, replica, service, daemon. Остальные не поакажет (без шаманств.)
 Tadas
 Andrey
Зафигачил хелм-чарт для деплоя OpenNebula в полностью автоматическом режиме: с RAFT'ом, автообновлением и автофейловером.
https://github.com/kvaps/kube-opennebula
Так можно и составить многоножку из кластеров. Контролплейн для небьюлы в одних кубенях, на хостах вторые кубеня, в которых контролплейн для второй инсталляции небьюлы, на хостах которой третьи кубеня...
Sergey
Sergey
Sergey
Хотел ещё написать про мерзость или dc/os, но это, даже, для меня слишком
 Solyar
Откуда?
 Ẏoxi
Solyar
Lucky SB
Эти радости нужны на двух-трех-пяти входящих узлах балансировщика. Если у вас такие объемы входящих запросов, что нужны сотни входящих то наверняка есть bgp, куча кластеров на всех материках и вы можете эффективно использовать anycast
 Slach
у меня вопрос
вот раскатил я через kubeadm
multi-master кластер
на 3 etcd ноды
потом взял и все погасил
потом стартую
первый мастер
и в crictl logs
вижу что etcd кластер сволочь такая
не видит двух других пиров
2019-11-02 12:00:47.089793 E | etcdserver: publish error: etcdserver: request timed out
2019-11-02 12:00:48.149726 W | rafthttp: health check for peer 2b3b91eb6c1a0477 could not connect: dial tcp 10.4.2.11:2380: i/o timeout (prober "ROUND_TRIPPER_SNAPSHOT")
2019-11-02 12:00:48.150009 W | rafthttp: health check for peer 96b21c1423dcf8f4 could not connect: dial tcp 10.4.2.12:2380: i/o timeout (prober "ROUND_TRIPPER_RAFT_MESSAGE")
и при этом сам не хочет становиться мастером
2019-11-02 12:00:50.908469 I | raft: 83c7289479041e65 received MsgVoteResp from 83c7289479041e65 at term 861
2019-11-02 12:00:50.908495 I | raft: 83c7289479041e65 [logterm: 265, index: 407362] sent MsgVote request to 2b3b91eb6c1a0477 at term 861
2019-11-02 12:00:50.908520 I | raft: 83c7289479041e65 [logterm: 265, index: 407362] sent MsgVote request to 96b21c1423dcf8f4 at term 861
861 попытка...
вроде ничего такого страшного не ставил в настройках etcd чтобы он так долго мастера электил
подскажите в какую сторону копать?
 Vadim
2 работающих мастера наверное должно быть разве нет?
Vadim
чтоб кворум был