 Lucky SB


куб-прокси не создал ни одного правила
 Nik
Всем привет, попробую еще раз.
Собираю кластер (и на 1.15 и на 1.14.3 одно и тоже), и часть подов (деплойменты) не создаются с ошибкой
Warning FailedCreatePodSandBox 1s kubelet, k8s-test-master-01 Failed create pod sandbox: rpc error: code = Unknown desc = failed to setup network for sandbox "ee6711eb7110b5ff545ce6323466605d1323775bab8206af91d49d87b365e133": error getting ClusterInformation: Get https://[192.168.128.1]:443/apis/crd.projectcalico.org/v1/clusterinformations/default: x509: certificate signed by unknown authority (possibly because of "crypto/rsa: verification error" while trying to verify candidate authority certificate "kubernetes”
кстати на первой попытке чистой сборки тестового кластера с containerd заканчивались так же
Lucky SB
не он же тебе пишет что не может по адресу сервиса до апи доступчаться
Nik
не он же тебе пишет что не может по адресу сервиса до апи доступчаться
да. может на кри надо и сетку как то иначе подкидывать в кублет?
Nik
или я чего то не догоняю?
Nik
можно погасить кублет, убить все правила, ребутнуть, поднимется кубпрокси и пропишет их все заново
Nik
не?
Lucky SB
попробовать ен помешает. я на кри не переезжал - нимчего не могу сказать
Nik
а на чистом кри стартовал новый кластер?
Lucky SB
и на чистом тоже никогда. я приверженец - работает не трогай
Nik
а я криворук
skipping pod synchronization - container runtime is down
Nik
как тогда кублет вообще поднялся и махнул Ready я не понимаю
 gani
Почему для NFS размер 1Mi?
apiVersion: v1
kind: PersistentVolume
metadata:
name: nfs1
spec:
capacity:
storage: 1Mi
accessModes:
- ReadWriteMany
nfs:
server: 192.168.1.1
path: “/“
Lucky SB
потому что пример ?
gani
В нескольких примерах так, и у кого-то в проде видел так прописано во всех NFS PV
Lucky SB
Для NFS квоты не реализованы. ограничения на размер не работают.
этот сторадж сайз только pvc использует, когда выбирает какой из pv себе забрать
Nik
народ, кто поднимал cri(containerd)-вы что то кроме параметров кубелета прописывали?
gani
gani
Если PVC просит 100 гигов, а в наличии только PV с 200 гигами, то он его заберет?
 Валентин
народ, кто поднимал cri(containerd)-вы что то кроме параметров кубелета прописывали?
Кубелету путь до сокета и cni - все
Nik
вот я так же вроде
Nik
но все веселее
Nik
приехал демонсет с каликой. явно через кубеапи вижу логи и в ps на хосте его вижу
Nik
но при этом
Error syncing pod 5408a3a7-e65b-4bdc-ac02-2d0682abe1cf ("kfo-log-router-zq4kx_fluentd-operator(5408a3a7-e65b-4bdc-ac02-2d0682abe1cf)"), skipping: failed to "CreatePodSandbox" for "kfo-log-router-zq4kx_fluentd-operator(5408a3a7-e65b-4bdc-ac02-2d0682abe1cf)" with CreatePodSandboxError: "CreatePodSandbox for pod \"kfo-log-router-zq4kx_fluentd-operator(5408a3a7-e65b-4bdc-ac02-2d0682abe1cf)\" failed: rpc error: code = Unknown desc = failed to setup network for sandbox \"fb9606da945c892c0e808d4c71b37c4d85413540ee5be0a2675feeca989c35e7\": error getting ClusterInformation: Get https://[10.96.0.1]:443/apis/crd.projectcalico.org/v1/clusterinformations/default: Service Unavailable"
 Dmytro
Чтобы я например зашел в контейнер и посмотрел на конфиги coredns, который мне прод кладет
kubectl debug и вперед. В 1.16 нативно включенным фича гейтом, иначе https://github.com/aylei/kubectl-debug
Валентин
приехал демонсет с каликой. явно через кубеапи вижу логи и в ps на хосте его вижу
Вот я, опасаясь проблем курицы и яйца (а лог похож на это - нет сети, потому что нет доступа до апи куба, а доступа нет - потому что нет сети) cni не в контейнере юзаю, все на хосте
Nik
Вот я, опасаясь проблем курицы и яйца (а лог похож на это - нет сети, потому что нет доступа до апи куба, а доступа нет - потому что нет сети) cni не в контейнере юзаю, все на хосте
в светлом будущем будет sdn каокнить внешний с cni. а пока мне от него не слезть.
Nik
но вообще очень правильная мысль
Dmytro
Nik
но при этом под с сеткой поднялся же
Nik
да и интерфейсы на хостовой такчке тоже
 რად
почему бы да - лимиты не выставить на pod ?
Объяснил же выше. Зачем мне что-то лимитить если еще в рамках верхних лимитов дофига ресурсов?
 Andrey
Объяснил же выше. Зачем мне что-то лимитить если еще в рамках верхних лимитов дофига ресурсов?
Есть ещё границы конкретной ноды. Плюс, а зачем не лимитить, если больше ресурсов поду и не надо?
Andrey
+ qos
Andrey
+ автоскейлинг, если не бареметал
Dmytro
Да, есть такой вариант, но у нас куча кластеров они достаточно статические, и куча helm чартов где нужно селекторы вписывать, пока хотели обойтись меньшей кровью
так вроде бы можно неймспейсы прибивать на нодпулы - не надо трогать хелм чарты и манифесты вообще
რად
Есть ещё границы конкретной ноды. Плюс, а зачем не лимитить, если больше ресурсов поду и не надо?
Как это "больше и не надо"? Никогда не знаешь сколько ему нужно будет
რად
так вроде бы можно неймспейсы прибивать на нодпулы - не надо трогать хелм чарты и манифесты вообще
Примерно к этому и пришли
Andrey
Как это "больше и не надо"? Никогда не знаешь сколько ему нужно будет
Есть метрики, есть исторические данные по ним. С чего и не знать бы.
რად
Есть метрики, есть исторические данные по ним. С чего и не знать бы.
В общем. Есть верхний лимит, за который неймспейс вылезать не должен. Зачем мне заморачиваться с менеджментом лимитов для каждой отдельной поды? Задача простая и уже пришли к решению простому. А лимитить каждую поду под максимум никаких ресурсов не напасешься, так еще и соседние неймспейсы аффектит
Andrey
В общем. Есть верхний лимит, за который неймспейс вылезать не должен. Зачем мне заморачиваться с менеджментом лимитов для каждой отдельной поды? Задача простая и уже пришли к решению простому. А лимитить каждую поду под максимум никаких ресурсов не напасешься, так еще и соседние неймспейсы аффектит
Ага, и задача простая, и решение простое. До первых приколов с троттлингом со стороны CFS и совершенно непредсказуемым eviction.
Andrey
Или его отсутствием. Тут как с подбором параметров к kubelet повезет
Dmytro
Есть ещё границы конкретной ноды. Плюс, а зачем не лимитить, если больше ресурсов поду и не надо?
там проблема с CFS квотами и остановками
რად
Решение - лок неймспейса на опр. ноды через лейблы. Выход за эти лимиты для нас приемлем, т.к. разрабы закзывают эти лимиты.
რად
На этих нодах только они крутятся и больше никто
რად
Тык я об этом и твержу сколько и к этому и пришли выше сегодня днем. Но все равно спасибо за проявленное внимание
Cholovik
Кстати я тут недавно задавал вопрос про СFS троттлинг и в итоге разобрался.
И выходит так что при большом количестве cgroups все балансируется используя cpu.shares для выделения процессорного времени, а лимиты уже регулируют сколько вы из этой части сможете заиспользовать.
Это я сейчас говорю про систему под какой-то более менее нагрузкой, на свободной все чуть чуть иначе.
И по сути если у нас реквест 10m то у нас будет “вес” cpu.shares=10 и мы будем по умолчанию получать намного меньше вычислитетльных ресурсов чем наш сосед.
И если у нас лимит 500m то мы конечно сможем получить до половины от ядра, но на деле мы будет получать и так мало из-за развесовки, и из этого мало мы еще и сможем использовать только часть, а именно (по дефолту период 100ms, и до версии куба 1.12 это хардкод) всего 50ms из 100ms (т.к. 500m в кубернетисе в итоге превратятся в cpu.cfs_quota_us=50000 при cpu.cfs_period_us=100000) выделенного процессорного времени, а все остальное время будет троттлится
Если кому-то интересно могу постараться и оформить это все в пост, возможно меня кто-то поправит или сможет помочь более глубокими знаниями при вычитке
Или может кто-то сможет со мной на днях пообщаться 1 на 1 у меня есть вопросы чтобы собрать всю картину
Dmytro
https://www.youtube.com/watch?v=4QyecOoPsGU&feature=youtu.be&t=780
Dmytro
плюс то что эти кубернетовские m в cpu.shares конвернтируются не очень прозрачно
Cholovik
там еще от периода зависит
да, я про добавил только что, до версии 1.12 там хардкод.
Я пересмотрел много крутых докладов и постов, но ни в одном не нашел явного упоминания что под нагрузкой лимиты превращаются в средство балансирования намного меньшем количеством ресурсов чем ожидается после чтения официальной документации и прочих гайдов.
Это дейтсвительно кардианально изменило мою картину.
Dmytro
где-то была подробная статья на kubernetes.io, мы с @zuzzas углублялись в этот вопрос тут в чате с полгода назад
 Игорь
Вот я, опасаясь проблем курицы и яйца (а лог похож на это - нет сети, потому что нет доступа до апи куба, а доступа нет - потому что нет сети) cni не в контейнере юзаю, все на хосте
а разве в апи куба доступ через CNI? аписервер же с hostNetwork: true запускается
 Andrey
Кстати я тут недавно задавал вопрос про СFS троттлинг и в итоге разобрался.
И выходит так что при большом количестве cgroups все балансируется используя cpu.shares для выделения процессорного времени, а лимиты уже регулируют сколько вы из этой части сможете заиспользовать.
Это я сейчас говорю про систему под какой-то более менее нагрузкой, на свободной все чуть чуть иначе.
И по сути если у нас реквест 10m то у нас будет “вес” cpu.shares=10 и мы будем по умолчанию получать намного меньше вычислитетльных ресурсов чем наш сосед.
И если у нас лимит 500m то мы конечно сможем получить до половины от ядра, но на деле мы будет получать и так мало из-за развесовки, и из этого мало мы еще и сможем использовать только часть, а именно (по дефолту период 100ms, и до версии куба 1.12 это хардкод) всего 50ms из 100ms (т.к. 500m в кубернетисе в итоге превратятся в cpu.cfs_quota_us=50000 при cpu.cfs_period_us=100000) выделенного процессорного времени, а все остальное время будет троттлится
Если кому-то интересно могу постараться и оформить это все в пост, возможно меня кто-то поправит или сможет помочь более глубокими знаниями при вычитке
Или может кто-то сможет со мной на днях пообщаться 1 на 1 у меня есть вопросы чтобы собрать всю картину
У нас доклад недавно был, который я помогал составлять. Там про это тоже есть ближе к середине. Посмотри, может, найдёшь ещё что интересное.
https://www.youtube.com/watch?v=10ZR-fbyuSY
Валентин
а разве в апи куба доступ через CNI? аписервер же с hostNetwork: true запускается
Этого уж я не знаю - у меня он запускается без контейнера :)
Cholovik
У нас доклад недавно был, который я помогал составлять. Там про это тоже есть ближе к середине. Посмотри, может, найдёшь ещё что интересное.
https://www.youtube.com/watch?v=10ZR-fbyuSY
Спасибо.
У меня остался последние 2 вопроса которые я пока не могу подтвердить ссылкой на документацию и в чем я хочу убедиться чтобы закрыть вопрос.
1. Прав ли я что при нагрузке лимиты будут выступать по сути лишь ограничителями времени из того что выделенно в соответствии с весами
2. Иногда все-же будет троттлиться т.к. вычислительные ресурсы опять же выдаются в разных пропорциях (Хотя я пока не нашел в документации шедулера явного указания на это, там написано что троттлинг будет только если есть квоты, но при квоте 100ms за период в 100ms его быть не должно, но он немного есть, так что это пока предположение)
Andrey
Спасибо.
У меня остался последние 2 вопроса которые я пока не могу подтвердить ссылкой на документацию и в чем я хочу убедиться чтобы закрыть вопрос.
1. Прав ли я что при нагрузке лимиты будут выступать по сути лишь ограничителями времени из того что выделенно в соответствии с весами
2. Иногда все-же будет троттлиться т.к. вычислительные ресурсы опять же выдаются в разных пропорциях (Хотя я пока не нашел в документации шедулера явного указания на это, там написано что троттлинг будет только если есть квоты, но при квоте 100ms за период в 100ms его быть не должно, но он немного есть, так что это пока предположение)
1. Да;
2. Да.
Я не готов, к сожалению, конкретные ссылки на книги и статьи дать сейчас, потому что год назад изучал это.
Cholovik
1. Да;
2. Да.
Я не готов, к сожалению, конкретные ссылки на книги и статьи дать сейчас, потому что год назад изучал это.
Ссылки не нужны, я найду (хотя может помните про что примерно было?), просто нужна была консультация того кто в этом разобрался.
И найти такого человека оказалось довольно сложно.
И это приводит к пониманию того что сейчас где-то очень много людей не понимают почему у них те или иные проблемы
Andrey
Ссылки не нужны, я найду (хотя может помните про что примерно было?), просто нужна была консультация того кто в этом разобрался.
И найти такого человека оказалось довольно сложно.
И это приводит к пониманию того что сейчас где-то очень много людей не понимают почему у них те или иные проблемы
>И это приводит к пониманию того что сейчас где-то очень много людей не понимают почему у них те или иные проблемы
Всё так. Поэтому и родилась идея того доклада.
Yuriy 🐼
Привет, кто нибудь юзает Reloader?
Dmytro
Спасибо.
У меня остался последние 2 вопроса которые я пока не могу подтвердить ссылкой на документацию и в чем я хочу убедиться чтобы закрыть вопрос.
1. Прав ли я что при нагрузке лимиты будут выступать по сути лишь ограничителями времени из того что выделенно в соответствии с весами
2. Иногда все-же будет троттлиться т.к. вычислительные ресурсы опять же выдаются в разных пропорциях (Хотя я пока не нашел в документации шедулера явного указания на это, там написано что троттлинг будет только если есть квоты, но при квоте 100ms за период в 100ms его быть не должно, но он немного есть, так что это пока предположение)
кроме теории там еще была пачка багов в кубере (когда для requests=limits int когда прибивается под на конкретные ядра все равно был включе CFS) была еще пачка багов в ядре линукса https://github.com/kubernetes/kubernetes/issues/67577
 Евгений
Dmytro
и нужна версия ядра 5.4 где все они зафикшены наконец (все известные на данный момент)
Yuriy 🐼
Не слышал о его существовании, застарил
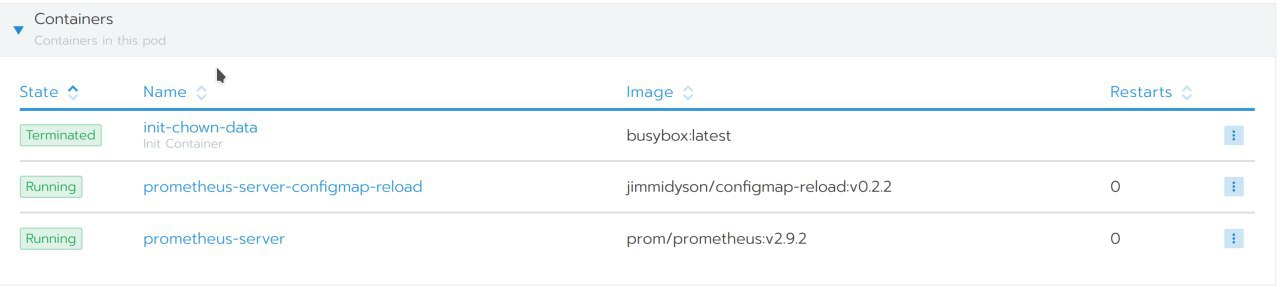
Нужна тулза чтобы при изменении configmaps сервисы которые его юзают переделоились, нету helm
 George
сайдкарт подсаживаешь и все ок
Dmytro
Cholovik
кроме теории там еще была пачка багов в кубере (когда для requests=limits int когда прибивается под на конкретные ядра все равно был включе CFS) была еще пачка багов в ядре линукса https://github.com/kubernetes/kubernetes/issues/67577
Начинал с это ишьи 2 недели назад, и тогда у меня были мысли - “О, нашел бэкпорт даже, сейчас просто ядро обновлю и заживем”
Спустя неделю я весь выходной потратил чтобы полностью погрузиться во все это с экспериментами и прочим.
Cholovik
2 пункт - я выше кидал ссылку на видео, там объясняется этот момент
Да, спасибо, открыл видео но понял что уже видел этот доклад но видео было с другой конференции, вроде highload++
George
 George
типа так
Dmytro
Да, спасибо, открыл видео но понял что уже видел этот доклад но видео было с другой конференции, вроде highload++
да Хенниг сто раз рассказывал про это - в 17-18 году была хайповая тема, я был на каком-то митапе где он это рассказывал в очередной раз
George
Скинь плиз репо
ну, это был типичный хельм чарт типичного прометеуса 🤷♂️ там никто ничего не инжектит, просто изначально пишут шаблон сервиса так, чтобы была перезагрузка при изменении конфиг мапы