 inqfen


Вообще, в доках прометеуса написано, что
Some third-party software exposes metrics in the Prometheus format, so no separate exporters are needed:
inqfen
спс, попробую его
 engelbart
А научите плиз. как мне в k8s в google cloud iowait/iops куда нибудь в прометей поснимать
 Maxim
привет!
вопрос к пользователям EKS:
если деплоить кластер через CF стек, то только юзер, через которого производился деплой будет иметь доступ в кластер через kubectl? можно ли это изменить? деплоить кластер через IAM роль и все равно иметь доступ в кластер?
Maxim
что-то доки этот момент умалчивают)
 Vlad
драсте)
нужен совет от мудрецов чата
есть задача на кластере развернуть:
1) namespace+ set of CRD's
2) wait until all created
3) run shellscript using above metadata
4)catch any error
5) finally delete all CRD
---------------
возможно ли это провернуть через kubernetes jobs?
или нужна какая то дополнительная обертка, чтобы потом протащить это в jobs?
или вообще нет смысла такое пилить ? если так, то какие kube-native средства могут подойти?
p.s. jenkins и тд не предлагать, это и сами умеем)
 Stefan
господа, кто юзал nats-operator?
сделал по доке, задеплоился успешно
порт по дефолту по доке 8080
дополнительно создал для него сертификат от LE + ingress + service
почему когда я перехожу по домену, то получаю 404 ошибку? техлид пробовал подключиться через тестовый скрипт из офиса, пишет что не может подключиться удаленно(connection refused)
что я упускаю?(
че никто не юзал и не экспоузил наружу nats cluster?((
 Dmitrii
Vlad
bash, kubectl apply и kubectl delete?
Именно это я и написал и именно это я хочу запихнуть в jobs
engelbart
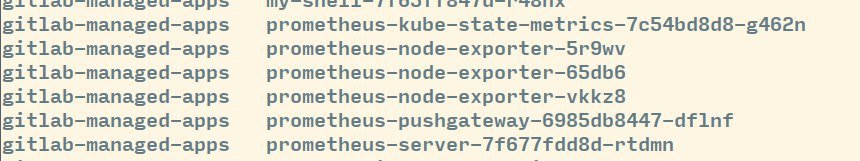
Мучаюсь тутс с node-exporter
поставил его и prom в кластер.
Вроде б все ок.
Но, пром не собирает данные когда прописываю анотации
Annotations: prometheus.io/port: 9100
prometheus.io/scrape: true
А когда в prom config руками добавляю вот такое:
scrape_configs:
- job_name: nodes
static_configs:
- targets:
- prometheus-node-exporter:9100`
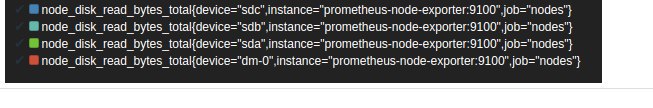
начинает собирать, но смешивает в кучу с трех экспортеров данные
как жить
engelbart
 engelbart
Да там один инстанс кажется когда через сервис
engelbart
что то неправильно
Stefan
Да там один инстанс кажется когда через сервис
https://github.com/kubernetes/kubernetes/tree/master/cluster/addons/prometheus
попробуй отсюда взять настройки к нодэкспортеру и прометею, брал отсюда однажды - работает по сей день
engelbart
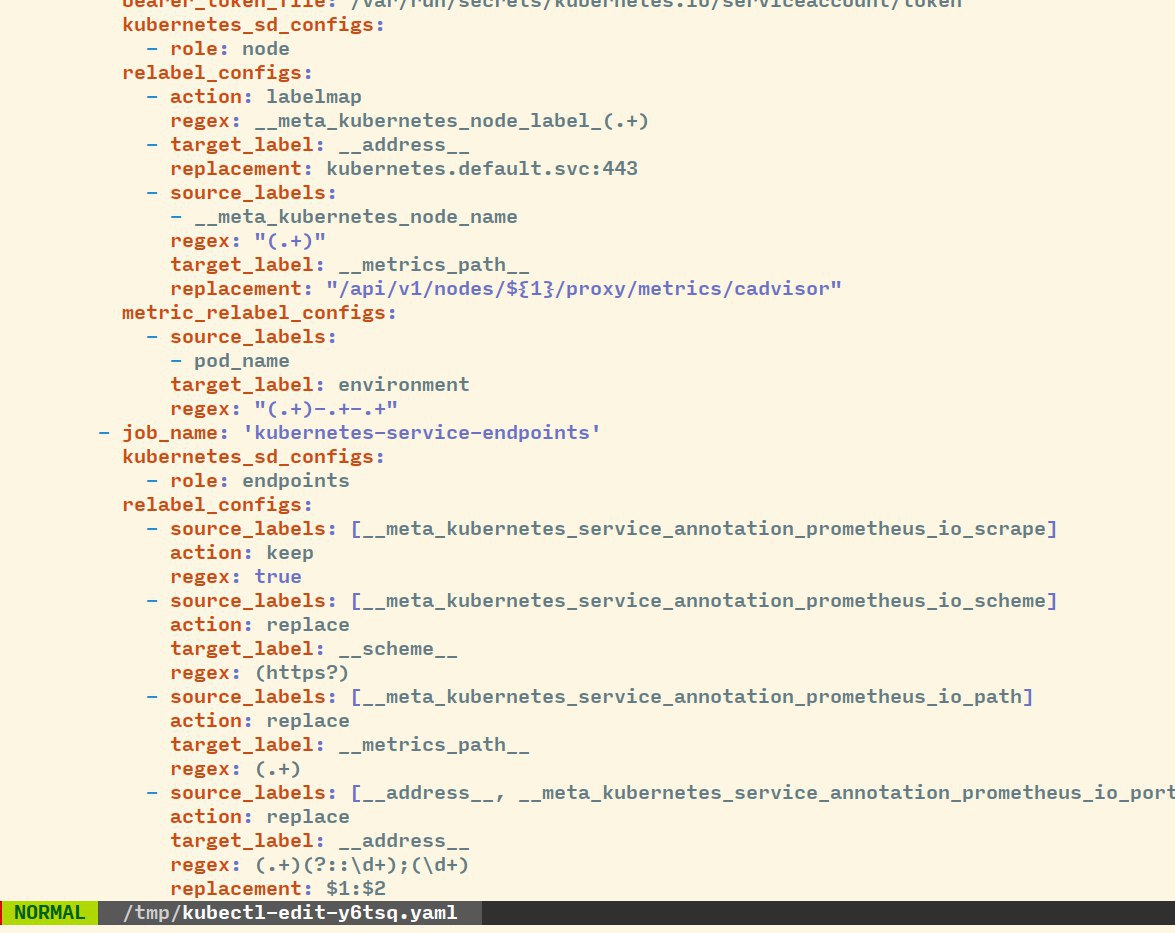
Похоже вот тут вся магия
https://github.com/kubernetes/kubernetes/blob/master/cluster/addons/prometheus/prometheus-configmap.yaml
engelbart
 engelbart
это я edit config map дернул
Stefan
возьми от туда примеры и предалай под свое, учитывая лейблы и всё
engelbart
Я взял вот этот
https://github.com/helm/charts/tree/master/stable/prometheus
engelbart
Тоже надеюсь люди пользуются
engelbart
Скорее я аннтоации как то не так пишу чем чарт сломанный
 Vadim
Проверь что пром имеет доступ к твоему неймспейсу
engelbart
он в том же namespace что и всё остальное
engelbart
 Stefan
я через хельм если и ставлю, то через helm template и удаляю/переписываю на свой лад
engelbart
блин в какую то мелочь уперся
engelbart
и prom сам рабочий и может собирать
engelbart
и экспортеры ок
engelbart
но вот обнаружение не работает
Vadim
он в том же namespace что и всё остальное
Остальное барахло или те сервисы которые пром успешно скрейпит?
engelbart
через аннотации не скрейпит ничего. Но я к тому что там все в одном namespace
engelbart
ох, кажется победил
engelbart
Вписал вот это https://github.com/coreos/kube-prometheus/pull/16#issuecomment-424318647
G72K
А кто как решает задачу автоматического удаления ресурсов кубера после удаления ветки в репе?
Настроил так, чтобы для каждого бранча просиходил деплой ресурсов в кубер, где в имя ресурса добавляется имя втеки. Оно вроде как удобно, но со временем в кубере очень много деплойментов, сервисов, инргесов и т.д. И вот думаю что с ними делать, и интересно кто как решает такую проблему.
Думал банально ловить хуки с репозитория и запускать задачу на удаление. Сейчас это сделано у меня через Jenkins (multi branch pipeline), может он умеет понимать когда бранч удалился и запускать в соответствии с этим действие?
Если гитлаб, там есть environment stop жоба которая при удалении ветки вызывается если из этой ветки environment создавался
Alexander
привет!
вопрос к пользователям EKS:
если деплоить кластер через CF стек, то только юзер, через которого производился деплой будет иметь доступ в кластер через kubectl? можно ли это изменить? деплоить кластер через IAM роль и все равно иметь доступ в кластер?
В EKS есть мапа aws-auth в namespace kube-system. Она отображает доступ амазоновских принципалов на роли в кубере. Добавляете туда новых юзеров и они будут ходить через kubectl
https://docs.aws.amazon.com/eks/latest/userguide/add-user-role.html
 Aleksey
Всем привет! Поднимаю ElasticSearch внутри кластеров, софтина требует поднять ulimit'ы. Как это правильно сделать: увеличить лимиты в хост-системе или внутри контейнера?
 Terry
Добрый день! Может быть может кто поделиться своим опытом в развертке сложного кластера K8S в корпоративном сегменте без облаков. Кейс состоит в том, что уже есть 3 изолированных сети (ищолированы они логически) Dev, Test, Prod. Внутри каждого необходимо развернуть отказоустойчивый кластер с 3 мастер нодами и условно не ограниченным колличеством slave нод. При этом хотелось бы иметь одну точку входа и в ней развернуть Pipeline. При этом каждый отказоустойчивой кластер должен восприниматься как единое облак с логичеким дроблением на те же stage для развертки (Dev, Test, Prod) и соответсвовать уже имеющейся изолированной сети
Mikhail
Всем привет! Поднимаю ElasticSearch внутри кластеров, софтина требует поднять ulimit'ы. Как это правильно сделать: увеличить лимиты в хост-системе или внутри контейнера?
на нодах подними
sysctl -w vm.max_map_count=262144
 Vladimir
на нодах подними
sysctl -w vm.max_map_count=262144
А не правильнее ли делать это через init контейнеры?
Aleksey
А не правильнее ли делать это через init контейнеры?
Не затруднит пояснить что подразумевается под init-контейнерами?
Vladimir
https://kubernetes.io/docs/concepts/workloads/pods/init-containers/
Vladimir
https://github.com/opendistro-for-elasticsearch/community/blob/master/open-distro-elasticsearch-kubernetes/elasticsearch/40-es-master-deploy.yml#L50
вот пример для эластики с open distro
Konstantin
Добрый день! Может быть может кто поделиться своим опытом в развертке сложного кластера K8S в корпоративном сегменте без облаков. Кейс состоит в том, что уже есть 3 изолированных сети (ищолированы они логически) Dev, Test, Prod. Внутри каждого необходимо развернуть отказоустойчивый кластер с 3 мастер нодами и условно не ограниченным колличеством slave нод. При этом хотелось бы иметь одну точку входа и в ней развернуть Pipeline. При этом каждый отказоустойчивой кластер должен восприниматься как единое облак с логичеким дроблением на те же stage для развертки (Dev, Test, Prod) и соответсвовать уже имеющейся изолированной сети
Три сети, три кластера. В четвёртой pipeline, в нем переключай контексты . Не вижу проблемы
Terry
Три сети, три кластера. В четвёртой pipeline, в нем переключай контексты . Не вижу проблемы
В четвортой где находится pipeline, какие должны быть роли у сервера, чтобы управлять master нодами внутри сред
Konstantin
Pipeline будет выступать клиентом для кластеров в этом случае. Установи kubectl смерджи три конфига и переключай контексты kubectl —context=prod
Vadim
Всем привет! Поднимаю ElasticSearch внутри кластеров, софтина требует поднять ulimit'ы. Как это правильно сделать: увеличить лимиты в хост-системе или внутри контейнера?
вообще-вообще правильно поставить на ноды tuned оператор и рулить ими через CRD
Aleksey
вообще-вообще правильно поставить на ноды tuned оператор и рулить ими через CRD
Это религиозно-правильный путь Kubernetes?
Vadim
https://github.com/openshift/cluster-node-tuning-operator например, а то играть в игру "ну и какая сволочь через ssh или init container установила низкий ulimit" быстро надоест
Vadim
Это религиозно-правильный путь Kubernetes?
никакого пути в k8s на этот счет нет. Твои ноды ты и рули ими как хочешь
Konstantin
В четвортой где находится pipeline, какие должны быть роли у сервера, чтобы управлять master нодами внутри сред
Pipeline будет выступать клиентом для кластеров в этом случае. Установи kubectl смерджи три конфига и переключай контексты kubectl —context=prod
Terry
Pipeline будет выступать клиентом для кластеров в этом случае. Установи kubectl смерджи три конфига и переключай контексты kubectl —context=prod
То есть я правильно понимаю, я ставлю на кластер Pipeline Kubectl и через него добавляю остальные 3 кластера. У меня есть небольше сомнения по поводу того, что внутри каждого кластера будет по 3 мастера и также в кластере pipeline, правильно-ли это?
Konstantin
То есть я правильно понимаю, я ставлю на кластер Pipeline Kubectl и через него добавляю остальные 3 кластера. У меня есть небольше сомнения по поводу того, что внутри каждого кластера будет по 3 мастера и также в кластере pipeline, правильно-ли это?
Пайплайн не обезательно ставить в кластер, просто на виктуалках в четвертой сети. Если нужен HA кластера, то минимум по 3 мастера. Вопрос нужно ли тебе это в dev и тест
Terry
Пайплайн не обезательно ставить в кластер, просто на виктуалках в четвертой сети. Если нужен HA кластера, то минимум по 3 мастера. Вопрос нужно ли тебе это в dev и тест
Необходимо спроектировать сразу с учетом HA каждый отдельный кластер. Спасибо большое за ваш ответ, попробую сделать в 2 этапа с HA только в Prod, остальные с одним, а после уже все на HA перевести. Может ещё подскажите что лучше использовать из сетей для данного кейса, до этого в Kubernetes использовал только Calico, и по поводу распределенного файлового хранилища, активно использую GlusterFS, но с ним пару раз были серьёзные проблемы
Konstantin
Необходимо спроектировать сразу с учетом HA каждый отдельный кластер. Спасибо большое за ваш ответ, попробую сделать в 2 этапа с HA только в Prod, остальные с одним, а после уже все на HA перевести. Может ещё подскажите что лучше использовать из сетей для данного кейса, до этого в Kubernetes использовал только Calico, и по поводу распределенного файлового хранилища, активно использую GlusterFS, но с ним пару раз были серьёзные проблемы
Если вопрос про storage, то я использую rook https://rook.io/ ceph, nfs
Oleg
Ребят, кто-нибудь уже научился жить с одним мастером (+1etcd) на бареметал в проде?
Хочется кластер подешевле, и
есть мысль - остальные 2 Etcd инстанса крутить на воркер нодах, мастер же держать в виртуалке и её бэкапить/снапшотить.
Отвалился контрол плейн - заресторили.
Такое облако для бедных)
 Lucky SB
Вам не нужен кубернетес
Vadim
Ребят, кто-нибудь уже научился жить с одним мастером (+1etcd) на бареметал в проде?
Хочется кластер подешевле, и
есть мысль - остальные 2 Etcd инстанса крутить на воркер нодах, мастер же держать в виртуалке и её бэкапить/снапшотить.
Отвалился контрол плейн - заресторили.
Такое облако для бедных)
снапшотить всю VM наверное лишнее, достаточно etcd снапшота
Oleg
Печальбеда, но мы уже там с HA )Есть кейс, когда нужно подешевле - клиенту.
Oleg
снапшотить всю VM наверное лишнее, достаточно etcd снапшота
+ серты + манифесты
Такое уже сделали, но спасиб
Anonymous
Гайс, такая таска. Нужно сделать mount директории определённого размера. (Просто mount внутри контейнера), однако напрямую из контейнера "mount /dir_file /dir" сделать нельзя. Пытаюсь средствами yaml реализовать это на уровне кубера
volumeMounts:
- mountPath: /opt/little_storage
name: test-volume
volumes:
- name: test-volume
emptyDir: {}
Директория по итогу создается, но она не подхватывается как mount и не имеет ограничения на размер, есть идеи?
Alexander
А есть готовые инструменты, чтобы скалить группу pods(из разных deploy)?
Alexander
Ну кроме как мегапод делать соединив контейнеры
 Yury
Гайз, а при изменении ConfigMap переменные окружения, которые из нее сделаны сами не обновятся?
 Dmitry
Если выставить medium в Memory
Anonymous
Если выставить medium в Memory
type medium стоит. sizeLimit это синтаксис Pod'а или самого Volume ?
Dmitry
type medium стоит. sizeLimit это синтаксис Pod'а или самого Volume ?
emptyDir:
medium: "Memory"
sizeLimit: 1Gi
Dmitry
Я сам не пробовал, но в reference api эти поля есть
Alexander
Yury
Вроде обновятся
в доке явно сказано только что volume обновиться, а про env ничего не сказано. И похоже это ожидаемое поведение =(
Dmitry
ну по логике переменные окружения берутся из окружения в момент запуска процесса, то есть чтобы их поменять, нужно перезапустить процесс