 Andor


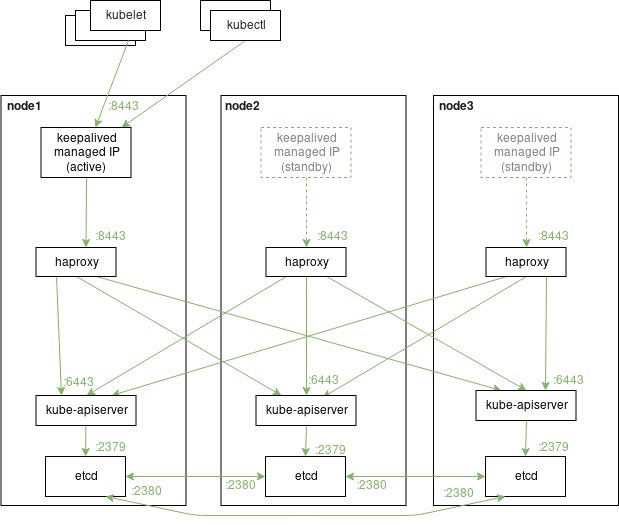
ну да, на этой схеме коннекты до аписервера имеют смысл, а всё что под ним - другая тема
 Artyom
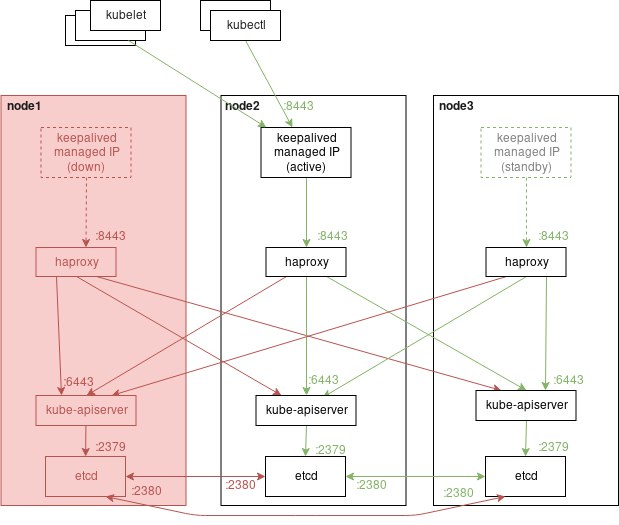
Решил схемку нарисовать, т.к. все равно коллегам объяснять еще.
О, спасибо! Оч наглядно вроде.
 Alex
инженерам ещё стоит качать навык "уметь продать решение", а не плакать, что их не слушают
это манагерам надо качать навык "умение слушать". Если меня не слушают - мне проще сменить работодателя
Artyom
Стоп, а етсд как-то отдельно резервировать для НА надо?
 𝚔𝚟𝚊𝚙𝚜
предлагаю етцд убрать из схемы :)
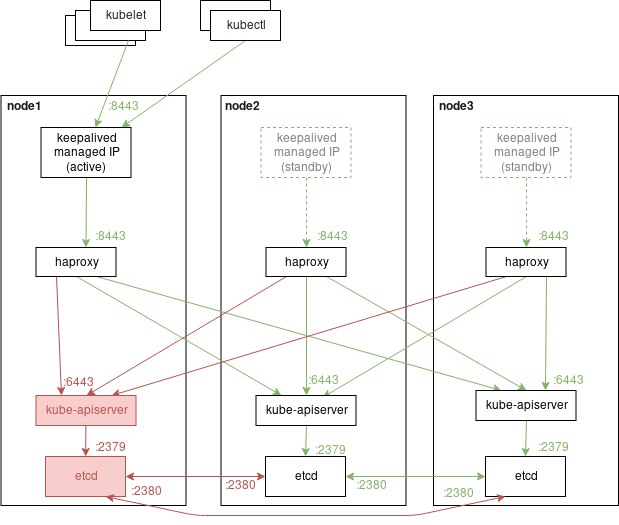
не, он важен, т.к. по умолчанию api-server стучится в 127.0.0.1:2379, то есть если etcd умрет, умрет и связанный с ним api-server
Alex
@Andorka я тоже
Andor
не, он важен, т.к. по умолчанию api-server стучится в 127.0.0.1:2379, то есть если etcd умрет, умрет и связанный с ним api-server
а в аписервер нельзя сказать что "вот тебе список адресов где должен быть етцд"?
Alex
Hi.
helm install --name postgres-cluster Chart.yaml --namespace database выдает Error: gzip: invalid header. не подскажете, в чем проблема?
helm repo update попробуй. Похоже, у тебя репа битая локальная
 Vadim
а в аписервер нельзя сказать что "вот тебе список адресов где должен быть етцд"?
можно, но тогда будет весело если два etcd помрет
Andor
ну у тебя и так будет весело, когда два из трёх умрут
Andor
у тебя и в локалхост не будет работать
Andor
но в данном случае это не принципиально конечно
 Rainbow
а в аписервер нельзя сказать что "вот тебе список адресов где должен быть етцд"?
звучит как кластер consul
Vadim
ну у тебя и так будет весело, когда два из трёх умрут
угу, но падение одного переживет, так что все же чуть-чуть лучше
Rainbow
неее
Rainbow
большое отличие - клиент consul стоит на каждом хосте, а не пару мастеров, куда никто не ходит
Andor
угу, но падение одного переживет, так что все же чуть-чуть лучше
ну в схеме "подключаемся в локалхост" один упавший етцд = один упавший аписервер, а в том случае все аписервера на месте будут
Vadim
ну в схеме "подключаемся в локалхост" один упавший етцд = один упавший аписервер, а в том случае все аписервера на месте будут
толку с них не будет - etcd развален
Andor
почему развален?
Rainbow
да они одинаковые
haproxy поэтому и используют в k8s, что нет чего-то вроде агента consul на каждом хосте
Andor
haproxy поэтому и используют в k8s, что нет чего-то вроде агента consul на каждом хосте
чо такое "агент консул"?
Andor
толку с них не будет - etcd развален
два етцд живы, один сдох, все аписервера знают про всех и все живы
Rainbow
это ничего не объясняет
идея consul, что он стоит на каждом хосте кластера приложений. В виде агента к которому хотят по localhost и 3-5 мастеров под consul кластер.
Andor
а ну то есть оно работает проксёй до других сервисочков
Andor
а-ля сервисмеш
Rainbow
Да, решает огромное количество проблем.
Rainbow
Аля да
Andor
только авторства хашимото&ко
Andor
они же относительно недавно это выкатили, до этого у них был шаблонизатор примерно как confd
Rainbow
что именно выкатили? такая схема была всегда
Andor
проксю вот эту
Andor
может не прав, не юзал консул никогда
Rainbow
может не прав, не юзал консул никогда
то consul connect, да прокся, но я про другое. Я в принципе про то, что у k8s нет service discovery нормального и появляются куча костылей в виде haproxy для apiserver на каждой ноде. Это в consul работает изначально by design
Andor
Да один хрен
 Михаил
Нездоровое это, когда ты хочешь персистентных данных в Kubernetes. Но почему-то армия таких не убывает, поэтому для них сделали stateful: https://cloud.google.com/kubernetes-engine/docs/how-to/stateful-apps
Vadim
> почему-то армия таких не убывает
действительно, очень странно
Vadim
два етцд живы, один сдох, все аписервера знают про всех и все живы
хмм, да, я совсем запутался. У нас disaster recovery и без локалхоста работал
𝚔𝚟𝚊𝚙𝚜
 𝚔𝚟𝚊𝚙𝚜
 𝚔𝚟𝚊𝚙𝚜
 𝚔𝚟𝚊𝚙𝚜
вот, теперь все правильно
𝚔𝚟𝚊𝚙𝚜
хмм, да, я совсем запутался. У нас disaster recovery и без локалхоста работал
Я описываю кейс stacked control plane как деплоит kubeadm по дефолту, он настраисает каждый api-server стучаться в локальный etcd
Vadim
𝚔𝚟𝚊𝚙𝚜
--etcd-servers=https://127.0.0.1:2379
𝚔𝚟𝚊𝚙𝚜
хотя в кейсе с external etcd nodes, по умолчанию туда заносятся все endpoints
https://kubernetes.io/docs/setup/independent/high-availability/#set-up-the-first-control-plane-node
 Andrey
хотя в кейсе с external etcd nodes, по умолчанию туда заносятся все endpoints
https://kubernetes.io/docs/setup/independent/high-availability/#set-up-the-first-control-plane-node
По какому принципу перебор идёт? Первый доступный?
 Игорь
да
Andrey
Интересно, не задумывался
Игорь
https://www.keepalived.org/doc/case_study_healthcheck.html
Andor
Это не ipvs
Andor
Это keepalived
Игорь
или я не так понял что-то
𝚔𝚟𝚊𝚙𝚜
ну понятно, хелсчеки в keepalived, балансировка в ipvs
беглый взгляд показал что да можно, но только там хелсчеки внешние по таймауту раз в n-секунд, haproxy в этом случае лучше, т.к. ни один коннект не потеряется
𝚔𝚟𝚊𝚙𝚜
По какому принципу перебор идёт? Первый доступный?
Там есть возможность использовать разные retry policies, но по умлочанию round-robin.
𝚔𝚟𝚊𝚙𝚜
Полагаю, потому kubeadm и настраивает api-server смотреть в локальный etcd, ибовсе равно запись не завершится пока не запишется хотябы на 2 из 3х etcd нод
Игорь
беглый взгляд показал что да можно, но только там хелсчеки внешние по таймауту раз в n-секунд, haproxy в этом случае лучше, т.к. ни один коннект не потеряется
понял, haproxy уберет упавший apiserver сразу после попытки коннекта, независимо от таймера
Andrey
 Roman
Ребят, привет. Подскажите пожалуйста с чем может быть связано. Участились случаи когда кубер убивает поды с такими причинами:
The node was low on resource: ephemeral-storage.
и в messages:
must evict pod(s) to reclaim ephe
meral-storage
На всех разделах свободно более 70% (порядка 60-80 gb), с инодами все нормально. Подскажите в какую сторону копать?
Рантайм - крио 🙁
𝚔𝚟𝚊𝚙𝚜
Ребят, привет. Подскажите пожалуйста с чем может быть связано. Участились случаи когда кубер убивает поды с такими причинами:
The node was low on resource: ephemeral-storage.
и в messages:
must evict pod(s) to reclaim ephe
meral-storage
На всех разделах свободно более 70% (порядка 60-80 gb), с инодами все нормально. Подскажите в какую сторону копать?
Рантайм - крио 🙁
По умолчанию кубелет проверяет относительные значения, емнип там как раз где-то 20% и есть
𝚔𝚟𝚊𝚙𝚜
А нет, там 10% и 15% для imagefs
𝚔𝚟𝚊𝚙𝚜
https://kubernetes.io/docs/tasks/administer-cluster/out-of-resource/
 Timur
Andor
на ноде каждого клиента?
𝚔𝚟𝚊𝚙𝚜
 Solyar
Ребят, кто может подсказать насчет PV и Elastic, в лс если не сложно :)
N
Всем привет! Есть вопрос про preStop hook. Правильно ли я понимаю, что в момент работы preStop hook трафик все еще распределяется на pod?
Artyom
держи конфиг:
frontend k8s-api
bind 0.0.0.0:8443
bind 127.0.0.1:8443
mode tcp
option tcplog
default_backend k8s-api
backend k8s-api
mode tcp
option tcplog
option tcp-check
balance roundrobin
default-server inter 10s downinter 5s rise 2 fall 2 slowstart 60s maxconn 250 maxqueue 256 weight 100
server k8s-api-1 192.168.0.147:6443 check
server k8s-api-2 192.168.0.148:6443 check
server k8s-api-3 192.168.0.149:6443 checkпри этом обращаться к api-server нужно будет через порт 8443, а не на 6443
Почему-то он не стартует, при попытке в инит-конфиге использовать нестандартный порт.
Artyom
Если ли возможность сменить порта для api при инициализации через kubeadm? Или он меняется как-то после старта?
Artyom
Нашёл ошибку
Artyom
Извиняюсь за глупый вопрос