 Михаил


а че? я на десктопе
Михаил
это к @vrutkovs
 Alex
было бы здорово, да
Alex
Спасибо
Alex
нет, бекендов было больше одного
Посмотри, похоже на твою схему? https://blog.egreex.com/load-balancing-without-load-balancers/
 𝚔𝚟𝚊𝚙𝚜
 Andor
Посмотри, похоже на твою схему? https://blog.egreex.com/load-balancing-without-load-balancers/
да конечно похоже, они все похожи
Andor
вот только в конфиге нжинкса был кусочек бизнес логики и моментально добавляется сверху пара слоёв
Andor
про то и говорю, что тупым tcp-балансингом там было не обойтись по историческим причинам
Alex
вот только в конфиге нжинкса был кусочек бизнес логики и моментально добавляется сверху пара слоёв
Какой именно логики? Каково было её назначение?
Andor
лень рассказывать
Andor
да и смысл
Alex
Жаль
Andor
это всё уже давно спилено и я с тех пор поменял две работы
Alex
Я бы послушал. Мало ли, где это могло пригодиться
Andor
вкратце: нжинкс получал из етцд список бекендов примерно 5-7 видов, один из этих бекендов говорил, в какой из других бекендов идти за контентом
Andor
архитекторы у этой схемы несомненно красавчики
Alex
В этом как раз и плюс подобных чатиков - у каждого какой-то уникальный опыт и им можно делиться
Andor
но что было
Alex
вкратце: нжинкс получал из етцд список бекендов примерно 5-7 видов, один из этих бекендов говорил, в какой из других бекендов идти за контентом
По описанию похоже на service mesh, не находишь?
Andor
нет
Alex
А по-моему - очень
Andor
это настолько херово работало?
ну там куча потенциальных проблем типа "роутер" отдал адрес бекенда а тот уже прилёг" и это никак не обработать уже было
Andor
лучше бы этот роутер сам дальше проксировал
Andor
или на каком-нибудь traefik это делать, а не на нжинксе
Andor
а, этот "роутер" некоторые запросы ещё и сам мог обработать
Andor
и вернуть контент
Andor
а мог послать в какой-то бекенд (по сути в заголовке ответа сказать адрес куда пойти за контентом)
Andor
говно схема, без сомнений
Andor
ваще там сначала был только keepalived + vrrp без ecmp, а потом остался он в качестве хелсчеков на нжинкс и он поднимал-тушил кваггу
поправка: он не тушил кваггу, он тушил адрес на dummy интерфейсе и квагга переставала его анонсить
Andor
ну короч классический ecmp
Alex
На предыдущей работе была адовая схема - bare metal хосты с докерами, на каждом ещё был envoy. Такой из себя костыльный service mesh, управляемый ансиблом. Я им: "посоны, а чего бы k8s не натянуть и туда не смигрировать?", а они мне: "мы тут деньги зарабатываем, а не с технологиями заигрываем" Ну ок, так и живут до сих пор
Andor
ну вполне рабочая схема
 ᴅⁱᵐⁱᴅʳ0ˡ
народ привет
ᴅⁱᵐⁱᴅʳ0ˡ
кто нибуть настраивал мониторинг прометеуса с внешними etcd ?
Alex
ну вполне рабочая схема
Рабочая-то рабочая! Но столько прерванных релизов, столько овертаймов, что ааааа
Andor
кто нибуть настраивал мониторинг прометеуса с внешними etcd ?
прометей не ходит в етцд, ему пофиг
ᴅⁱᵐⁱᴅʳ0ˡ
level=error ts=2019-04-17T08:58:00.2363683Z caller=scrape.go:147 component="scrape manager" scrape_pool=monitoring/prometheus-operator-kube-etcd/0 msg="Error creating HTTP client" err="unable to use specified CA cert /etc/prometheus/ssl/ca.pem: open /etc/prometheus/ssl/ca.pem: no such file or directory"
panic: runtime error: invalid memory address or nil pointer dereference
Andor
а, тебе метрики с етцд надо собирать?
ᴅⁱᵐⁱᴅʳ0ˡ
хотелось бы
Alex
ну вполне рабочая схема
По поводу "рабочести" схемы ещё могу сказать, что patch management самих хостов тоже был похож на ад. Это тебе не drain/uncordon - тут надо ручками запустить ансибл, который всё потушит и из всех энвоев выкинет этот хост, потом его пропатчить, перезагрузить и всё запустить обратно. И проверить, что всё нормально поднялось. Количество ручных операций просто уму было непостижимо!
Andor
ну хз, я бы папетом с экспортируемыми ресурсами с puppetdb это сделал несложно
Andor
но динамически конечно удобнее
Alex
ну хз, я бы папетом с экспортируемыми ресурсами с puppetdb это сделал несложно
Ты не понял! )) Они там "деньги зарабатывают", ага? ))
Andor
да я понял, просто свой опыт накладываю на это и понимаю что можно намного проще сделать
 Vadim
позор, люди уже не могут придумать как ссылку запостить
 Александр
До пришествия Сталина осталось... 10... 9...
Alex
сталина на них нет!
ага! это в российских реалиях нормально - каждый день решать кучу побочных проблем кроме своих собственных
Andor
ага! это в российских реалиях нормально - каждый день решать кучу побочных проблем кроме своих собственных
могу сказать что в не-российских реалиях у тебя будет то же самое, если менеджмент ниочинь
Dmytro
На предыдущей работе была адовая схема - bare metal хосты с докерами, на каждом ещё был envoy. Такой из себя костыльный service mesh, управляемый ансиблом. Я им: "посоны, а чего бы k8s не натянуть и туда не смигрировать?", а они мне: "мы тут деньги зарабатываем, а не с технологиями заигрываем" Ну ок, так и живут до сих пор
звучит как авито только куда им энсибл
 Rainbow
звучит как "лучшее решение то, которое знают твои админы"
Dmytro
паппет
Vadim
хватит превращать чат в депопс_ру, идите туда
Dmytro
насколько я помню доклад
Alex
могу сказать что в не-российских реалиях у тебя будет то же самое, если менеджмент ниочинь
да я уже похлебал. в том работодателе CTO был такой датчанин-истеричка
Dmytro
вкину по теме чтобы исправиться https://godaddy.github.io/2019/04/16/kubernetes-external-secrets/
Александр
Хрычистерия детектед
𝚔𝚟𝚊𝚙𝚜
спасибо, попробую такой подход. С haproxy до сего момента дел не имел
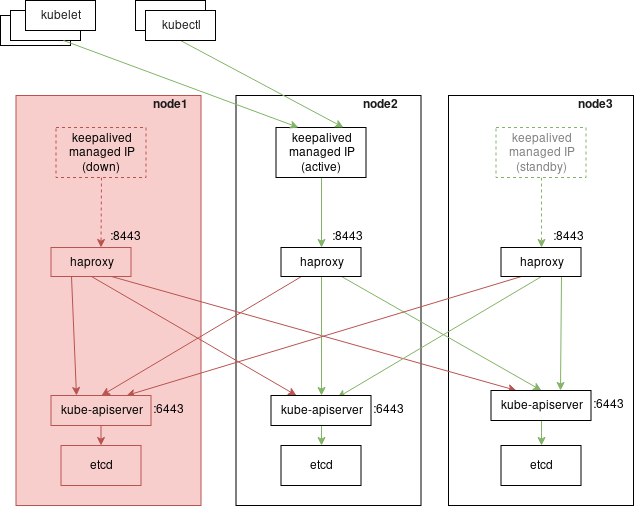
Решил схемку нарисовать, т.к. все равно коллегам объяснять еще.
𝚔𝚟𝚊𝚙𝚜
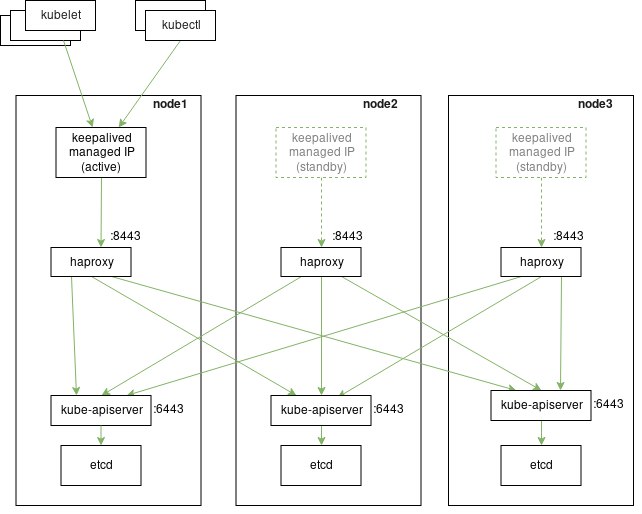 𝚔𝚟𝚊𝚙𝚜
Вот что будет, если потушить kube-apiserver на первой ноде
𝚔𝚟𝚊𝚙𝚜
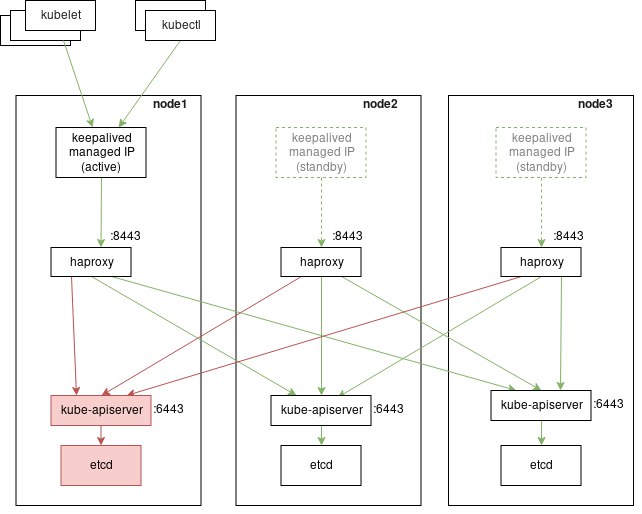 𝚔𝚟𝚊𝚙𝚜
А вот что, если всю ноду целиком
𝚔𝚟𝚊𝚙𝚜
 Andor
квапс-молодец!
Rainbow
особенный service discovery в стиле куба
Andor
етцд могут быть вообще на других хостах
Vadim
etcd в своем кластере, им не нужен лоадбалансер
а, просто на схемке связи нет, думал какое-то новое достижение
Alex
звучит как "лучшее решение то, которое знают твои админы"
чаще всего - это самая большая и толстая палка в колесо инженерного развития компании
Rainbow
чаще всего - это самая большая и толстая палка в колесо инженерного развития компании
инженерам ещё стоит качать навык "уметь продать решение", а не плакать, что их не слушают
 Viktor
Hi.
helm install --name postgres-cluster Chart.yaml --namespace database выдает Error: gzip: invalid header. не подскажете, в чем проблема?