 Andor


а если нет то оно наколенная поделка
 Maksim
я уверен что это прямо щас уже есть
это организуется снаружи. По другому говоря, в etcd записываются позиции wal по нодам, а уже на стороне можно из них что-то получать
 Alexey
кстати в столоне добавили возможность делать свитчовер на указанную ноду? или чтоб свичнуться надо по преженему останаваливать мастера?
Alexey
в свое время меня это сильно позабавило
Alexey
если не ошибаюсь там надо было костылить через синхронную репликацию и через failkeeper пометить кипер как сбойный и тогда роль мастера переезжает на заранее выбранную синхронную реплику
Alexey
в k8s пожалуй вообще НЕ принципиально куда уехал мастер, но вот в обычных инсталляциях такой подход это пиздец
Andor
это организуется снаружи. По другому говоря, в etcd записываются позиции wal по нодам, а уже на стороне можно из них что-то получать
я говорю что метрики-то они наверное уже предоставляют
Andor
как конкретно это реализовано мне в принципе пофигу %:)
 Stefan
скажем так, пока постгрес с кипером работают и не выдают фейл, а такое бывает некоторое время после выноса диска - всё будет и дальше так работать.
Запросить синхронные реплики можно либо через постгрес запросом table pg_stat_replication - в application_name после префикса stolon_ будет uid базы, либо через обращение к кластерным метаданным, например, таким запросом
stolonctl clusterdata ... | jq '.dbs | to_entries[].value | {dbUID: .uid, keeperUID: .spec.keeperUID, role: .spec.role, synchronousStandbys: .status.synchronousStandbys}'
А вообще хотелось бы иметь вывод как patronictl list :)
"synchronousStandbys": null
у всех реплик, у мастера uid прописан
это значит что они асинхронные? и это плохо?
Alexey
нет, то что у реплик null это ок
uid на мастере - показывает кто из реплик сейчас синхронная
Stefan
нет, то что у реплик null это ок
uid на мастере - показывает кто из реплик сейчас синхронная
ох капец, почему базы данных это так сложно
Alexey
поищи соответствие uid с другими киперами
Alexey
ох капец, почему базы данных это так сложно
вобще там можно несколько синхронных реплик иметь и кворумы собирать )))
Alexey
в особо развесиситых топологиях
 Maksim
в k8s пожалуй вообще НЕ принципиально куда уехал мастер, но вот в обычных инсталляциях такой подход это пиздец
почему? Я полагаю, эта фича актуальна только для гетерогенного кластера
Maksim
поищи соответствие uid с другими киперами
да, в "synchronousStandbys" указывается список из dbuid синхронных стендбаев
Alexey
почему? Я полагаю, эта фича актуальна только для гетерогенного кластера
ну да, если кластер состоит из разного по составу железа, и по плану надо сделать maintenance узлов, то проще взять обработать одну ноду и потом свичнуть мастер сразу на нее, и затем маинтайнить оставшиеся узлы
если изначально не знать куда уедеть мастер, то так можно гонять мастера туда-сюда несколько раз )))
 Dmitry
подскажите пожалуйста - могут ли контейнеры внутри одного неймспейса подключаться к другим контейнерам в этом же неймспейсе если у контейнеров не объявлены порты? вот так:
Dmitry
ports:
- name: http
containerPort: 80
- name: admin
containerPort: 8080
Stefan
ports:
- name: http
containerPort: 80
- name: admin
containerPort: 8080
ну если через сервис к ним стучаться, то да, вполне
у нас не объявлены местами в подах порты, но тем не менее всё ок
Dmitry
зачем тогда их объявляют?
Dmitry
что бы из других неймспейсов можно было ходить?
Stefan
зачем тогда их объявляют?
удобство например? допустим человек новый пришел, в душе не чает на каком порту работает приложуха, а он такой хоба, глянул и всё понятно
а не лезит в код или конфиг файл приложухи в попытках отыскать что-то
Stefan
ну это как мне кажется))
 Grigorii
зачем тогда их объявляют?
для сервис дискавери
чтобы по именам портов например находить нужные ендпойнты
например, для прометея
 Anonymous
Коллеги а есть люди у которых Istio в проде?
 Vadim
язабан
Andor
для сервис дискавери
чтобы по именам портов например находить нужные ендпойнты
например, для прометея
ты в kind: Service можешь ещё имена использовать, а не хардкодить порты
Vadim
сколько можно уже опросы проводить
Dmitry
спасибо всем
Anonymous
У меня Istio ingress gateway рвёт соединение на 50с (grpc и websocket) Кто-нибудь сталкивался?
 Denis
народ, пытаюсь изобразить такое
env:
- name: MY_POD_NAME
valueFrom:
fieldRef:
fieldPath: metadata.name
- name: ADVERTISE_ADDR
value: PLAIN://${MY_POD_NAME}:8888
и как бы не срабатывает, в ADVERTISE_ADDR не интерполируется содержимое MY_POD_NAME
Можно ли как то добится этого, не впихивая "сборку" переменной в command или что то типа того ?
 Andrey
народ, пытаюсь изобразить такое
env:
- name: MY_POD_NAME
valueFrom:
fieldRef:
fieldPath: metadata.name
- name: ADVERTISE_ADDR
value: PLAIN://${MY_POD_NAME}:8888
и как бы не срабатывает, в ADVERTISE_ADDR не интерполируется содержимое MY_POD_NAME
Можно ли как то добится этого, не впихивая "сборку" переменной в command или что то типа того ?
А так можно вообще? Думал, энвы только в коммандлайн можно.
 RE
камрады, хочу разобраться, что значит evictable and non-evictable memory на графиках для подов у GCE.
дока пишет:
memory_type: Either evictable or non-evictable. Evictable memory is memory that can be easily reclaimed by the kernel, while non-evictable memory cannot.
вроде получается, что под зарезервировал под себя какойто кусок памяти, часть из которого evictable и ядро может отобрать ее на свои нужны, и часть - занята процессами пода, и по сути есть то, что под скушал под свои задачи.
так?
Andrey
https://kubernetes.io/docs/tasks/inject-data-application/define-environment-variable-container/
 dzmitry
Привет, кто нить юзает сборку .net core + Gke + cloud sql(postrgresql)?
Andrey
а что, там какая-то специфика?
dzmitry
Проблема в connection к cloud sql, делаю через cloud proxy, но не могу законектиться, в .net core есть appsettings с connection string(имя логин пароль), эту же инфу я даю в .yaml. Вот непонятно нужно ли тогда юзать еще appsettings?
Andrey
в каком виде connection string?
Andrey
у .net свой формат: Host=sql-proxy;Database=dbname;Username=login;Password=pass
Andrey
ну и сообщение об ошибке стоит показать
 Alex
А это нормально, что kubectl при delete pod быстро пишет, что pod deleted, а потом просто висит секунд 40?
Grigorii
А это нормально, что kubectl при delete pod быстро пишет, что pod deleted, а потом просто висит секунд 40?
--wait=true: If true, wait for resources to be gone before returning. This
waits for finalizers
Alex
Grigorii
это когда ты делаешь kubectl delete
Grigorii
kubectl delete -h
Alex
а не, нашел
Alex
спасибо!
Alex
но конечно странные немного дефолты =/
Grigorii
для human странные, да, для CI наверное так удобнее
Ingvar
Добрый день , есть вопрос : как в кубере поднять кластер rabbitmq так чтобы не было split brain?
 Vlad
vvccduttuibbuvgdukbceiidncifuvvbtegbjduckbiu
 Eduard
Добрый день , есть вопрос : как в кубере поднять кластер rabbitmq так чтобы не было split brain?
Запихнуть кубер в вмварь
Anonymous
 Anonymous
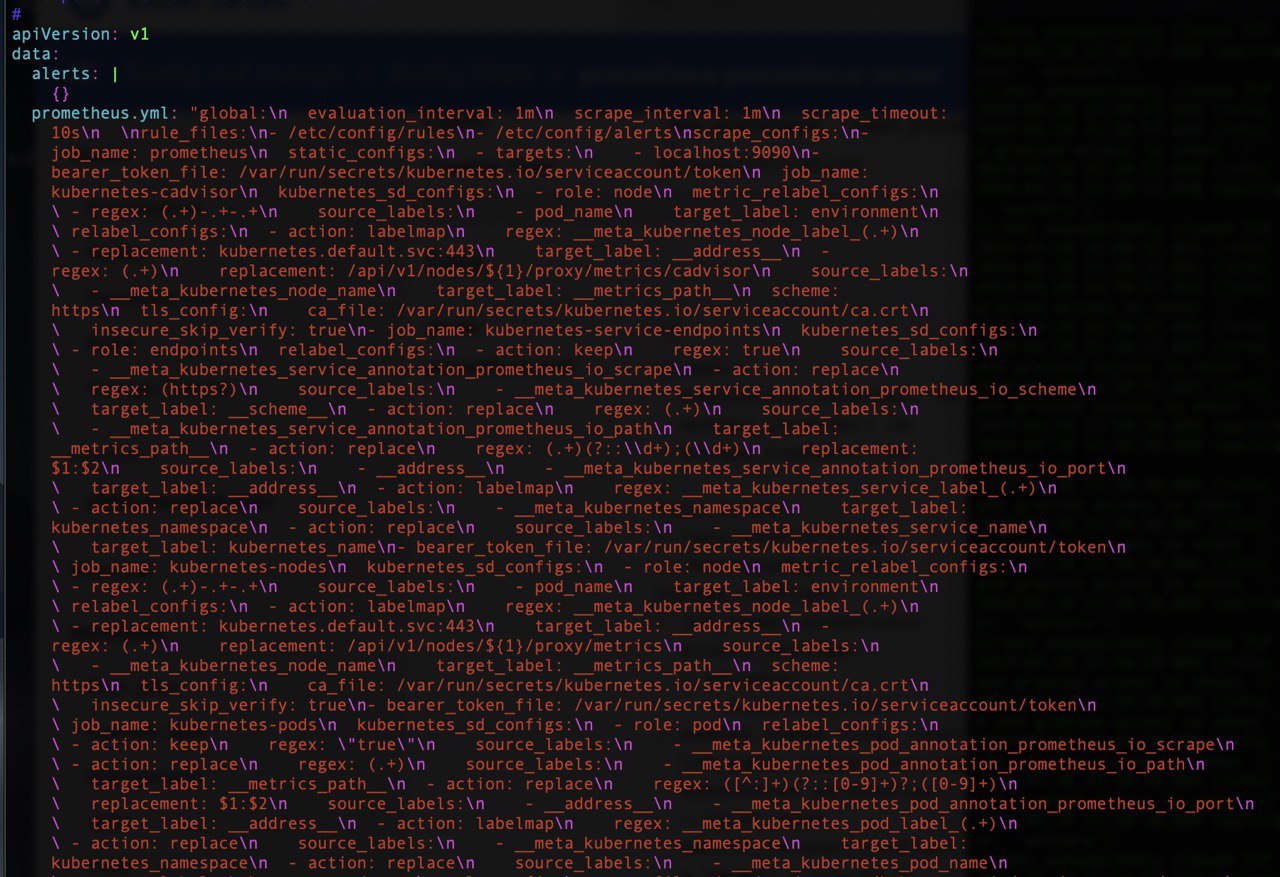
Как это по человечкески править ?
 Rainbow
А вообще там нормальный текст, только \n превратить в переносы
 𝚔𝚟𝚊𝚙𝚜
 Oleg
Вот кстати интересный вопрос, kubectl иногда представляет конфиги как string, а иногда как heredoc. И как заставить его всегда использовать heredoc для меня пока загадка.
https://github.com/kubernetes/kubernetes/issues/75446
ᴅⁱᵐⁱᴅʳ0ˡ
всем привет. в какой последовательности лучше стартовать кластер? есть 3 etcd, 2 мастера и 3 ноды
 Евгений
всем привет. в какой последовательности лучше стартовать кластер? есть 3 etcd, 2 мастера и 3 ноды
etcd, контроллеры, а потом воркеры
Vadim
etcd, мастеры + воркеры можно вместе стартовать если есть tls bootstrapping
ᴅⁱᵐⁱᴅʳ0ˡ
спасибо
𝚔𝚟𝚊𝚙𝚜
еще нововведение: 1.14 теперь настоятельно рекомендрует использовать systemd cgroups driver вместо cgroupfs
Andor
причины описаны?
𝚔𝚟𝚊𝚙𝚜
нет, только рекомендации:
[WARNING IsDockerSystemdCheck]: detected "cgroupfs" as the Docker cgroup driver. The recommended driver is "systemd". Please follow the guide at https://kubernetes.io/docs/setup/cri/
 Stas
A single cgroup manager will simplify the view of what resources are being allocated and will by default have a more consistent view of the available and in-use resources. When we have two managers we end up with two views of those resources. We have seen cases in the field where nodes that are configured to use cgroupfs for the kubelet and Docker, and systemd for the rest of the processes running on the node becomes unstable under resource pressure.
Andor
а если systemd нету, то что?
Sergey
Andor
гентушником быть не стыдно
Andor
"были"?