 Anton


Спасибо!
 G72K
Спрашиваю потому что не понимаю как это сделать без jsonnet , но ведь люди живут как то, может я переусложняю себе жизнь
 Grigorii
кстати вот если кто думает о том чтобы попробовать k8s от azure:
azurerm_kubernetes_cluster.test: Still creating... (15m40s elapsed)
Error waiting for completion of Managed Kubernetes Cluster "test"
 Alex
Спрашиваю потому что не понимаю как это сделать без jsonnet , но ведь люди живут как то, может я переусложняю себе жизнь
ну вроде неймспейсов и сервисов может хватить даже для разных окружений (staging / prod / dev)
G72K
Кстати, а кто-нибудь в курсе откуда в unix появились переменные с точками?
Всегда были, переменные окружения это кажется пара нуль терминированных С строк. Просто баш для удобства создает баш переменную из переменных окружений, но не все возможные имена (и значения) легальны в баше и тогда они не создаются, но они есть и видны через env
G72K
Так через сервисы
Что через сервисы? Вот есть дев бранчи, вы их деплоите когда, все их зависимости тоже дублируете?
G72K
кстати вот если кто думает о том чтобы попробовать k8s от azure:
azurerm_kubernetes_cluster.test: Still creating... (15m40s elapsed)
Error waiting for completion of Managed Kubernetes Cluster "test"
Ваш кластер очень важен для нас, пожалуйста оставайтесь на линии
 𝚔𝚟𝚊𝚙𝚜
Ваш кластер очень важен для нас, пожалуйста оставайтесь на линии
Сервер абонета выключен или находится вне зоны действия сети)
Alex
Что через сервисы? Вот есть дев бранчи, вы их деплоите когда, все их зависимости тоже дублируете?
у меня зависимости все отдельно деплоятся
 Vlad
@Mr_rogozin просто наткнулся на сравнение cloud managed k8s https://medium.com/@andreidascalu/kubernetes-aws-vs-gcp-vs-azure-vs-digitalocean-24d71067c795
Vlad
tips для gke: можно использовать preemtible node pool, тогда $300 хватит ещё на дольше. если гасить и поднимать кластер только на время работы с ним, то ещё на дольше растягивается. =)
Anton
Anton
G72K
у меня зависимости все отдельно деплоятся
Хорошо. Вот есть зависимость от А к B, как при деплое бранча Adev указать зависимость на Bstable ? Возьмём совет по неймспейсам, значит Adev и Bstable живут в разных неймспейсах и надо указывать fqdn. Как это сделать чисто темплейтами?
G72K
tips для gke: можно использовать preemtible node pool, тогда $300 хватит ещё на дольше. если гасить и поднимать кластер только на время работы с ним, то ещё на дольше растягивается. =)
Можно через Gitlab подписаться в GCE и получить ещё 200
Alex
Хорошо. Вот есть зависимость от А к B, как при деплое бранча Adev указать зависимость на Bstable ? Возьмём совет по неймспейсам, значит Adev и Bstable живут в разных неймспейсах и надо указывать fqdn. Как это сделать чисто темплейтами?
не юзаю такие кейсы, у меня либо сервис стабильный работает со стабильной зависимостью, либо сервис дев работает с дев зависимостью
Vlad
Можно через Gitlab подписаться в GCE и получить ещё 200
да, у GCP много купонов. если озаботиться, то можно и на $1k найти. те же cloudflare тоже по-моему что-то раздавали.
G72K
не юзаю такие кейсы, у меня либо сервис стабильный работает со стабильной зависимостью, либо сервис дев работает с дев зависимостью
Так сервис дев постоянно в разработке. Значит будут случаи когда команда B поломает свой дев ( имеют право ), после чего команда А пойдет дружно пить кофе потому что их сервис не деплоится.
 Dmitrii
Хорошо. Вот есть зависимость от А к B, как при деплое бранча Adev указать зависимость на Bstable ? Возьмём совет по неймспейсам, значит Adev и Bstable живут в разных неймспейсах и надо указывать fqdn. Как это сделать чисто темплейтами?
У меня при создание неймспейса под тестирование ветки сервиса в неймспейсе создаются алиасы для всех сервисов, ведущие на master-неймспейс.
Соответственно можно задеплоить туда 2 сервиса, они перезапишут свои алиасы и будут ходить в друг-друга, а остальные зависимости - из мастера.
 Rainbow
Хорошо. Вот есть зависимость от А к B, как при деплое бранча Adev указать зависимость на Bstable ? Возьмём совет по неймспейсам, значит Adev и Bstable живут в разных неймспейсах и надо указывать fqdn. Как это сделать чисто темплейтами?
можно делать
when: manual
пару штук если их пару штук.
на staging, production базы.
Rainbow
Так сервис дев постоянно в разработке. Значит будут случаи когда команда B поломает свой дев ( имеют право ), после чего команда А пойдет дружно пить кофе потому что их сервис не деплоится.
у команды а должна быть своя база, у б своя. При чем тут это?
Anton
G72K
У меня при создание неймспейса под тестирование ветки сервиса в неймспейсе создаются алиасы для всех сервисов, ведущие на master-неймспейс.
Соответственно можно задеплоить туда 2 сервиса, они перезапишут свои алиасы и будут ходить в друг-друга, а остальные зависимости - из мастера.
Вот это интересно. Кто создаёт алиасы? Откуда список берется?
Vlad
Это при создании пула указывается?
да, https://cloud.google.com/kubernetes-engine/docs/how-to/preemptible-vms
Alex
Вот это интересно. Кто создаёт алиасы? Откуда список берется?
ну кстати да, можно сделать сервис с алиасом на другой сервис
Grigorii
@Mr_rogozin просто наткнулся на сравнение cloud managed k8s https://medium.com/@andreidascalu/kubernetes-aws-vs-gcp-vs-azure-vs-digitalocean-24d71067c795
вот еще прекрасная табличка от чувака из блога kubedex
https://docs.google.com/spreadsheets/d/1U0x4-NQegEPGM7eVTKJemhkPy18LWuHW5vX8uZzqzYo/edit#gid=0
Dmitrii
Вот это интересно. Кто создаёт алиасы? Откуда список берется?
CI при создании неймспейса. Можно просто через kubectl в цикле взять сервисы в мастере и посоздавать в другом ns
G72K
у команды а должна быть своя база, у б своя. При чем тут это?
Я не про базу, а зависимости между сервисами, т .е как бы отдельные продукта разных команд
G72K
CI при создании неймспейса. Можно просто через kubectl в цикле взять сервисы в мастере и посоздавать в другом ns
Неймспейс создаётся на каждый бранч? Какой-то отдельный CI или тот же что и приложение деплоит?
Dmitrii
2 проекта, в одном - отдельная таска в тимсити создавала, во втором - в gitlab ci просто при деплое проверялось если ли ns
Vlad
@Mr_rogozin есть ещё один tip по gke. google периодически проводит google cloud days. последний был в Праге. можно просто зарегаться и тогда после завершения меропиятия придёт триал на 30 дней на курсы на qwiklabs или coursera
Anton
@Mr_rogozin есть ещё один tip по gke. google периодически проводит google cloud days. последний был в Праге. можно просто зарегаться и тогда после завершения меропиятия придёт триал на 30 дней на курсы на qwiklabs или coursera
О! за это большое спасибо! я начал курсеру но бесплатный курс там без лад и без квизов.
G72K
У меня при создание неймспейса под тестирование ветки сервиса в неймспейсе создаются алиасы для всех сервисов, ведущие на master-неймспейс.
Соответственно можно задеплоить туда 2 сервиса, они перезапишут свои алиасы и будут ходить в друг-друга, а остальные зависимости - из мастера.
Как выбирается имя неймспейса. Скажем при создании бранча Adev оно создаёт новый, как туда задеплоить Bdev? Т.е. как пайплайн B узнает куда деплоить?
Dmitrii
Ну предпологается что если ты пишешь какую-то фичу, во всех проектах есть ветка с именем этой фичи, тогда такой проблемы нет.
Dmitrii
А в тимсити был дропдаун через который выбирали NS, но тоже всегда было правило - одна фича - одна ветка везде - один NS
 Vadim
ein branch, ein name, ein feature
G72K
Ну предпологается что если ты пишешь какую-то фичу, во всех проектах есть ветка с именем этой фичи, тогда такой проблемы нет.
Если я правильно понял, тогда проект B может задеплоить в неймспейс созданный A , много прав же надо?
Dmitrii
wut? У нас были мультирепы с микросервисами, они все из одного проекта. Ну если несколько проектов в одном кластере можно ж просто префиксы сделать, rbac'ом там права на деплой порезать. proj-a-master, proj-b-master
G72K
Ну я про случай, когда Adev бранч создал ns, но к нему хотим подсадить Bdev для совместной разработки (распределённый монолит), получается что Bdev может деплоить в "чужой" ns.
G72K
В целом интересно, спасибо. У себя это решил на jsonnet. Везде где надо обратиться к чужому сервису , пишут resolveRelation("service-B") и получают хост с именем куда надо ходить в зависимости от кластера где деплой, окружения и проч. Или Ошибку если зависимость не может быть найдена (скажем новые проекты A и B впервые деплоятся в прод, A зависит от B, тогда если попытаться задеплоить A первым то ругается )
Anonymous
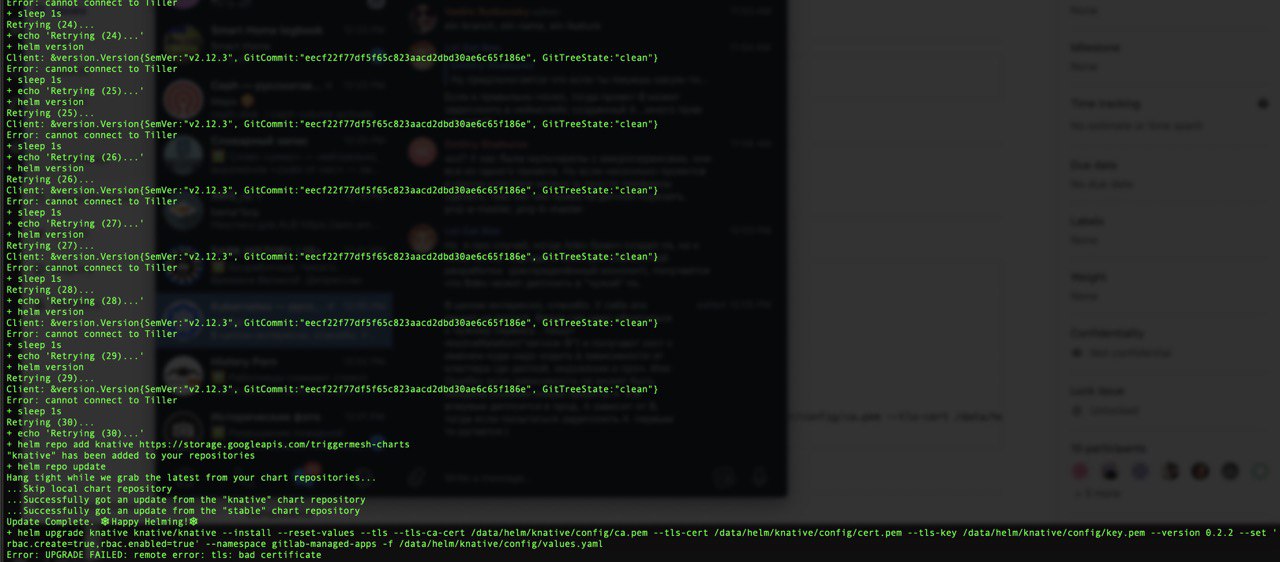
У кого то было такое? как решали?
Anonymous
 Alex
Anonymous
Причем раннер ставится норм
Hardcore
Всем привет!
Есть вопрос к людям которые держат nginx ingress на eks кластерах.
Превью:
24го января 2019 AWS анонсировали возможность ssl termination на L4 nlb.
Но для Nginx ingress в доках указан L7 alb для ssl termination на стороне LB.
Вопрос:
Возможно ли засетапать Nginx ingress c использованием ssl termination на L4 nlb ? Может кто сталкивался?
Andrey
Всем привет!
Есть вопрос к людям которые держат nginx ingress на eks кластерах.
Превью:
24го января 2019 AWS анонсировали возможность ssl termination на L4 nlb.
Но для Nginx ingress в доках указан L7 alb для ssl termination на стороне LB.
Вопрос:
Возможно ли засетапать Nginx ingress c использованием ssl termination на L4 nlb ? Может кто сталкивался?
service.beta.kubernetes.io/aws-load-balancer-type: nlb
Andrey
https://github.com/kubernetes/ingress-nginx/blob/master/deploy/provider/aws/service-nlb.yaml
Hardcore
service.beta.kubernetes.io/aws-load-balancer-type: nlb
Приветствую!
Это я как раз описал в вопросе то, что пример настройки L4 LB прост как палка.
и там нет примера прикручивания к нему сертификата из AWS ACM чтобы NLB терминэйтил SSL на своей стороне.
Сейчас думаю попробовать обьединить anntation из l7 service где указывается вся эта привязка SSL.
Но при этом указать "aws-load-balancer-type: nlb"
Вот наверно это и на самом деле и хотел спросить, пробовал ли кто такое)
Andrey
сам не пробовал, подсказать не могу. Есть сомнения, что контроллер сможет пронести сертификат из k8s на nlb
Hardcore
сам не пробовал, подсказать не могу. Есть сомнения, что контроллер сможет пронести сертификат из k8s на nlb
Но поддержка на стороне AWS уже есть.
Значит буду Мичуриным и пробовать скрестить )
 Denis
Подскажите пожалуйста, по вопросу.
Kube-state-metrics хранит последние метрики kubeapiserver. Меняются они очень динамично, в связи с чем promethues не успевает их забрать,поэтому я не могу отловить нужные мне евенты в kubeapi. Как быть в этом случае?
 Andrey
Hardcore
сам не пробовал, подсказать не могу. Есть сомнения, что контроллер сможет пронести сертификат из k8s на nlb
Для информации и всем остальным может тоже. Так не будет работать, всё создаётся но сертификат не ассайниться к l4 LB.
Но если руками накликать в консоли, то можно, но это не наш вариант.
Andrey
Подскажите пожалуйста, по вопросу.
Kube-state-metrics хранит последние метрики kubeapiserver. Меняются они очень динамично, в связи с чем promethues не успевает их забрать,поэтому я не могу отловить нужные мне евенты в kubeapi. Как быть в этом случае?
Я писал свой коллектор для VerticalPodAutoscaler объектов. Там работает client-go Reflector (https://github.com/kubernetes/kube-state-metrics/blob/master/internal/collector/builder.go#L472-L485), пишет сразу метрики в кастомизированный Store (https://github.com/kubernetes/kube-state-metrics/blob/master/pkg/metrics_store/metrics_store.go#L36-L52) сразу в виде Prometheus метрик. В теории, единственное, что происходит, когда ты ходишь в kube-state-metrics, это сериализация уже готовых структур данных из памяти в сокет в текстовом формате. Поэтому можно хоть раз в секунду долбиться.
 Stefan
господа, правильно-ли я понимаю
вот есть постгрес кластер(stolon)
есть две ноды
есть по 4 реплики(stolon-keeper, sentinel и stolon-proxy)
у киперов вольмы с ReadWriteOnce
в случае выхода из строя одной из нод, два кипера не смогут полноценно функционировать, из-за невозможности перенести свой вольюм на другую ноду, в связи с чем вопросы:
1. Если мастер был на отвалившейся ноде, stolon же должен переключиться на другого доступного воркера?
2. Если остается два кипера(мастер+воркер), кластер остается жить, до того как восстановится вторая нода?
 Andor
для патрони есть готовый оператор
Andor
хватить начинать использовать фигню! %)
Stefan

 Maksim
господа, правильно-ли я понимаю
вот есть постгрес кластер(stolon)
есть две ноды
есть по 4 реплики(stolon-keeper, sentinel и stolon-proxy)
у киперов вольмы с ReadWriteOnce
в случае выхода из строя одной из нод, два кипера не смогут полноценно функционировать, из-за невозможности перенести свой вольюм на другую ноду, в связи с чем вопросы:
1. Если мастер был на отвалившейся ноде, stolon же должен переключиться на другого доступного воркера?
2. Если остается два кипера(мастер+воркер), кластер остается жить, до того как восстановится вторая нода?
вообще столон не завязан на вольюмы, киперы максимум что делают - это чекают постгрес и если он недоступен, то помечают его unhealthy и если это был мастер начинают процедуру выбора нового после таймаута.
В вашем случае мастер роль должна перейти на тот кипер, который на живой ноде. Это может не случиться, если была установлена синхронная репликация, а на живой ноде реплики асинхронные, либо отставание асинхронной превышает maxStandbyLag.
Новый кластер будет в read-only только в случае, если число синхронных реплик по факту будет меньше minSynchronousStandbys, т.е. в вашем случае minSynchronousStandbys > 1
 Tadeusz
Anonymous
блин, у тебя как глаза? не вылезают от прозрачности такой?
это оно такое на скриншоте. В терминале уже привык что ли
Stefan
вообще столон не завязан на вольюмы, киперы максимум что делают - это чекают постгрес и если он недоступен, то помечают его unhealthy и если это был мастер начинают процедуру выбора нового после таймаута.
В вашем случае мастер роль должна перейти на тот кипер, который на живой ноде. Это может не случиться, если была установлена синхронная репликация, а на живой ноде реплики асинхронные, либо отставание асинхронной превышает maxStandbyLag.
Новый кластер будет в read-only только в случае, если число синхронных реплик по факту будет меньше minSynchronousStandbys, т.е. в вашем случае minSynchronousStandbys > 1
как не завязан на вольюмы?🤔 но ведь он их использует, для хранения данных
а как понять асинхронные они у меня или нет? я при инициализации кластера поставил сразу тип репликации - "синхронная"
спасибо за такой развернутый ответ!
Grigorii
о, я теперь знаю как я переменные называть буду
var:
- name: 🖥
value: server
- name: 💿
value: mydb
- name: 👤
value: user
- name: 🔑
valueFrom:
secretKeyRef:
name: mydb
key: passwordНу все, я настоящий хипстер B-)
а в CR вообще в ключи можно пихать)
типа вместо
size: 3
📏: 🚀🚀🚀
😄
Grigorii
а в CR вообще в ключи можно пихать)
типа вместо
size: 3
📏: 🚀🚀🚀
😄
когда ждешь пока создается k8s кластер на azure..
https://gist.github.com/gree-gorey/ad6afecd089cc6d236eb6a206d6a346e
 nikiladonya
А может заодно поскажите, вот proxy столона умеет обрывать соединения клиента, если мастер отвалился текущий, а у patroni (говорю patroni - подразумеваю postgres operator от zalando) такое предусмотрено?
nikiladonya
А чем вообще postgres operator может быть лучше stolon'а в кубах? Stolon вроде как хорошо в кубы ложится..
Stefan
Andor
то ли дело оператор, он же явно не для кубернетиса
Andor
oh wai~
Pavel
Господа, нужен совет, поставил fluent-bit + elasticsearc, fluent-bit собирает логи с /var/log/containers/*.log и в целом с этим все ясно. Вопрос: есть контейнер который пишет несколько разных лог файлов и все они нужны. и формат логов разный, есть какая-то практика, как в таком случае логи собирать?
Maksim
как не завязан на вольюмы?🤔 но ведь он их использует, для хранения данных
а как понять асинхронные они у меня или нет? я при инициализации кластера поставил сразу тип репликации - "синхронная"
спасибо за такой развернутый ответ!
скажем так, пока постгрес с кипером работают и не выдают фейл, а такое бывает некоторое время после выноса диска - всё будет и дальше так работать.
Запросить синхронные реплики можно либо через постгрес запросом table pg_stat_replication - в application_name после префикса stolon_ будет uid базы, либо через обращение к кластерным метаданным, например, таким запросом
stolonctl clusterdata ... | jq '.dbs | to_entries[].value | {dbUID: .uid, keeperUID: .spec.keeperUID, role: .spec.role, synchronousStandbys: .status.synchronousStandbys}'
А вообще хотелось бы иметь вывод как patronictl list :)
Maksim
уф, жестяк
понятно, спасибо
Кстати, можете составить фич реквест в issue, чтобы stolonctl status выдавал синхронность реплик и лаг репликации по каждой как в патрони)
 Alexey
> Запросить синхронные реплики можно либо через постгрес запросом table pg_stat_replication - в application_name после префикса stolon_ будет uid базы
там есть отдельное поле sync_state, по нему проще смотреть
Andor
> как в патрони)
trololo
Andor
на самом деле ™ это должно быть в метриках
Maksim
> Запросить синхронные реплики можно либо через постгрес запросом table pg_stat_replication - в application_name после префикса stolon_ будет uid базы
там есть отдельное поле sync_state, по нему проще смотреть
это да, но соотнести узлы постреса с конкретными киперами можно только через тот application_name либо по client_addr
Maksim
на самом деле ™ это должно быть в метриках
это можно организовать через те же запросы к clusterdata
Andor
я уверен что это прямо щас уже есть