 Andrey


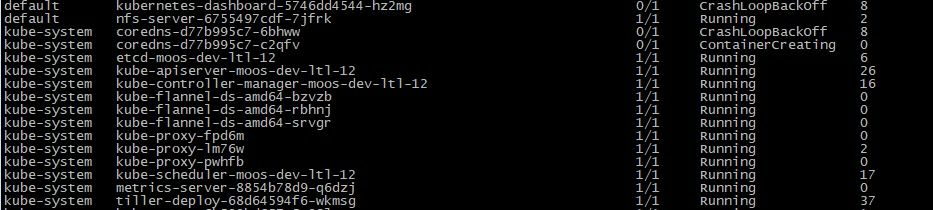
k get ev -n kube-system
 A
kubectl logs kubernetes-dashboard-5746dd4544-hz2mg
2018/12/17 14:16:05 Starting overwatch
2018/12/17 14:16:05 Using in-cluster config to connect to apiserver
2018/12/17 14:16:05 Using service account token for csrf signing
2018/12/17 14:16:05 No request provided. Skipping authorization
2018/12/17 14:16:08 Error while initializing connection to Kubernetes apiserver. This most likely means that the cluster is misconfigured (e.g., it has invalid apiserver certificates or service account's configuration) or the --apiserver-host param points to a server that does not exist. Reason: Get https://10.96.0.1:443/version: dial tcp 10.96.0.1:443: getsockopt: no route to host
Refer to our FAQ and wiki pages for more information: https://github.com/kubernetes/dashboard/wiki/FAQ
 Rainbow
kubectl get ds
уверены, что там есть flannel?
Rainbow
А, я слепой, flannelds есть, пром по центру
A
Failed create pod sandbox: rpc error: code = Unknown desc = [failed to set up sandbox container "6c8f673cf8623281c6b8444e630133c595a4e858179483083ed23a81708bb0b4" network for pod "coredns-d77b995c7-c2qfv": NetworkPlugin cni failed to set up pod "coredns-d77b995c7-c2qfv_kube-system" network: error getting ClusterInformation: connection is unauthorized: Unauthorized, failed to clean up sandbox container "6c8f673cf8623281c6b8444e630133c595a4e858179483083ed23a81708bb0b4" network for pod "coredns-d77b995c7-c2qfv": NetworkPlugin cni failed to teardown pod "coredns-d77b995c7-c2qfv_kube-system" network: error getting ClusterInformation: connection is unauthorized: Unauthorized]
Normal SandboxChanged 100s (x139 over 31m) kubelet, Pod sandbox changed, it will be killed and re-created.
A
Вот такая ошибка
A
Весь день сегодня под откос(
Andrey
хопача
A
?
Andrey
NetworkPlugin cni failed to set up pod "coredns-d77b995c7-c2qfv_kube-system" network: error getting ClusterInformation: connection is unauthorized: Unauthorized, failed to clean up sandbox container
Батенька, да у вас же плагин к аписерверу достучаться не может, у него прав не хватает. Значит, rbac криво настроен.
A
Там у калико что-то было
A
Я при его удалении и удалил
A
У фланела нет такого
Rainbow
https://raw.githubusercontent.com/coreos/flannel/bc79dd1505b0c8681ece4de4c0d86c5cd2643275/Documentation/kube-flannel.yml
как нет?
Andrey
А не, таки это объект в сторадже у калико
Andrey
Точно ли удалили? Конфиги там в /etc/cni от калико не остались?
 Danila
в rbac задаются же Role and ClusterRole
A
Andrey
В глаза долблюсь немного. Короч, ивенты таки от калико, в связи с чем вопрос выше
A
Точно ли удалили? Конфиги там в /etc/cni от калико не остались?
Там было, я их удалил и перезапустил кубелет
A
В глаза долблюсь немного. Короч, ивенты таки от калико, в связи с чем вопрос выше
Может как-то ещё почистить от калико
Andrey
Грохните какой-нибудь под и пришлите ивенты по тому, который создастся вместо него. coredns, например.
A
Грохните какой-нибудь под и пришлите ивенты по тому, который создастся вместо него. coredns, например.
Я это уже несколько раз делал, и ивент выше актуальный
A
Какие могут быть ещё варианты?
Andrey
Я это уже несколько раз делал, и ивент выше актуальный
А ивент таки от калико. Что в /etc/cni.d лежит вообще?
A
Ему cni это однозначно не нравятся
Andrey
Анатолий, вы с помощью чего кластер разворачивали?
A
kubeadm
Andrey
А пробовали по "Kubernetes the Hard Way" от Келси свет Хайтауэра?
Andrey
Это книга по ручной сборке кластера
Семён
вообще весёлая штука )
Семён
мне понравилось ) вспомнились времена как я собирал генту )
Andrey
Мне просто кажется, что вы не вполне понимаете, как связаны между собой компоненты кубеней, за что отвечают те или иные параметры, что делаете, к чему это может привести и куда в случае последствий смотреть. В результате тут простыня из сообщений на несколько экранов, которая раз за разом заходит в тупик
A
Все это круто но как мне сейчас из ситуации выйти..
A
Проблема сейчас с софтовая сетью
A
Куда можно было посмотреть посмотрел возможно не все, потому и обратился за коллективным разумом
A
Любую инфу предоставлю
Andrey
Вы вообще потерли все cni конфиги?
A
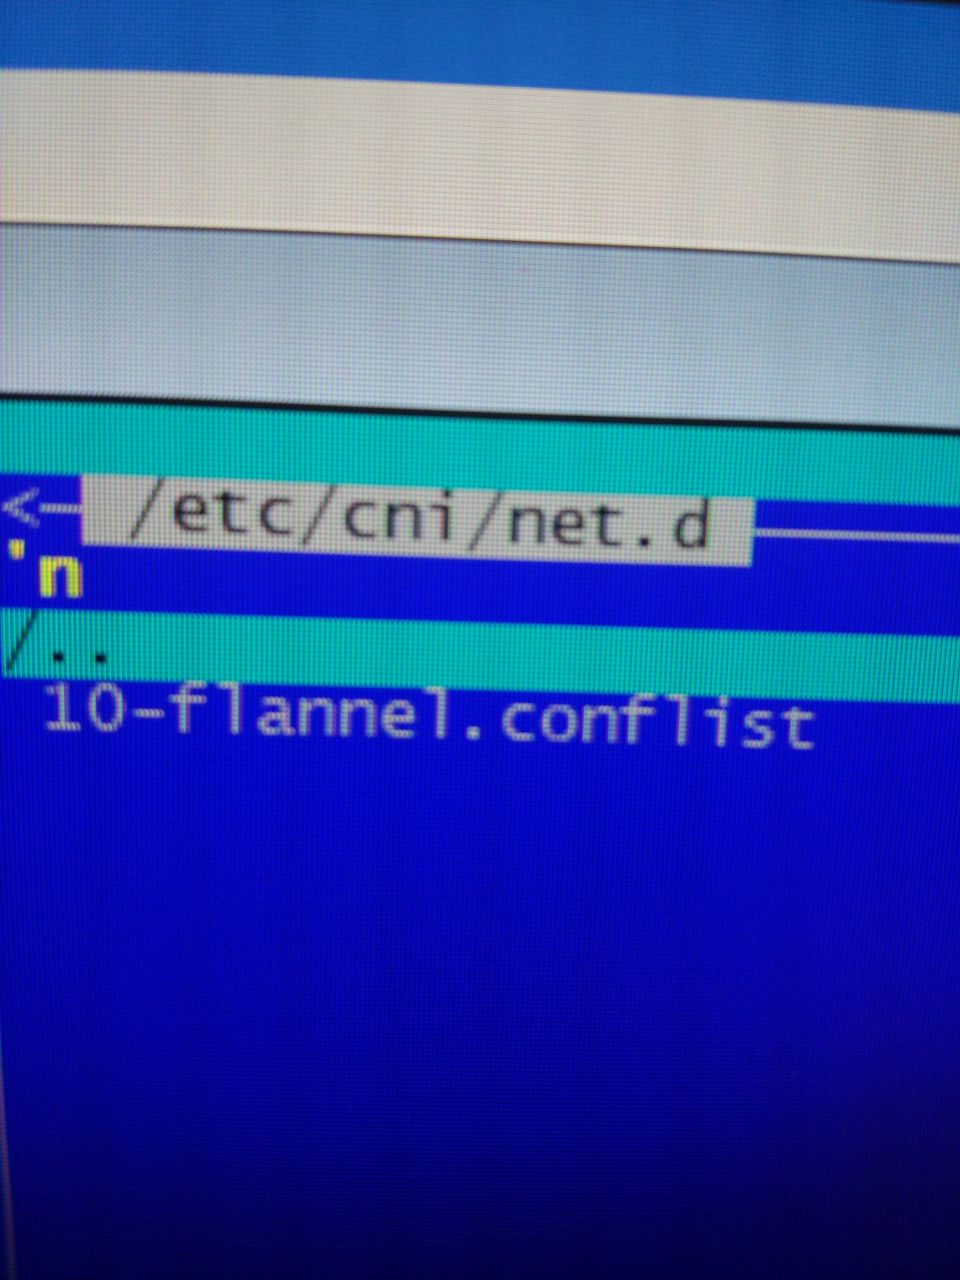
Нет, там фланел конфиг один
Andrey
что в логах фланнеля и что в конфиге?
A
 A
В конфиге ничего не менял, он по умолчанию что было, поды фланеля перегружал и они раннинг
Andrey
Понятно, а в конфиге-то что?
Andrey
И что в логах?
A
Сек
A
Понятно, а в конфиге-то что?
cat /etc/cni/net.d/10-flannel.conflist
{
"name": "cbr0",
"plugins": [
{
"type": "flannel",
"delegate": {
"hairpinMode": true,
"isDefaultGateway": true
}
},
{
"type": "portmap",
"capabilities": {
"portMappings": true
}
}
]
}
A
Было бы не плохо знать точку входа для сетевых плагинов кубера, от куда он понимает какой активный, по идее он должен быть только один
G72K
Вобщем план по достижению нирваны:
- podCIDR свой в каждом кластере, даже если планов по связыванию нет (будут)
- свой --cluster-domain , публичный DNS , уникальный на каждый кластер , например cluster1.k8s.mycorpinfra.com
- stubDomains в kube-dns на каждый кластер во всех кластерах (придется kube-dns сделать доступным между кластерами , но можно и скажем по копии kube-dns в каждом кластере на каждый кластер с доступом к apiserver внешних кластеров)
- в публичном DNS можно * или конкретные записи (external-dns контроллер в помощь) указывают на ingress controller в нужных кластерах
- приложения создают Ingress ресурсы с host именем таким же как их svc name (с учётом namespace и cluster-domain ). Эту часть можно в metacontroller.app вынести, если нету развесистого CI с jsonnet
Как итог:
- все поды и сервисы однозначно идентифицируются по имени
- поды между кластерами могут говорить напрямую (надо навесить network policy , похоже cillium cluster mesh это умеет и в istio что-то есть, но не так красиво) - репликация баз скажем становится сильно легче, подозреваю штуки вроде Кафки тоже
- у всех приложений есть готовые сертификаты через letsencrypt для внутрикластерного и внешнего SSL
- больше нет различий между внутренним и внешним доступом. Скажем весь oidc ( keycloak, gitlab) начинает работать автоматически
G72K
Было бы не плохо знать точку входа для сетевых плагинов кубера, от куда он понимает какой активный, по идее он должен быть только один
Кублет берет первый cni conf в алфавитном порядке
 Vadim
или исключительно для более понятного сетапа?
A
Кублет берет первый cni conf в алфавитном порядке
Вот это хорошая мысль, завтра опробую, но как надо было об этом догадаться. Сейчас он у меня там один, но не помню перегружал я кубелет или нет после этого. А наши и это не поможет где ещё можно калико прописаться?
G72K
или исключительно для более понятного сетапа?
Связывать их надо чтобы у каждого пода и каждого сервиса было одно глобально доступное имя. Легче думать. Federation V2 не смотрел, но первый federation имел штуки вроде "попробуем в нашем кластере, если не найдем пойдем в другом". Т.е. там судя по всему задача была "все приложения ходят в svcname, а внешняя магия разгуливает где и как svcname найти". Мне же надо наоборот, минимум изменений со временем и больше однозначности
Vadim
идея здравая, правда федерация тут не поможет, он просто сможет управлять другими кластерами
Й
Контейнер не падает сам, он штатно работает. Мне нужно его просто перезапустить
# timeout N do_somthing;
Если управились раньше N, то перезапустимся автоматом, если нет - таймаут нас прибьет и мы таки перезапустимся.
 𝚔𝚟𝚊𝚙𝚜
 Alex
Приветствую всех. Подскажите пробовал ли кто Metal Lb в качестве балансировщика на хардварном кубере?
 Ivan
Да, пробовал
Alex
Подскажите, а какзаставить кубер поднимать load balancer ip на внешнем интерфейсе (а не на ipvs) и слать arp запрос всем о том что адрес доступен?
Что-то не получается настроить(
Alex
Все по инструкции с офф сайта, layer2 конфигурация (без bgp)
Ivan
Вы имеете ввиду metallb поднять на реальном ip конкретного интерфейса?
Мне кажется, он так не умеет, выбирает первый ip из пула адресов, заданных в конфиге. Я указывал там не используемые адреса из подсети хостов.
Alex
Я аналогично указал диапазон неиспользуемых адресов из подсети внешнего интерфейса. Но извне кластера выданные адреса не доступны(
Alex
Я предложил что клипсы должны подниматься на внешнем интерфейсе (eth0) чтобы отправлять арпу всем остальным
Ivan
Сервис, в котором вы указали LoadBalancer получил ip из указанного пула?
Alex
Да, получил. Сервис доступен с каждой ноды (каждая нода подняла этот ip у себя)
A
 A
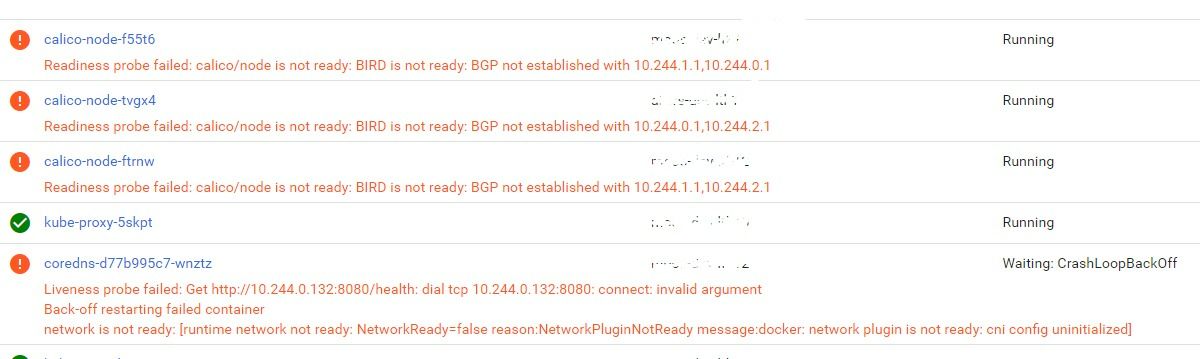
Вот такая у меня беда...
A
@rossmohax @inish777 фланел удалил опять, поставил калико и вот такое... Что не так? Кто сталкивался...
Andrey
У тебя где кластер развернут?
A
Барелметал через kubeadm
Andrey
Ограничения на хождение трафика?
A
До этого стояло калико и все было нормально, но после перезагрузки машины вот такая фигня стала