 Максим


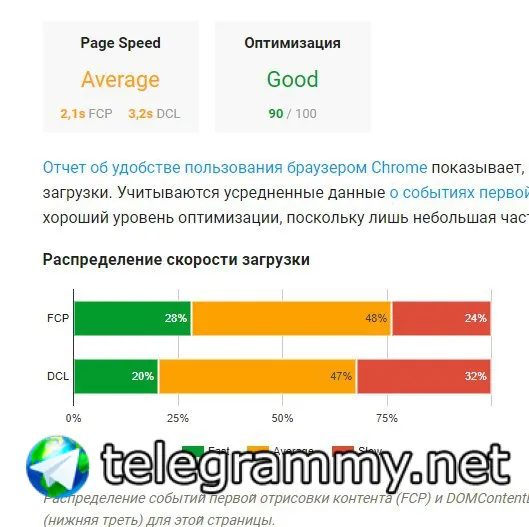
оценка главной
Максим
 The Ant
 Максим
а у меня сцаный апач)
Максим
сисадмин уже ковыряется, новый сервачок готовит)
 Aleksey
https://i.snag.gy/zCJMX6.jpg
лол
The Ant
почти. круд в админке
The Ant
 Aleksey
тут явно какой-то агрегатор )
Да не, типпа портал, дохера всего на главной. Но это не рабочий ещё варинат. Надо оптимизировать
 D
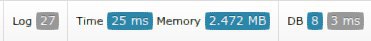
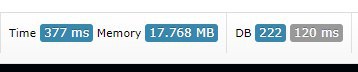
441 запрос
D
ребят
D
это дохераища просто
The Ant
 Максим
запросы дублируются, если верить дебагеру
Максим
надо в виджет заглянуть, че там
The Ant
ууу
Максим
может дебагер глючит, хз
The Ant
 Максим
5,5 сек) неплохо
The Ant

 👻
😂
 PowerAxis
http://i.imgur.com/UNnteFx.png
D
я бы копал в 776 логов))
The Ant
типа шаб отдельным файлом под запись
The Ant
в лог пишет render /var...
D
а это
индекс на видеоид?
The Ant
есть )
The Ant
просто там 700 элементов, (не 900)
The Ant
in медленный сам по себе
The Ant
джойн должен быстрее быть намного
Макс
Всем привет.
Есть кейсы когда в БД записываются по 30К-100К строк из csv. Все это разные сущности, по ~4 сущности на URL.
Сейчас я записываю все отдельными запросами. Из-за мускула добавление 30К строк занимает очень много времени, больше часа.
Я думаю что нужно переносить логику на batch insert. Но как-то получается уж очень сложно. Запись через batch insert высчитывание id (он же не возвращает id записанных записей), слияние связей, а если есть параллельный процесс.
Поделитесь опытом как лучше организовать подобную запись в БД?
The Ant
30к инсертит больше часа?
 who are you
Сервак за три бакса
 Dmitriy
а потом говорят что симфонию без кеша никто не запускает ))
она сама кеширует классы. не более того.
да и любой шаблонизатор обязан кешировать.
Макс
Нее, ничего не парит, csv разбирает. 30к строк 120к сущностей
Dmitriy
Всем привет.
Есть кейсы когда в БД записываются по 30К-100К строк из csv. Все это разные сущности, по ~4 сущности на URL.
Сейчас я записываю все отдельными запросами. Из-за мускула добавление 30К строк занимает очень много времени, больше часа.
Я думаю что нужно переносить логику на batch insert. Но как-то получается уж очень сложно. Запись через batch insert высчитывание id (он же не возвращает id записанных записей), слияние связей, а если есть параллельный процесс.
Поделитесь опытом как лучше организовать подобную запись в БД?
если нужен batch insert и нужны id
варианты :
1. guid и подобное
2. LAST_INSERT_ID(), ROW_COUNT()-1
The Ant
Нее, ничего не парит, csv разбирает. 30к строк 120к сущностей
де код? давай код, щас найдем проблему :D
Anonymous
Кароче, чо могу сказать
Anonymous
Дарт говно
Anonymous
С# рулит
Anonymous
Стока фич, шо аж глаза радуются
Anonymous
И как люди на нем пишут блять
Anonymous
Тока фича со структурами крутая
Anonymous
Я там шарпистов в курсе своего изучения держу
Anonymous
Пусть знают какой у них язык ебанутый
The Ant
Пусть знают какой у них язык ебанутый
ты им тока не говори что ты пхпшник, а то скатишься до уровня макаки в их глазах ;D
Anonymous
ты им тока не говори что ты пхпшник, а то скатишься до уровня макаки в их глазах ;D
Я ж в ооп чуть-чуть-чуть-чуть-чуть-чуть-чуть-чуть умею
 Vladislav
Залетаю в тему даже не вьехав. Что за язык ебануты?)
Anonymous
?
Vladislav
почему
Anonymous
Потому
Vladislav
👍
The Ant
$model$ = new $_POST['form_model'];
узнаю уиишников
 Yet Another Stats (β)
Максим
Херасе
who are you
😬
 Павел
Молодым везде у нас дорога!
Павел
Ты чо седня такой добрый?
Павел
Выпил чтоли?
Anonymous
На шарп подсел
Anonymous
Я не пью