Это как no-code его появление не убрало спрос на кадры, а просто увеличило скорость сборки продуктов и повысило удобство
Кстати посоветуй что-нибудь ноукод чтобы можно было с клиентами работу организовать, рассылки например, чтобы база клиентов была и т.д.
 Юра


 Михаил
Кстати посоветуй что-нибудь ноукод чтобы можно было с клиентами работу организовать, рассылки например, чтобы база клиентов была и т.д.
црм чтоль? Да я только salesap и знаю - но это не no-code
Юра
Ну можно например взять какой-нибудь airtable с него через make рассылки делать всякое такое
Юра
Не пробовал но по идее должно работать
Spider
Коллеги а есть ли в симфони какойто общепринятый модуль(или бандл - в терминологии симфы ) для магазинов?
 Aleksandr
вам показалось)
 Nikolay
Здравствуйте всем!
я знаю здесь сидят опытные программисты, кто уже много лет занимаются программированием и решают бизнес проблем с помощью IT решений
хотел узнать что вы думаете насчет Devin AI?
как это коснется рынка IT
заранее спасибо за ваш подробный ответ)
Я обычный человек, когда вижу такие новости меня берет страх и обида, потому что люблю программировать. Но стоит по лучше узнать специфику разобраться, как оказывается, что не все так однозначно. А самое интересное, что ИИ как бы и не думает а делает подобную форму. Для лучших из нас - работа будет (скорее всего). Для вайтишников - пошли бы они к черту
Alex
Здравствуйте всем!
я знаю здесь сидят опытные программисты, кто уже много лет занимаются программированием и решают бизнес проблем с помощью IT решений
хотел узнать что вы думаете насчет Devin AI?
как это коснется рынка IT
заранее спасибо за ваш подробный ответ)
Выглядит как попытка пиара. Для чего то простого пойдет. А задачи сложнее вряд-ли. Или пока что вряд-ли. У некоторых есть Запрет за стороннее ПО, там и свои брокеры очередей пишут и свои СУБД.. молодые тоже всегда нужны будут. Ответственность на человеке ещё долго будет, чтоб было с кого спросить.. так что считаю не стоит паниковать.. более того- как доп. инструмент себе в арсенал можно присматривать
 Kirill
https://sylius.com/
Михаил
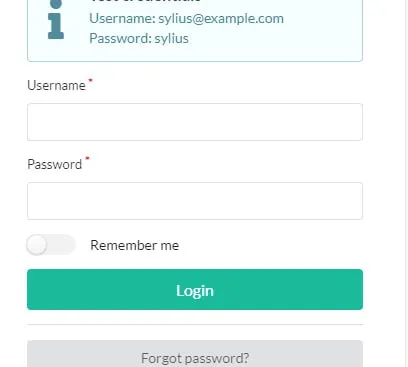
там даже админка есть) https://demo.sylius.com/admin/login
 Михаил
Логин и пароль прям на форме логина
Сергей
Demo
Михаил
Народ, у меня такая проблема.
Для оптимизации кол-ва запросов к моему апи я храню копии записей, которые клиент получил из апи в локальном индексируемом хранилище браузера https://learn.javascript.ru/indexeddb
В итоге при первом запросе я сканом запрашиваю все данные и сохраняю их в локальную стору, и дальше клиент работает с локальной сторой. Но её нужно обновлять - и тогда я просто беру максимальный updated_at в локальной сторе и запрашиваю по апи все ресурсы которые больше этого updated_at.
Это работало до того как я сделал систему веток. Теперь при переключении между ветками могут становиться неактуальными данные где-нибудь посередине локального хранилища, и вот так просто я уже не обновлюсь.
Может быть есть какие-нибудь другие способы синхронизации данных?
Юра
Почему они становятся не актуальными посередине?
Юра
Из описания ничего не понятно
Михаил
Вот я нахожусь на ветки dev
[Id статьи]) [название ветки] - [updated_at]:
1) master - 10
2) dev - 3
3) master - 1
Я переключаюсь на master, соответственно запись с id 2 становится неактуальной. Но так как я беру max(updated_at) - это будет 10. Если у мастеровой записи номер 2 будет updated_at меньше 10 то её не зацепит обновлением и она так и останется неактуальной.
 Vlad
Вот я нахожусь на ветки dev
[Id статьи]) [название ветки] - [updated_at]:
1) master - 10
2) dev - 3
3) master - 1
Я переключаюсь на master, соответственно запись с id 2 становится неактуальной. Но так как я беру max(updated_at) - это будет 10. Если у мастеровой записи номер 2 будет updated_at меньше 10 то её не зацепит обновлением и она так и останется неактуальной.
забей на оптимизацию запросов, думая что оптимизируешь, ты стреляешь себе в ногу
Vlad
а синкать данные можно через вебсокет, но ты должен подумать, реально ли но тебе надо
+ ключем записи должен быть не id а комплексное значение [id + branch] например
+ ты должен учитывать что статью могут менять с двух устройств и в этом случае тебе надо актуализировать кэш
Михаил
 Михаил
а синкать данные можно через вебсокет, но ты должен подумать, реально ли но тебе надо
+ ключем записи должен быть не id а комплексное значение [id + branch] например
+ ты должен учитывать что статью могут менять с двух устройств и в этом случае тебе надо актуализировать кэш
Вебсокеты - это игрушка дьявола.
Комплексный ключ не решит проблему
Да, учитываю - там другой механизм и он прекрасно работает
Vlad
Почему игрушка дьявола 😂
Михаил
Почему игрушка дьявола 😂
Ну потому что это отдельная точка отказа, это доработки и на фронте и на сервере.
Вот что сокеты могут решить? Только если клиент онлайн и пришло обновление. А что если он был офлайн.
Михаил
Короче мы отошли от темы
Vlad
Ну потому что это отдельная точка отказа, это доработки и на фронте и на сервере.
Вот что сокеты могут решить? Только если клиент онлайн и пришло обновление. А что если он был офлайн.
Кэш хранить дольше чем на сессию оч дурная идея
Vlad
Но я не в контексте поэтому меня не слушай😂
Vlad
Давай тогда поудаляем сообщения
Хахп, занимайся если хочешь, а вообще перечитал твой вопрос и не вижу в чем трудность.
Если ты хранишь данные дольше чем одна сессия, то при инициализации приложения ты выкачиваешь статьи по дате обновления для каждой ветки. И раз в 30 сек делаешь этот запрос для актуализации данных на клиенте или через веб сокеты.
Vlad
Правда пользователь будет не рад что ты создаёшь у него на устройстве локальную базу)
Михаил
Хахп, занимайся если хочешь, а вообще перечитал твой вопрос и не вижу в чем трудность.
Если ты хранишь данные дольше чем одна сессия, то при инициализации приложения ты выкачиваешь статьи по дате обновления для каждой ветки. И раз в 30 сек делаешь этот запрос для актуализации данных на клиенте или через веб сокеты.
Верно, и это работало до ветвления, так как можно было бы просто по updated at вытянуть
Vlad
Но зачем вообще хранить эти данные на клиенте я не очень понимаю
Vlad
Верно, и это работало до ветвления, так как можно было бы просто по updated at вытянуть
Ну тут вопрос как оно у тебя реализовано
Vlad
Потому что одна статья в двух ветках это не один id
Михаил
А и не нужно понимать, на каждый чих пользователя делать апи запрос - пользователю будет не в кайф.
То что у пользака будет пару мегабайт в файлах крутиться - абсолютно всё равно.
Vlad
Vlad
при редактировании периодически все равно надо сохранять
Михаил
Ну тут вопрос как оно у тебя реализовано
[increment] [article id] [branch name] [article data]
1 uuid1 master {…}
2 uuid1 dev {…}
3 uuid2 master {…}
То есть когда я создал ветку dev и в рамках этой ветки решил отредактировать статью uuid1 то при сохранении сервис видит что dev версии статьи нет и тогда он форкает мастер версию и применяет к этой форкнутой версии все изменения.
Если дев версия статьи уже существует, то он применяет изменения сразу к ней.
Как итог - мастер версия не тронута
Михаил
Если мы хотим смержить дев с мастером, то мы берём все статьи в дев версии и по их uuid находим их мастер версии и мержим
Михаил
что знчит на каждый чих)
Ну кроме сохранения есть ещё и фильтрация, поиск связей (когда одна статья ссылается на другую) и так далее и тому подобное.
Vlad
[increment] [article id] [branch name] [article data]
1 uuid1 master {…}
2 uuid1 dev {…}
3 uuid2 master {…}
То есть когда я создал ветку dev и в рамках этой ветки решил отредактировать статью uuid1 то при сохранении сервис видит что dev версии статьи нет и тогда он форкает мастер версию и применяет к этой форкнутой версии все изменения.
Если дев версия статьи уже существует, то он применяет изменения сразу к ней.
Как итог - мастер версия не тронута
Когда ты создаешь дев ветку, надо клонировать статью, иначе получится ты редактируешь статью в дев 10минут в это время кто то в мастере поменял статью и получилась жопка
Михаил
Vlad
Вы невнимательно читаете
Почему, ты там написал когда сохраняется статья и если ее нету в дев она форкается, сохранить статью я могу завтра и если у вас там не реализовано что то типо коммитов то ситуация будет специфичная.
Михаил
Почему, ты там написал когда сохраняется статья и если ее нету в дев она форкается, сохранить статью я могу завтра и если у вас там не реализовано что то типо коммитов то ситуация будет специфичная.
Потому что редактирование статьи это не тема моего вопроса и я все описал в общих чертах.
И вообще как мы от «синхронизации кешей» перешли к «версионированию»?
Vlad
Потому что редактирование статьи это не тема моего вопроса и я все описал в общих чертах.
И вообще как мы от «синхронизации кешей» перешли к «версионированию»?
Тогда в двух словах. Синхронизация данных может быть реализована путем оповещения клиента о изменении или запросом изменившихся данных.
Почему ты не можешь получить список обновленных данных по дате из за веток это детали реализации и структуры твоего приложения.
Получая самую свежую дату по всем веткам и делай запрос на получение статей для всех веток или делай запросы отдельно для каждой ветки.
Михаил
Тогда в двух словах. Синхронизация данных может быть реализована путем оповещения клиента о изменении или запросом изменившихся данных.
Почему ты не можешь получить список обновленных данных по дате из за веток это детали реализации и структуры твоего приложения.
Получая самую свежую дату по всем веткам и делай запрос на получение статей для всех веток или делай запросы отдельно для каждой ветки.
Щас дела доделаю и покажу как это происходит
Vlad
Очевидные ивенты, например sse и обновление чего изменилось
дада, тут запрос раз в N секунд наоборот создаст нагрузку
 The Ant
дада, тут запрос раз в N секунд наоборот создаст нагрузку
Или не создаст. Все зависит от железа и сколько и как часто редачат
The Ant
Тащемта у тебя вариантов как бы и нет. Узнавать изменения все равно надо. Вопрос а том как это делать.
Vlad
Или не создаст. Все зависит от железа и сколько и как часто редачат
ну учитывая что он хранит данные для оптимизации запросов к апи, запросы раз в N сек выглядят абсурдно) дешевле запрашивать данные по необходимости
Vlad
а когда уже ты арендовал 10 кластеров в амазоне думать как можно оптимизировать)
Михаил
Странная подмена понятий. Запрос раз в n секунд - нагрузка, а апи запрос на каждое действие пользователя и перегонка одних и тех же данных - выигрыш.
Короче это не тема для обсуждения, потому что прирост к перфомансу и положительный фидбек от пользователя я получил
The Ant
Странная подмена понятий. Запрос раз в n секунд - нагрузка, а апи запрос на каждое действие пользователя и перегонка одних и тех же данных - выигрыш.
Короче это не тема для обсуждения, потому что прирост к перфомансу и положительный фидбек от пользователя я получил
Ты видимо не знаешь что такое сервер сайд ивенты.
Реализация Лонг полингом одна из. А твои изменения получать с сервера подписавшись на события. Зачем запрашивать специально то что изменилось? Когда можно по факту получить.
Михаил
Хотя я понимаю что вы пытаетесь сделать - несуществующую проблему не надо решать
Михаил
Ты видимо не знаешь что такое сервер сайд ивенты.
Реализация Лонг полингом одна из. А твои изменения получать с сервера подписавшись на события. Зачем запрашивать специально то что изменилось? Когда можно по факту получить.
я знаю что это такое, не понимаю как оно решает мою проблему
The Ant
я знаю что это такое, не понимаю как оно решает мою проблему
Вот так: кто-то что-то поредачил, случилось событие. Ты о нем узнал и отреагировал. Конкретный документ, конкретную ветку.
Михаил
Круто.
А теперь как оно решает проблему - "человек не работал 2 дня и зашёл на сайт"
The Ant
Вот так и работает. Запросит список событий и обновит свой кеш. Если чето там было
Михаил
то есть мне нужно ещё хранить таблицу со списком событий?
The Ant
Тебе ее в любом случае какое-то время хранить. Лаг во время подключений/переключений никто не отменял
The Ant
А вообще если документ устарел и его не редачили сколько-то времени, просто загрузи данные по новой. Об этом уже говорили.
Михаил
Хорошо, то есть твоё решение
1) дополнительно реализовать event sourcing или полностью перевести на event sourcing мои статьи
2) реализовать любой транспорт получения ивентов (long pull, websocket)
3) фронт должен знать про события и хранить id последнего события
3 альтернативный) бек знает последнее запрошенное событие
4) механизм редьюсинга событий что бы клиент не повесился при попытки считать их все
Михаил
просто у меня
1) одна табличка со статьями
2) табличка на фронте
3) http запросик который 99% вообще не создаёт футпринта и отвечает что ничего не изменилос (один запрос к бд и всё)
Vlad
Хорошо, то есть твоё решение
1) дополнительно реализовать event sourcing или полностью перевести на event sourcing мои статьи
2) реализовать любой транспорт получения ивентов (long pull, websocket)
3) фронт должен знать про события и хранить id последнего события
3 альтернативный) бек знает последнее запрошенное событие
4) механизм редьюсинга событий что бы клиент не повесился при попытки считать их все
Это по дефолту реализовано в том же клиенте центрифуги.
Vlad
А вообще если документ устарел и его не редачили сколько-то времени, просто загрузи данные по новой. Об этом уже говорили.
+ не хранить данные дольше сессии)
The Ant
Ты просто создал два источника правды, и теперь пытаешься их как-то помирить. Не получится.
Каждое действие пользователя должно сохраняться на сервер. Поскольку статью могут редачить несколько людей, об каждом измении должны узнавать все.
Открой гугл документы чтоль.
Даже если ты делаешь по модели Гита с коммитами, все равно все клиенты должны узнать об измениях. Иначе как вообще тогда разрешать конфликты?
Spider
Коллеги подскажите как правильно использовать окружение симфы они для докера которое приведено на сайте симфы(https://symfony.com/doc/current/setup/docker.html)
Не очень ясна логика - надо ли и как пробрасывать файлы проекта которые будешь редактировать?
Или тут логика такая что написал проект собрал образ и тестируешь?
Михаил
Ты просто создал два источника правды, и теперь пытаешься их как-то помирить. Не получится.
Каждое действие пользователя должно сохраняться на сервер. Поскольку статью могут редачить несколько людей, об каждом измении должны узнавать все.
Открой гугл документы чтоль.
Даже если ты делаешь по модели Гита с коммитами, все равно все клиенты должны узнать об измениях. Иначе как вообще тогда разрешать конфликты?
Источник правды один - сервер. Думай про локальную табличку как про кеш в редисе.
Как мы обычно кешируем внешние апи на сервере. Наш код обращается к кешу, а некая прослойка актуализирует этот кеш (по таймеру или по протуханию)
Vlad
The Ant
Источник правды один - сервер. Думай про локальную табличку как про кеш в редисе.
Как мы обычно кешируем внешние апи на сервере. Наш код обращается к кешу, а некая прослойка актуализирует этот кеш (по таймеру или по протуханию)
Тебе точно нужен этот кеш? Почему стейтменеджера какого реакта не хватает?
Михаил
Тебе точно нужен этот кеш? Почему стейтменеджера какого реакта не хватает?
потому что при перезагрузки страницы нужно будет заново всё грузить
The Ant
Это проблема? Как часто страница перезагружается?
Если это заточено под мобилу тогда ок )
Михаил
Это проблема? Как часто страница перезагружается?
Если это заточено под мобилу тогда ок )
Манагеры часто открывают новые вкладки, уходят на обед тоси боси - частенько короче
А к слову, если открыто 10 вкладок, то обновляет кеш только одна из них - остальные реактивно получают события из индексированного бд.