 Αλεχ


ребят
Αλεχ
я специально в оффтопе тему создал
Αλεχ
тут это не любят
Αλεχ
давайте там
 Cat
👍🏾
 Nikolay
@fafhrd91 https://t.me/rust_offtopic/14724 есть мысли почему fasthttp внезапно быстрее?
Сложно сказать, я не нашел код бенчей. Потом как-то странно нормализовать по цпу. Я не представляю как ускорить актикс даже на 10% а сделать что-то в два раза быстрей это как-то вообще не реально
 Vladimir
Посмотри примеры mockito
посмотрел
так разве это не веб-сервер для интеграционного тестирования?
допустим у меня есть крейт для работы с БД
и я хочу убедиться, что мой модуль вызывает на нем метод коннект, потому три раза квери с параметром === X, затем дисконнект
или такое не принято в мире раста?
 kitsu
тест который повторяет логику тестируемой функции?
Roma
тест который повторяет логику тестируемой функции?
юзернейм не логику хочет проверять, а её внутреннее устройство, не?
 Alexander
посмотрел
так разве это не веб-сервер для интеграционного тестирования?
допустим у меня есть крейт для работы с БД
и я хочу убедиться, что мой модуль вызывает на нем метод коннект, потому три раза квери с параметром === X, затем дисконнект
или такое не принято в мире раста?
Подозреваю, "в мире раста" такое принято скрывать за трейтом и для тестов делать и подсовывать реализацию трейта, которая проверяет что хочешь.
Alexander
А вообще, вместо этих юнит-тестов с безумными моками лично я рекомендую property-based тесты + end-to-end тесты. В сумме получится и проще, и покрытие лучше.
Vladimir
e2e тесты это тоже хорошо, только долго
что если у меня в зависимостях несколько внешних сервисов
т.е. мне перед каждым тестом нужно раскатать в БД снапшот, поднять MQ, запустить тест, дождаться наступления каких-то событий итд
это не то, что можно при каждом билде выполнять. )
Cat
оно? https://github.com/kriomant/mockers/blob/master/doc/guide.md
Alexander
Ну и не нужно при каждом билде. При каждом - property-based. End-to-end - на стейджинге.
Αλεχ
Αλεχ
типа сколько мы обрабатываем на условно 1% CPU?
 պլհկ
Αλεχ
Это кто?
 ppavel
Автор fasthttp
Αλεχ
Ну это странная метрика да
Αλεχ
Любоц однопоточный код разорвёт параллельный
Αλεχ
ща разбаню
Cat
Просто нужно ещё раз зайти и нажать "идём"
 Антон
А нету, случайно, в Rust аналога LINQ как в C#?
Если чего-то, что может компилироваться в рантайме в код на IEnumerable или SQL-запрос к базе, то нет. Если насчёт преобразований коллекций (к чему относится большая часть кода с LINQ) — то итераторы
Αλεχ
А нету, случайно, в Rust аналога LINQ как в C#?
https://doc.rust-lang.org/stable/std/iter/trait.Iterator.html
Αλεχ
in a nutshell: linq2object это просто методы итератора, linq2sql живет в виде diesel
Антон
ну scroll (https://docs.rs/scroll/0.9.2/scroll/)
Надо автору PR сделать, чтобы byteorder юзал, а не городил бы свой велосипед
Alexander
Любоц однопоточный код разорвёт параллельный
WOW! Новое слово в параллельном программировании! А HPC мужикизнают? 😂
 Vladimir
 Mikail
WOW! Новое слово в параллельном программировании! А HPC мужикизнают? 😂
Это сказано в контексте метрики "производительность на 1 процент CPU".
Αλεχ
Спасибо, жаль что ручками таки придется поработать
вот небольшой пример https://github.com/Pzixel/dotnet-rs/blob/feature/moar_metadata/src/main.rs
Αλεχ
rust_begin_panic();
let x = 2*2;
если функция ! то компилятор ругнется на вторую строчку, Если () то нет
Alexander
Это сказано в контексте метрики "производительность на 1 процент CPU".
Даже в этом контексте не факт, что "порвёт". Параллельный алгоритм при очевидных условиях может выдать ровно ту же производительность. Дальше всё зависит от оверхеда на синхронизацию, но он может быть и не 50%, а 10%, 5% или даже 0.5% - в зависимости от. Что не тянет на "порвёт".
Anton
вот небольшой пример https://github.com/Pzixel/dotnet-rs/blob/feature/moar_metadata/src/main.rs
Спасибо, правда я уже сделал)
Αλεχ
Даже в этом контексте не факт, что "порвёт". Параллельный алгоритм при очевидных условиях может выдать ровно ту же производительность. Дальше всё зависит от оверхеда на синхронизацию, но он может быть и не 50%, а 10%, 5% или даже 0.5% - в зависимости от. Что не тянет на "порвёт".
с ростом параллелизации эффективность использования процессора на единицу полезной нагрузки падает
Αλεχ
закон амдала и вот это все частично про это
Alexander
Αλεχ
за ту же синхронизацию, за более плохое использование кэшей, за алгоритмы когерентности кэшей между ядрами, вот это все
Alexander
Т.е. в случае отсутствия синхронизации разницы не будет, о чём я и говорил.
Alexander
При наличии синхронизации - смотри мой предыдущий ответ. "Порвёт" - сильное преувеличение.
Αλεχ
даже если ты побил массив на чанки и суммируешь чанки будет деградация
Αλεχ
оверхед 50% спокойно может быть
Αλεχ
более типичные 10-20%, но все же
Alexander
А если я параллельно маплю функцию на массив - то нет.
Αλεχ
помню чел мерил SSE против скалярных инструкций
Αλεχ
у него получалось что-то типа 3.5 инструкций
Αλεχ
при ожидаемом ускорении в 4 раза
Alexander
более типичные 10-20%, но все же
Что уже не тянет на "порвёт" по-моему. А если постараться и снизить издержки до 5%, то можно и не заметить за разбросом по сумме факторов.
Αλεχ
https://habr.com/ru/company/intel/blog/245755/
Alexander
при ожидаемом ускорении в 4 раза
Ожидание чтения-записи памяти никто не отменял. На GPGPU так можно и отрицательное ускорение получить.
Αλεχ
короче срач ни о чем
Αλεχ
доказывать, что такое "порвет" или не "порвет" мне лень
Αλεχ
удачи
Αλεχ
 Αλεχ
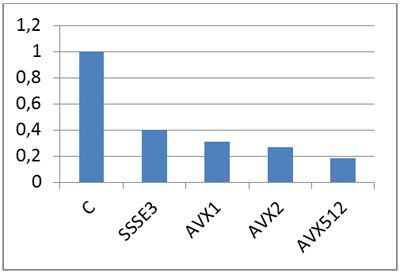
ну вот avx512
Αλεχ
Производительность кода составляет P=0.183, k=5.44X.
Αλεχ
примерно х5
Αλεχ
она по 16 интов складывает
Αλεχ
5/16=..
Alexander
Ещё сильно зависит от собственно последовательности инструкций. И это на одном ядре, да.
Αλεχ
у меня не было хорошей статьи которая так же разбирала бы многопоток
Αλεχ
но в случае SSE увеличение ширины выполнения инструкции в 16 раз приводит к х5 приросту
Αλεχ
оверхед больше 50%
Αλεχ
запили статью если хочешь, где покажешь линейный рост эффективности от многопотока
Αλεχ
желательно для веб-серверов (мы же их обсуждали), а не задачу просуммировать массив
Alexander
оверхед больше 50%
Но это НЕ оверхед на синхронизацию. Совсем не в том смысле и не в том виде как синхронизируются потоки.
Alexander
Для веб-серверов это особенно смешно, поскольку пост (справедливо) ссылался на IO-boundness задачи.
Alexander
Уже совсем непонятно зачем они на CPU нормировали.
Αλεχ
вот и мне непонятно
Vladimir
оно? https://github.com/kriomant/mockers/blob/master/doc/guide.md
о, а вот это похоже на правду
спасибо!
Αλεχ
давай переформулируем: однопоточноый код всегда будет быстрее однопоточного при нормированном цпу. Потому что в лучшем слуае у тебя линейное ускорение с небольшой синхронизацией в конце для агрегации
Αλεχ
Но это НЕ оверхед на синхронизацию. Совсем не в том смысле и не в том виде как синхронизируются потоки.
бтв если статью не видел мб тебе понравится
Αλεχ
хотя вряд ли что-то новое там есть
Zver
О чем вы спорите. При чем тут скорость, поточность и AVX?