Хочу гибко выбирать "первое вхождение" или "последнее вхождение" блока теста
О, уже человеческий язык. Что значит "гибко"?
 ddd

 ddd
Нет, все строки между строками, удовлетворяющими начальный и конечный маркеры
Регулярные выражения знаешь?
 Vladyslav
Через лямбда-функции
 Tishka17
Нет, все строки между строками, удовлетворяющими начальный и конечный маркеры
А колдовство с tee зачем?
Vladyslav
В файлах данных есть блоки текста, начинающиеся строками, условно, " begin " и завершающиеся, условно, строками " end ", от " begin " иногда надо пропустить N строк
Vladyslav
А колдовство с tee зачем?
Колдовство с tee - попытка изучить сложный тул из itertools в ситуации, когда и без него можно обойтись : )
ddd
В файлах данных есть блоки текста, начинающиеся строками, условно, " begin " и завершающиеся, условно, строками " end ", от " begin " иногда надо пропустить N строк
Напиши полностью задачу, от начала до конца, одним постом
Tishka17
Я так понял надо что-то типа
def block(file, start, end):
for line in file:
if start(line): break
for line in file:
if end(line): break
yield line
Vladyslav
Есть файл в сотни килобайт с разнотипными данными, в нём встречаются блоки строк, обрамлённых "начальной" и "конечной" строками, которые нужно немного профильтровать и распарсить. Причём иногда нужно взять только первое вхождение блока, а иногда последнее.
Vladyslav
Я так понял надо что-то типа
def block(file, start, end):
for line in file:
if start(line): break
for line in file:
if end(line): break
yield line
Да, что-то вроде, но для "последее" вхождение уже не так просто выглядит. Надо или через reversed, или как-то иначе
 quantum super position
зачем разделять (и вообще нужно ли это) сущности бд и бекенда?
Vladyslav
зачем разделять (и вообще нужно ли это) сущности бд и бекенда?
Это изначально файл с разнообразными данными. Как-то сильно усложняет перегонять всё через дополнительную БД
Tishka17
Да, что-то вроде, но для "последее" вхождение уже не так просто выглядит. Надо или через reversed, или как-то иначе
Последнее выглядит так:
data = None
while True:
prev = data
data = list(block(f, startfunc, endfunc))
if not data:
return prev
Vladyslav
Последнее выглядит так:
data = None
while True:
prev = data
data = list(block(f, startfunc, endfunc))
if not data:
return prev
Да, действительно, сейчас попробую внедрить эту реализацию, спасибо!
Tishka17
Можно добавить в исходный генератор проверку что блок был и исключение
Tishka17
Тогда поиск последнего будет без хранения двух блоков в памяти
Vladyslav
Пробую
Vladyslav
Классно : ) Сделал на базе ваших советов, но вот так
Vladyslav
https://pastebin.com/U7QyJTvq
Vladyslav
Работает супер! Спасибо : )
quantum super position
Можно добавить в исходный генератор проверку что блок был и исключение
Тишка, чего ты так не любишь f строки?
quantum super position
Я люблю и юзаю ф-строки
А, значит для подстановки данных в бд юзать ф строки - хуево?
Tishka17
А, значит для подстановки данных в бд юзать ф строки - хуево?
Для подставновки данных в любой язык разметки или программирования. В том числе в sql, json, xml, html
quantum super position
Vladyslav
О, раз тут зашло дело про форматные строки, можно ли как-то автоматически квотить все данные в такие строки или надо явно в них вызывать функцию квотирования?
 Александр
Anonymous
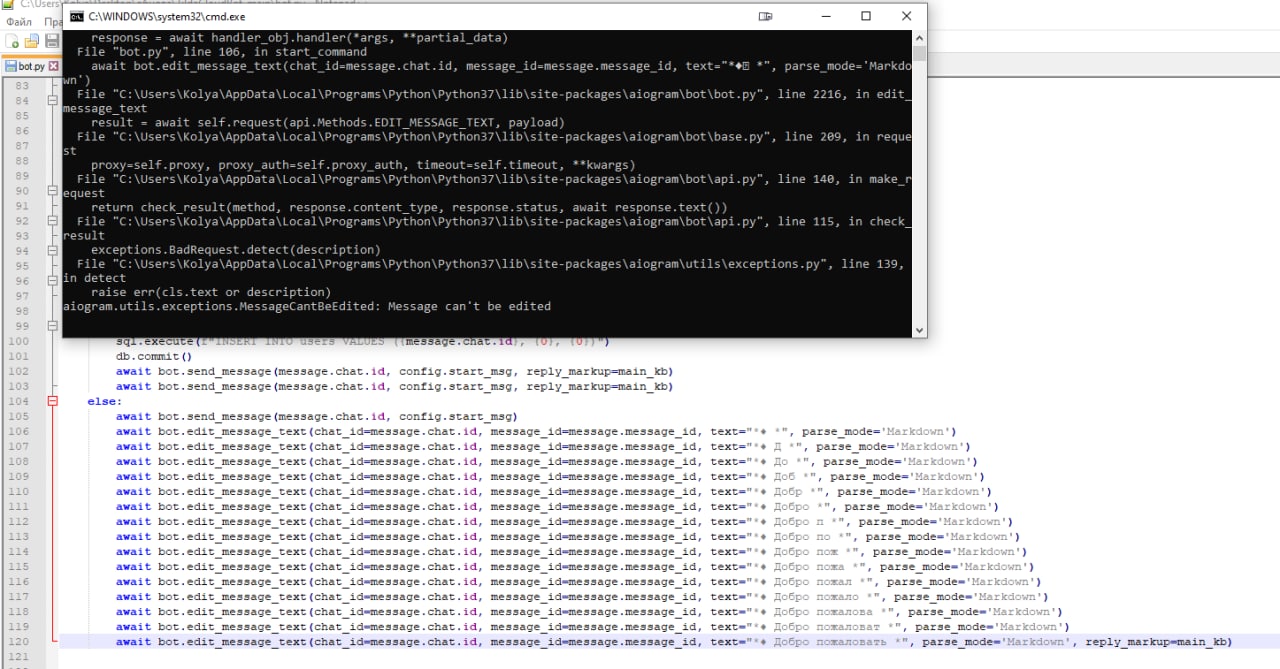 quantum super position
Anonymous
quantum super position
Чтобы люди помогли, а не стебались.
Потому что надо учить язык, а не сразу в тг ботов лезть
Anonymous
Потому что надо учить язык, а не сразу в тг ботов лезть
Я и пытаюсь, просто именно в этом направлении хочу
Александр
Sql injection, html Injection, xss
а, ну в этом плане вообще любая подстановка не годится, что f-string, что str.format, нет?
Tishka17
Александр
понял, я подумал отдельно f-строчки выделяешь 👌
evgeniy
https://pastebin.com/U7QyJTvq
Вроде задача звучала просто, а решение получилось сложное...
Я понял задачу так:
Есть файл с текстом, текст представляет из себя набор строк заканчивающихся \n, нужно найти блоки строк между условно begin\n и end\n и вывести первый или последний. Правильно? Такие задачи часто делают на`awk`.
Вообще, похоже на типичную задачу парсинга структурированного документа, типа xml или исходного кода. Есть открывающий тэг, есть закрывающий тэг, есть содержимое между ними.
Вопросы:
1) Между begin\n и end\n могут встречаться отдельные begin\n или end\n или вообще вложенные блоки?
2) Если есть begin\n, то всегда ли есть парный ему end\n и наоборот?
Vladyslav
Вроде задача звучала просто, а решение получилось сложное...
Я понял задачу так:
Есть файл с текстом, текст представляет из себя набор строк заканчивающихся \n, нужно найти блоки строк между условно begin\n и end\n и вывести первый или последний. Правильно? Такие задачи часто делают на`awk`.
Вообще, похоже на типичную задачу парсинга структурированного документа, типа xml или исходного кода. Есть открывающий тэг, есть закрывающий тэг, есть содержимое между ними.
Вопросы:
1) Между begin\n и end\n могут встречаться отдельные begin\n или end\n или вообще вложенные блоки?
2) Если есть begin\n, то всегда ли есть парный ему end\n и наоборот?
Евгений, спасибо за интерес к моей задаче : ) Да, блоки всегда обрамлены begin и end. Я бы сделал и на awk / sed, но как-то глупо было делать это из питона, если весь остальной анализ выполяется в питоне. Решение сложное, потому что в нём остался уже ранее использовавшийся рабочий фрагмент кода (в плохочитаемом функциональном стиле). Но условия работы кода позволяют оставить так.
Vladyslav
Фрагментов тоже обычно десятки и каждый обычно не превышает десятки табличных строк, так что экономить память тоже смысла не имеет.
Vladyslav
Что-то вроде : )
evgeniy
Там сбилось всё :)
evgeniy
Что-то вроде : )
Вот такой тест:
unneeded lines
unneeded lines
begin
one two three
one two three
one two three
end
begin
four five six
four five six
four five six
end
unneeded lines
unneeded lines
unneeded lines
begin
eight nine ten
eight nine ten
end
unneeded lines
unneeded lines
 Aragaer
collecting = False
for line in my_file:
if line.strip() == 'begin':
collecting = True
result = ""
continue
if line.strip() == 'end':
collecting = False
if need_first:
break
else:
result = ""
continue
if collecting:
result += line
Vladyslav
Да ну вас) Люди старались писали itertools, а вы всё в бейсик-стайл)
Vladyslav
collecting = False
for line in my_file:
if line.strip() == 'begin':
collecting = True
result = ""
continue
if line.strip() == 'end':
collecting = False
if need_first:
break
else:
result = ""
continue
if collecting:
result += line
Конкатенировать в строку - это жёстко
Vladyslav
Или в третьем питоне уже динамические строки?
 Denis
Они формально иммутабельные, но по факту там оптимизация есть на +=
Vladyslav
То есть, уже не убивается предыдущий объект и пересоздаётся новый?
Denis
Да, если на него никто больше не ссылается, происходит быстрое добавление в конец
Vladyslav
Как в списках что ли?
Vladyslav
Или realloc?
Aragaer
ну можно в список собирать и в конце сделать join
Vladyslav
ну можно в список собирать и в конце сделать join
join лишнее, я паршу каждую строку на значения
Aragaer
тем более
Aragaer
а про itertools - я слабо себе представляю как их тут прикрутить
Vladyslav
идеально было бы без списка прямо из итератора, но у меня не хватило мозгов
Vladyslav
ну да, не дойдя до конца итератора - не узнать, что это было последнее вхождение)))
Aragaer
ну вообще формулировка "первый либо последний" накладывает определенные ограничения, ага
Vladyslav
возможно, есть прикольные решения на базе reversed
Vladyslav
но это надо как-то реверсировать итератор "на лету", а я так не умею
Vladyslav
да и, думаю, reversed на файле уже читает весь файл в память
Aragaer
reversed тоже без волшебства - он требует пройти оригинальный итератор до конца по-моему
 SHADRIN
Парни что за феномен такой
Собираю программу в exe одним файлом работает а если папкой с либами не работает
Tishka17
Все что угодно
Tishka17
Но обычно наоборот
SHADRIN
Но обычно наоборот
Так вот так же думал скинул человеку а него все через ж получилось
И причём тот что 1 файлом у меня иногда ругается а у него как ласточка летает
evgeniy
Ха, у меня сейчас похожая фигня происходит - код на компе работает, в repl.it и ideone.com не хочет, хоть тресни. Чертовщина какая-то...
Tishka17
evgeniy
Заработало 😜! Оказалось в тестовом файле нехватало \n после последней строки. Причём я его добавлял вручную в repl.it - не помогало, добавил в виме и скопировал в repl - помогло.
evgeniy
@gehrmann2 Решил вашу задачу, на моём тесте работает.
https://repl.it/@Negamax/Blockparsing#main.py
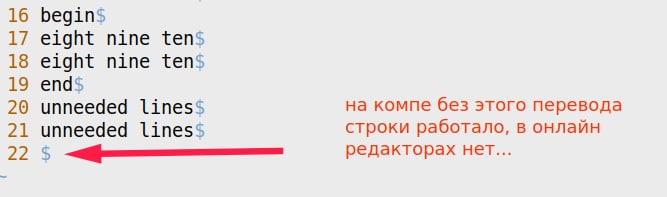 evgeniy
А я грешил на отступы табами, которые у меня вместо пробелов...
evgeniy
На компе у меня Python 3.6, в repl Python 3.8, может из-за этого вело себя по-разному?
evgeniy
Может и не в этом было дело, сейчас по всякому работает, не могу воспроизвести ошибку. Говорю же - чертовщина 😟.
 Ilya
Вопрос для знатоков Пайторча:
A[row_indices, colume_indices] += 1
где обе переменные держат набор индексов,надо сделать так, что если индексы повторяются, то и плюс 1 делался столько раз, сколько получается один и тот же индекс.