Вот какой это язык: il letto è lungo e comodo
$ ipython
In [1]: from langdetect import detect
In [2]: detect("il letto è lungo e comodo")
Out[2]: 'it'
 Anonymous


 Kirill
Спасибо сейчас буду проверять
Я тебе выше привёл решение со словарём где не важен язык - в словаре уже все языки сразу заложены будет.
♔ Azimjanovich
♔ Azimjanovich
Ojos по испански читается как охос.
Rojo - рохо
Нет мне не надо переводить тексты просто менять буквы
 Tishka17
Это не перевод
Tishka17
Ojos - глаза
Rojo - красный
Tishka17
Я лишь имел ввиду, что правила трансляции зависят от языка, а не только от алфавита
 Denis
Нейросеть сама догадается
Tishka17
Не думаю, что человек с ником Huevo захочет чтобы его транслитеровали по правилам английского языка. Это все таки Уэво
Anonymous
В итоге нужно было поставить r перед путём и CSV прочёлся
Anonymous
спасибо stackover, а местным партизанам незачёт)
 Humburglar
 garrip91
Добавил полный путь к папке "site-packages" в переменных средах Windows и всё равно cmd-шка не видит, например, virtualenv. Как решить эту проблему?
Mikhail
 uvicorn
garrip91
Scripts нужно было
У меня там давно стоит ссылка на Scripts и при этом не запускается virtualenv
uvicorn
Кстати, virtualenv задепрекейтили. Юзай venv
Tishka17
Когда?
garrip91
Venv тоже не помогает
garrip91
У virtualenv вообще есть файл-запускатор типа как у Django "django-admin.py"?
garrip91
Может, я хоть полный путь смогу указать
 genya
garrip91
Я даже продублировал пути, относящиеся к Python, из "Переменных сред пользователя" в "Системные переменные". И то не помогло
garrip91
А что самое интересное, команда "pip show virtualenv" у меня работает отовсюду, а команды, относящиеся к самому virtualenv, не работают
 tEAm-oFF
Добрый день, кто-нибудь знает функцию для удаления ботом всех сообщений в чате телеграма?
 Kirill
garrip91
Спасибо, ребят. Сам случайно исправил ситуацию
 Oleg
Привет вопрос по PIL rotate. Собственно о самом повороте при 90 и -90 градусов не могу понять почему при 90 градусов идет поворот против ч. стрелки, а -90 по часовой?
 Владимир
Kirill
У меня ещё один вопрос!
Там в тексте есть ссылка, этот ссылки не надо переводить кириллица, и что будет делать мне 😞🤦🏻♂
Это и есть задача программирования - придумать "что делать", и реализовать это в виде программы.
Вот и придумай как тебе определять, что какая-то часть текста - это ссылка. Подумай как ты это делаешь сам. Почитай спецификации про то как могут выглядеть ссылки, а как не могут. Напиши алгоритм, который разделить твой текст на ссылки и "не ссылки".
Владимир
Привет вопрос по PIL rotate. Собственно о самом повороте при 90 и -90 градусов не могу понять почему при 90 градусов идет поворот против ч. стрелки, а -90 по часовой?
Просто в тригонометрии углы тоже против часовой
Mr.Ca4
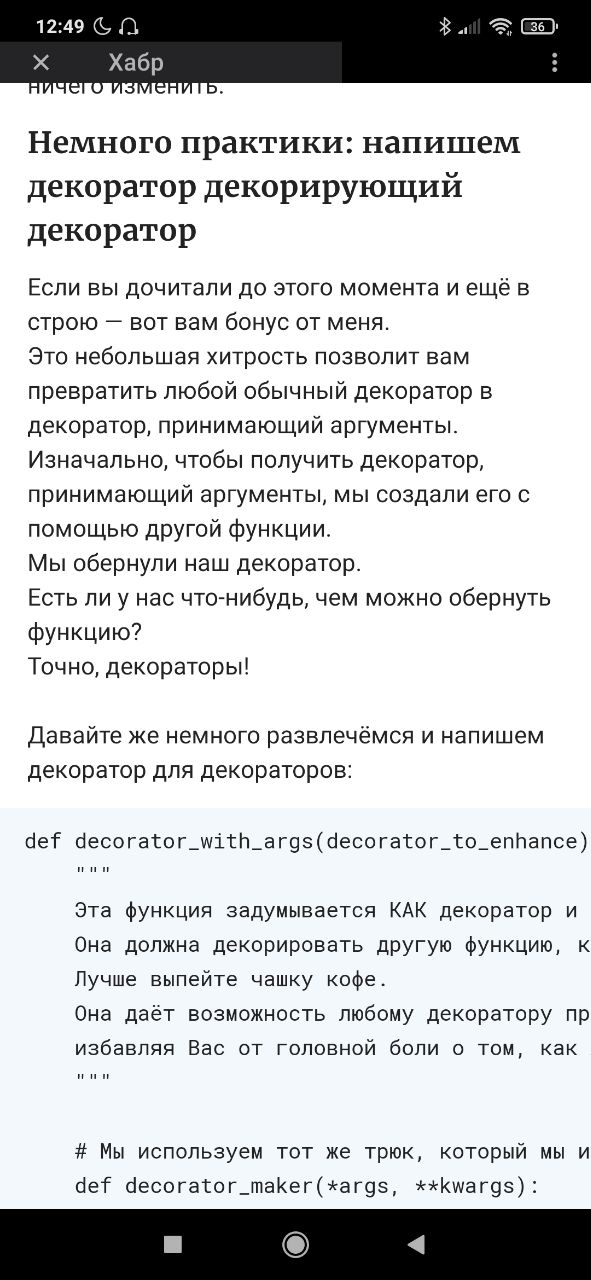
Добрый день. Подскажет может кто предназначение декораторов для декораторов и отличие от обычного декоратора, принимающего аргументы?
 Alex
Добрый день. Подскажет может кто предназначение декораторов для декораторов и отличие от обычного декоратора, принимающего аргументы?
яннп. что такое "декоратор для декораторов"?
Tishka17
Не вижу в конце статьи декоратора для декораторов
Tishka17
Давай сюда пример
Mr.Ca4
 Mr.Ca4
Там и пример есть
Tishka17
Ну им показалось, что это полезно
Tishka17
Декоратор - обычная функция, почему бы его тоже не декорировать
Alex
я чет нигде не увидел какого-то специфического использования.
Mr.Ca4
Декоратор - обычная функция, почему бы его тоже не декорировать
Просто чтобы аргументы прокинуть?
Mr.Ca4
Ну буду надеяться, что понял, спасибо!
Tishka17
Я говорю, я вообще очень редко декораторы юзаю
 Aragaer
я декораторы юзаю потому что иногда удобно
Tishka17
Я иногда декораторы вообще применяю через прямой вызов, а не через собаку
Ninja
Ребят, стоит задача - нужно сделать базу данных, в которой будет пара таблиц, 5-10 колонок. 200-300 миллионов строк. Если запихнуть это в sqlite на hdd, как оно будет работать? Или лучше выбрать чтото иное? (Работа с таблицей - в основном запись и селекты).
Tishka17
"в основном запись и селекты". А что ещё бывает?
 SHADRIN
 Amaro
нет. там они просто декорируют другую функцию-декоратор
Ну, если у тебя есть, например, декоратор для логов и декоратор для авторизации, то на какую-то функцию ты можешь повесить оба. При этом один декорирует исходную функцию, а другой уже декорированную.
Alex
Alex
и нет там вообще о другом речь была
♔ Azimjanovich
а как слияние массива
 denis ⛅️
ребят, надо делать перенаправление трафика так, чтобы клиент стучался сразу на новый сервак не проходя через перенаправлялку, как это сделать?
denis ⛅️
(общение клиента с серваком через вебсокет)
Роман
Всем привет. Помогите пожалуйста с dockerfile + python. Dockerfile: https://pastebin.com/csKkwBPq. Возникает такая ошибка ERROR: http://dl-cdn.alpinelinux.org/alpine/v3.12/main: temporary error (try again later)
WARNING: Ignoring APKINDEX.2c4ac24e.tar.gz: No such file or directory
ERROR: http://dl-cdn.alpinelinux.org/alpine/v3.12/community: temporary error (try again later)
WARNING: Ignoring APKINDEX.40a3604f.tar.gz: No such file or directory
 Андрей
https://dpaste.org/fNjT#L5 Программа ошибок не выдает, но расчёт времени не проводит, помогите, пожалуйста
 Gleb
 Игорь
Всем привет
 Valentina
☀️Вакансия
Senior Python developer (Django)
☀️О компании:
andersenlab.com
Международная аутсорсинговая IT - компания "Andersen" в поиске Senior Python разработчика!
☀️Зарплатная вилка
3000-3500 USD
☀️Тип работы
Полный рабочий день
☀️Тип занятости
Офис/удаленка
☀️Описание вакансии:
Проект - SaaS интеллектуальная платформа управления знаниями юридического и нормативно-правового характера.
Платформа автоматически отслеживает последние обновления в законах и нормативных актах, структурирует и обобщает информацию, чтобы упростить классификацию нужных документов.
Теперь юристам не нужно самостоятельно искать информацию об изменениях в законодательстве. Это экономит время и позволяет своевременно внедрять нововведения, а еще снижает риск упустить важные изменения и понести ущерб.
☀️Основные задачи:
Проект существующий, основными задачами для Вас будут разработка нового функционала и улучшение существующих возможностей платформы.
☀️Требования по позиции:
- опыт коммерческой разработки на #Python от 3 - 4х лет;
- опыт разработки на #Django Rest Framework;
- знание и опыт работы с #PostgreSQL, #Redis;
- опыт работы с #Linux системами;
- опыта использования Git;
- опыт написания unit тестов, участия в code review;
- опыт работы с применением Agile методологий;
- английский язык - уверенный 💡Intermediate и выше.
☀️Будет преимуществом:
- знание и опыт работы с Elasticsearch.
☀️Условия работы:
• Работау в быстрорастущей международной компании;
• Интересные масштабные проекты с использованием новейших технологий;
• Адекватный лояльный менеджмент, отсутствие бюрократии;
• Свободный релокейт между офисами компании;
• Прозрачная система профессионального роста и развития в компании;
• Возможность посещать мероприятия, которые способствуют личностному и профессиональному росту за счет компании;
• Яркая и интересная корпоративная жизнь;
• Возможность изучения английского языка прямо в офисе;
• Медицинское страхование со стоматологией для сотрудников;
• Комфортный офис с кухней и комнатой отдыха в центре города;
• Корпоративная скидочная программа;
• Различные дополнительные бенефиты.
📩 Контакты:
v.pashkouskaya@andersenlab.com
@Valentina_pashkovskaya
Skype: live:tabyti
Андрей
Вот рабочий
Андрей
Программа верно выполняется, но время не считает почему-то
GTR Network
Народ как лучше сделать..есть данные которые мы инициализируем в цикле например.
есть цепочка условий по которым эти данные нужно отфильтровать...это множество различных условия
как структурировать код чтобы не писать лапшу с ифами?...
Tishka17
GTR Network
ну типа условия вынести в функции и прогнать если хоть одна функция вернула false continue