 Evgeniy


то есть мне нужно, чтобы тестовые модули запускались независимо
 Tishka17
Ну, допустим у меня какая-то настройка в виде глобала. Я ее установил в одном тестовом модуле, и не хочу, чтобы она аффектила другой. При этом стоит защита от перезаписи этой настройки в рантайме
Допустим у тебя говнокод. Как не исправив его сделать чтобы он работал нормально?
 Alex
Ну, мне интересен механизм импорта. Поддерживаются глобалы в пайтесте или нет
у фикстур есть scope
Tishka17
 Anton
Допустим у тебя говнокод. Как не исправив его сделать чтобы он работал нормально?
а он может работать, но быть говнокодом
Tishka17
а он может работать, но быть говнокодом
Да. Но быть например не поддаваться тестировснию или расширению
Tishka17
Или работать только в фиксированных условиях
Anton
тесты не нужны, прод - мой тест \s
Anton
Или работать только в фиксированных условиях
ну фиксированые условия - правило питона. функция должна делать что-то одно, и она должна это делать хорошо. вроде так
Evgeniy
довольно херовая практика
ну такое, загромождать код передачами повсюду конфигов, с риском где-то случайно перезатереть конфиг
Alex
Tishka17
ну такое, загромождать код передачами повсюду конфигов, с риском где-то случайно перезатереть конфиг
Как раз риск без передачи
Tishka17
Распространенная практика, джанго например, или пандас
Ну в джанге куча прослоек чтобы это не так аффектило твой код и теств
su
ребята если речь про pytest, то их можно выполнять раздельно по файлам указав в качестве командной строки аргументы и поэтому нехер устраивать между модулями связи и зависимости - чтобы они падали при тестировании фичи?
Evgeniy
В пандасе что настраивать?
https://pandas.pydata.org/pandas-docs/stable/reference/api/pandas.set_option.html
Alex
ребята если речь про pytest, то их можно выполнять раздельно по файлам указав в качестве командной строки аргументы и поэтому нехер устраивать между модулями связи и зависимости - чтобы они падали при тестировании фичи?
да в принципе все модули с тестами должны быть независимыми
Kirill
Говно какое-то
Tishka17
https://pandas.pydata.org/pandas-docs/stable/reference/api/pandas.set_option.html
Выглядит как какие-то глобальные дефолты, которые можно локально не юзать
Kirill
Просто вырезали половину инфы, убрали отступы и сказали "удобно"
 Степан
._.
Anton
С 20 раза понял как это читать
не советуется новичкам юзать, или если не умеешь читать ванильный трейсбэк. мне удобно, в любой момент можно посмотреть нормальный вид.
 Philipp
Привет, ситуация такова - у меня есть несколько сервисов в контейнерах:
- MongoDB - просто контейнер с базой;
- db_service - контейнер с API которая принимает файлы (зипованные JSON), распаковывает, валидирует, ищет копии, сохраняет в MongoDB GridFS, версионирует и т.п.
- conversion_service - контейнер с API, которая запускает задачи Celery, проверяет их статус и отдаёт результат.
- celery_worker - в этом сервисе выкачиваются указанные файлы из db_service и происходит конвертация в нужный формат (stp, stl и т.п.).
- Redis - контейнер, использующийся как message broker.
- nginx_proxy - контейнер, в котором крутится nginx, между собой все сервисы общаются только через него, во внешний мир выставлен тоже только он.
После сохранения файла или его апдейта, db_service автоматически дёргает сервис конвертации, так как необходимо иметь определённые форматы уже сконвертированными в момент когда пользователь захочет получить их.
Сейчас между conversion_service и celery_worker есть расшаренный докеровский volume. Запрос о конвертации приходит в conversion_service, тот запускает задачу, celery_worker выкачивает файл из db_service, конвертирует, помещает результат в этот volume. Пользователь проверяет статус задачи, если конвертация прошла, то забирает результат через эндпоинт в conversion_service.
Меня это не совсем устраивает, я думаю, что эти файлы должны отдаваться напрямую nginx'ом. Но, меня смущает, что в таком случае непонятно, как решать, имеет право человек получить данный файл или нет? И вообще, есть мысль перестать хранить файлы в GridFS, складировать в папке в том же зипованном виде, а в MongoDB оставить только мета-данные. Помогите понять, что не так сейчас, что не так может быть в будущем? Что искать в доках nginx по этой теме? Может на примете есть у кого статьи или другие материалы по схожим проблемам?
Kirill
не советуется новичкам юзать, или если не умеешь читать ванильный трейсбэк. мне удобно, в любой момент можно посмотреть нормальный вид.
Там два абсолютно разных файла _local.py вывели так будто это один и тот же
Kirill
Никому не рекомендуется такое юзать
Kirill
Ну так без контейнера проще
Anton
Никому не рекомендуется такое юзать
мне удобно, для относительно малых проектов. там можно в конфиге включить полный путь к файлу, если путаешься. много настроек, в общем
Kirill
Мы тут взрослые большие проекты пишем
Kirill
А для малых я бы вообще ничего не ставил
Kirill
Но если ты держишь базу в контейнере и контейнер падает, то ты просто теряешь все данные
Philipp
Anton
Мы тут взрослые большие проекты пишем
ну у всех есть side projects, конечно на проде такое нельзя. но удобно же, когда ты один работаешь над чем-то
Kirill
С чего бы нет?
 std::mpa 🇺🇦
Kirill
Единственный способ сохранить данные это сделать какой-нибудь волум в докере
Philipp
mongo image автоматом всё себе настраивает, даже руками ничего не надо делать.
Kirill
А с его бы да? Ты сам-то пробовал?
С того что контейнер по дефолту не сохраняет ничего вне своей файловой системы
Kirill
mongo image автоматом всё себе настраивает, даже руками ничего не надо делать.
Не настраивает он ничего
Kirill
Волумы указываются ручками в cli докера или конфиге докер композа
Kirill
Для контейнера странно без ведома юзера что-то сохранять на хост машине
Philipp
Для контейнера странно без ведома юзера что-то сохранять на хост машине
Чего спорить-то? Вот, подними, запиши что-нибудь и потуши контейнер, потом подними и посмотри.
https://hub.docker.com/_/mongo
Kirill
Если ты пользуешься конфигом докер композа который они сами выложили то логично что все сохраняется
Philipp
Я уже с пол-года так разработку веду, а ты пытаешься меня убедить, что это не так?
Philipp
Если ты пользуешься конфигом докер композа который они сами выложили то логично что все сохраняется
Вручную подними через docker run, не нужен тебе никакой композ для проверки.
 Denis
Чего спорить-то? Вот, подними, запиши что-нибудь и потуши контейнер, потом подними и посмотри.
https://hub.docker.com/_/mongo
Он это внутрь контейнера пишет же
Denis
При пересоздании оно сбросится. Например, про docker-compose down
Kirill
Он просто не разбирается, пользуется чем дали и у него все работает
Alex
Волумы указываются ручками в cli докера или конфиге докер композа
VOLUME в докерфайле не? понятно что он одноразовый, но вообще-то volume указывается не только при старте контейнера
Denis
Ладно, при down не сбросится, обманул
 Radaram
Всем привет, вопрос по кафке)
использую в качестве клиента кафки python любу kafka-python и вопрос
Нужно ли подключаться к кафке и создавать объект класса KafkaProducer при запуске апи сервиса или всегда создавать новый инстанс класса KafkaProducer перед тем как отправить в топики сообщения, для моего случая в момент когда приходит запрос в апи?
Kirill
VOLUME в докерфайле не? понятно что он одноразовый, но вообще-то volume указывается не только при старте контейнера
VOLUME в докерфайле не делает то же самое
Kirill
Он позволяет создать волум с уже указанным путем для контейнера, а на хосте ты все еще должен указать сам
Kirill
Позволять контейнеру делать те волумы что он хочет небезопасно
Kirill
Особенно учитывая что докер работает под рутом обычно и может писать что-то в системные директории
Denis
У меня не под рутом
Kirill
У меня всегда рут просил
Alex
VOLUME в докерфайле не делает то же самое
VOLUME делает ровно то что описано, создает volume при старте контейнера. как будет создан этот volume зависит от типа storage указанного в докер демоне.
Ты слегка путаешь bind mount с volume.
 Midnight
всем привет )))
Alex
Понял
По-умолчанию обычно используется используется local драйвер, который создает директорию в <data-root>/volumes/<volume-name>/_data и монтирует ее по пути указанному в VOLUME докерфайла.
Степан
 Степан
Кто специалист по beautiful soup?
Alex
Понял
Можешь запустить например postgres контейнер без параметров и проверить
docker run --rm --name test -e 'POSTGRES_PASSWORD=pswd' postgres
docker inspect --format='{{json .Mounts}}' test | jq
Степан
Степан
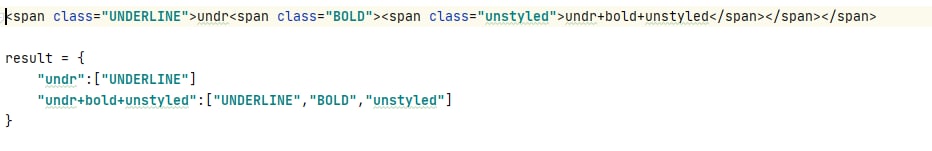
Дело в том что текст-то один, и может быть разбросан по всей строке.
 Не выходи из комнаты.
Столкнулся со следующей проблемой.
Есть веб-приложение, написано на фласке. Поместили его в докер контейнер.
Используем также эластиксерч, на него отдельный под.
Всё это обвязано кубернетесом.
Каждый раз после билда фласка, он не видит индексы эластиксерча, пока не рестартануть эластик и фласк.
В чем может быть проблема?