А что в логе сервиса который задания добавляет? И что говорит мониторинг очереди?
Задания очереди, уместившиеся в кол-во concurrency - success, мониторинг очереди - все потоки idle. Вроде, как будто все ок прошло, и ожидаются новые задания для потоков. После рестарта супервизора как ни в чем не бывало подцепляются оставшиеся задания
 P.


 Misha
 Evgeniy
Это как?
Допустим, мы строим обратный индекс по словам. Идея в том, что мы по ключу в виде слова храним некий список документов, в которых оно встречалось, и число упоминаний. Когда твоя задача найти слово на наборе документов, ты не проходишься по всему набору, а вытягиваешь список упоминаний по слову.
Далее, тебе запрос может прилететь не в виде одного слова, а в виде группы слов. Это фактически задача из теории множеств, тебе нужно отдать пересечение множеств упоминаний каждого слова из набора. То есть берешь список упоминаний 1 слова, список упоминаний 2 слова и тд, и берешь из них только те документы, которые фигурируют во все перечисленных списках.
Чтобы отсечь мусор, заранее составляешьь список стоп-слов, которые не учитываются в запросах: всякие предлоги, союзы и тд + специфичные для предметной области слова. Для авито, к примеру, будет бессмысленно учитывать в поисковом запросе слово "объявление".
И также не забудь все слова перед поиском, и все ключи в БД, привести к нормальной форме. На питоне для этого есть либы вроде pymorphy2.
Когда по итогу ты получаешь список документов, тебе надо его еще отранжировать, но это отдельная история.
 Айрат
Для твоего кейса достаточно передать в connect QtWidgets.qApp.quit (без скобок)
это знаю, просто разобраться хотел
Evgeniy
Это как?
для ускорения работы обратного индекса лучше его хранить в БД типа ключ-значение, скажем в редисе
 Tishka17
нет
Тогда расскажу так. Типичное веб приложение работает так:
1. Есть реверс прокси. Его задача терминировать клиентов, обслуживать их тормоза, разбираться когда клиентов много и т.п. Это nginx/haproxy/traefik
2. Есть сервер раздачи статики. Он умеет хорошо раздавать файлы которые не меняются. Это может быть внешний CDN или тупо тот же nginx, что в пункте 1
3. Есть веб-сервер приложения. Тот сервер, который запускает код. Он обычно плохо работает как 1 и 2, но умеет дёргать твой код. Это может быть apache httpd, apache tomcat, php-fpm, gunicorn, uwsgi, uvicorn и т.п. Они отличаются тем, какой код они умеют запускать, как с этим кодом общаются и т.п.
4. Системный менеджер сервисов. Та штука, которая стартует любые приложения на сервере, будь то база данных, веб-сервер, почтовый сервер или ещё что. В современных Линуксах это systemd. Он же следит, что упало и перезапускает.
Естественно, тут не рассмотрен вартант масштабирования на кучу серверов.
Evgeniy
Ну у меня есть словарь хороших слов, так что стоп слова не нужны
Это еще проще, значит у тебя обратный индекс будет маленький
Evgeniy
Также для ускорения поиска можешь юзать как ключи не сами слова, а хеш-суммы слов
Evgeniy
По числам бд эффективнее ищет скорее всего
Tishka17
Также для ускорения поиска можешь юзать как ключи не сами слова, а хеш-суммы слов
Так у меня не совсем слова, а словосочетания
Evgeniy
Ты делаешь поиск по каждому слову и отдаешь пересечение множеств документов по каждому из них
Tishka17
Я пока собирался залить все 500к словосочетаний в pyahocorasick, он внутри себя построит префиксное дерево. Дальше я через него прогоняю документ и выхлоп пишу в БД (найденные фразы)
Evgeniy
Я пока собирался залить все 500к словосочетаний в pyahocorasick, он внутри себя построит префиксное дерево. Дальше я через него прогоняю документ и выхлоп пишу в БД (найденные фразы)
Такая предобработка не оч в ситуации, когда список хороших слов может со временем расширяться, например
Evgeniy
Придется все переиндексировать
P.
Капец, как вы в голове держите вот это вот все..? Я с одним сельдереем справляюсь еле-еле. Выражаю уважение без рукопожатий )
Dima
Ищу двух респондентов для 10-минутного usability-тестирования. Лучше всего, если вы только начали обучение, но необязательно. Речь пойдет о новом проекте, онлайн-курсах по Python с оплатой после трудоустройства. Нужно будет созвониться, я попрошу вас выполнить один из сценариев (например, найти такой-то курс или решить такую-то задачу) и рассказать, как бы вы с ним справлялись. Важна достоверность, как бы вы решали задачу в реальных условиях. Идеально, если у вас будет возможность пошарить экран, но необязательно. С вас — 10 минут времени, с меня — результат исследования и информирование о выходе нового продукта и благодарочка! Пишите плз здесь или в личку
Tishka17
Такая предобработка не оч в ситуации, когда список хороших слов может со временем расширяться, например
А в твоём кейсе не надо переиндексировать?
Evgeniy
Ты по мере добавления новых документов правишь только участки индекса
Tishka17
Так ты только что сказал про добавление слов
Evgeniy
Так ты только что сказал про добавление слов
Если изначально делать общий индекс со всеми словами, то не надо
Evgeniy
Если неполный, но да, придется пройтись по всем докам еще разок
Tishka17
Если изначально делать общий индекс со всеми словами, то не надо
Вообще со всеми что встретились в документах?
Evgeniy
Вообще со всеми что встретились в документах?
Да, со всеми в нормализованной форме (это снижает количество, всякие падежи и тд отбрасываются), кроме стоп слов
Tishka17
Звучит как дохрена
Evgeniy
В реальной жизни люди используют мало слов
Tishka17
Хочешь сказать, оно будет слабо отличаться от словаря?
Tishka17
Ну от целевого словаря
Evgeniy
Питоновский
Evgeniy
Ток в бд
Tishka17
Да я сейчас абстрактно от языка
Evgeniy
Это тезарус
Evgeniy
Хуйня в конце умных книг, где перечисляются слова и номера страниц, где они упоминались
Tishka17
Звучит как изобретение эластика
 darkor
Использую pyrogram (НЕ СПАМЛЮ инвайтами, рекламой и тд).
Юзер-бот должен реагировать на декораторы.
А раз в день должен выполнять 2 функции.
В доках написано что лучше использовать idle() для декораторов (https://docs.pyrogram.org/api/methods/idle?highlight=idle)
А в примерах к использованию либ на кроне приведены другие способы запуска юзер-бота (app.run() и with app:) (в тех же доках) (https://docs.pyrogram.org/topics/scheduling?highlight=asyncio#using-apscheduler)
Как лучше это сделать? (как использовать cron + pyrogram)
Evgeniy
Звучит как изобретение эластика
Ага, просто если в проекте уже есть бд, это -1 инструмент, который надо поддерживать и тд
 ESV
Привет. Как через пип установить не всю либу, а только часть, например, sklearn.covariance?
Tishka17
Ага, просто если в проекте уже есть бд, это -1 инструмент, который надо поддерживать и тд
В проекте пока ничего :)
Tishka17
Tishka17
Привет. Как через пип установить не всю либу, а только часть, например, sklearn.covariance?
Пип ставит пакеты так, как их автор выложил
Evgeniy
Привет. Как через пип установить не всю либу, а только часть, например, sklearn.covariance?
На гите найти проект и выдрать кусок кода. Не сработает, если там сишные биндинги.
darkor
А чем спамишь? :))
так не спам))
(предложения ответить на несколько вопросов, а кидаю вопросы только если юзер ответит "да")
Tishka17
так не спам))
(предложения ответить на несколько вопросов, а кидаю вопросы только если юзер ответит "да")
Так, погоди. Ботапи тебя чем не устроило?
Evgeniy
Эластик оверкилл
darkor
Так, погоди. Ботапи тебя чем не устроило?
принципиально надо писать первым (спорил несколько дней, поднял цену, а заказчик ни в какую, и вот....делаю...)
ESV
Пип ставит пакеты так, как их автор выложил
Если просто удалить ненужные после установки? В какой каталог по дефолту ставится?
Tishka17
принципиально надо писать первым (спорил несколько дней, поднял цену, а заказчик ни в какую, и вот....делаю...)
Отвратительно, уйди с глаз, пока бан не выдал
 Dmitriy
 Igor
Tishka17
Ну будет же какая-то БД
Так. А теперь вопрос: вот я проиндексировал какие есть слова в документе. Получил что там 500 слов. Как теперь отфильтровать их на пересечение со словарем в 500к слов? :)
Evgeniy
Tishka17
Че за словарь в 500к?
Так у меня есть словарь терминов. Из них в документе встречается десяток. Остальное - просто текст. Мне надо их искать только
ESV
Зачем?
Чтоб меньше весила. Хочу перенести всю папку питона с либами в проект, чтоб его из-под шарпа запускать.
Tishka17
Чтоб меньше весила. Хочу перенести всю папку питона с либами в проект, чтоб его из-под шарпа запускать.
И сколько ж ты планируешь сэкономить? ;-)
Tishka17
Чтоб меньше весила. Хочу перенести всю папку питона с либами в проект, чтоб его из-под шарпа запускать.
В общем, чтобы что-то вырезать, тебе надо разобраться как работает либа, которую ты режешь. И скорее всего у тебя выйдет сэкономить только пару кило
ESV
Tishka17
Пойду почитаю лучше про полнотекстовый поиск в постгресе :)
Evgeniy
Так у меня есть словарь терминов. Из них в документе встречается десяток. Остальное - просто текст. Мне надо их искать только
Берешь поисковый запрос. Отбрасываешь стоп-слова (в твоем случае отбрасываешь все слова, которые не в списке нужных). По оставшемуся списку слов делаешь запросы через обратный индекс.
Evgeniy
Прост это привязка к постгресу
 Alex
Пойду почитаю лучше про полнотекстовый поиск в постгресе :)
Закину 5 копеек. Я когда разбирался с эластиком искал примеры его использования и нашел в т.ч. что его использовали на сайте джанги. А потом они перешли для полнотекстного поиска на постгрес.
Tishka17
Берешь поисковый запрос. Отбрасываешь стоп-слова (в твоем случае отбрасываешь все слова, которые не в списке нужных). По оставшемуся списку слов делаешь запросы через обратный индекс.
Ну и мы приходим обратно к проблеме обновления словаря
Anonymous
 udsijxvkekwk
 Владимир
Вот прям ровно это же. Видимо другой спрашивал
Поищи по чату или в бегиннерс
С другой стороны не вижу проблемы вывести
Tishka17
Владимир
 Alexander
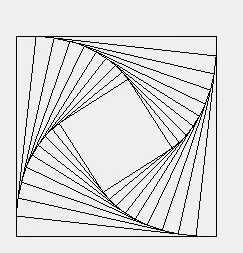
Квадраты масштабируется с заданным шагом, и поворачивается с заданным шагом