 Oleg


Ребята, кто может коротко сформулировать чем отличаются в множествах update от add?
 а хто
Эдд добавляет элемент, апдейт берет из другого сета
 Demian
Я лимит не помню в тг
там есть messagequeue на этот вариант, небольшая обертка и сама всё в очередь распихивает
а хто
Ну тогда зашибись
Oleg
a = {1, 2}
a.update('apple')
print(a)
Demian
напомните бота который исолняет скрипт прямо в телеге?
 Andrey
питонский кот? могу лиспового дать )
Demian
питонский кот? могу лиспового дать )
нет, был для питона. Периодически используют его тут и в бегиннерсах
Andrey
а в чем смысл? можно же в онлайн-интерпретаторе и ссылку сюда дать. или так нагляднее когда бот?
а хто
Нагляднее
Oleg
Эдд добавляет элемент, апдейт берет из другого сета
я так понимаю разница у них, что add добавляет элементы хэшируемых типов, а update не хэшируемых типов
Oleg
может кто поправит
Oleg
но с другой стороны str хэшируемый, а update c ним работает
Oleg
в общем HELP )) запутался )
Oleg
есть ещё вариант, что update вообще пофиг на тип
а хто
Нет, апдейт добавляет из списка/сета чего-то итерируемово с элементами так сказать внутри, а эдд конкретно добавляет то, что ты добавил
а хто
Типо если сделать
a.update("apple")
То выйдет
{"a", "p", "l", "e"}
А с эддом
{"apple"}
Oleg
причём тип должен быть у add обязательно хэшируем, ибо tuple (1,2) он добавит, а вот list [1,2] будет исключение
а хто
Да в Сетах все хешируемым должно быть в принципе
а хто
Интересно, как это там реализовано
а хто
Контейнеры какие-то или еще че
 Андрей
Что именно?
Андрей
set?
а хто
Ну запуск кода изолированный
Андрей
А
Хз
а хто
А то я в прошлый раз когда надо было сделать возможность скрипты безопасно выполнять юзерские делал свой интерпретатор паскалепитона
а хто
На расте четкая тема есть для этого блин RustPython или как-то так
а хто
Ваще кайфово контролируемый интерпретатор питона
а хто
А на питоне прям тонко настраиваемого ничего не нашел
KhSV
Работаю с деревьями решений sklearn: DecisionTreeClassifier. Под капотом модели деревья реализованы следующим образом: деревья однозначно идентифицируются целыми числами и имеются следующие характеристики представляющие их взаимосвязь графов:
• children_left = np.array([1, -1, 3, 5, -1, -1, -1]) # индексы левых потомков
• children_right = np.array([2, -1, 4, 6, -1, -1, -1]) # индексы правых потомков
• feature = np.array([1, -2, 2, 3, -2, -2, -2]) # номер сравниваемой колонки входящей инфы
• threshold = np.array([0.8, -2, 0.7, 4.2, -2, -2, -2]) # величина сравниваемого значения
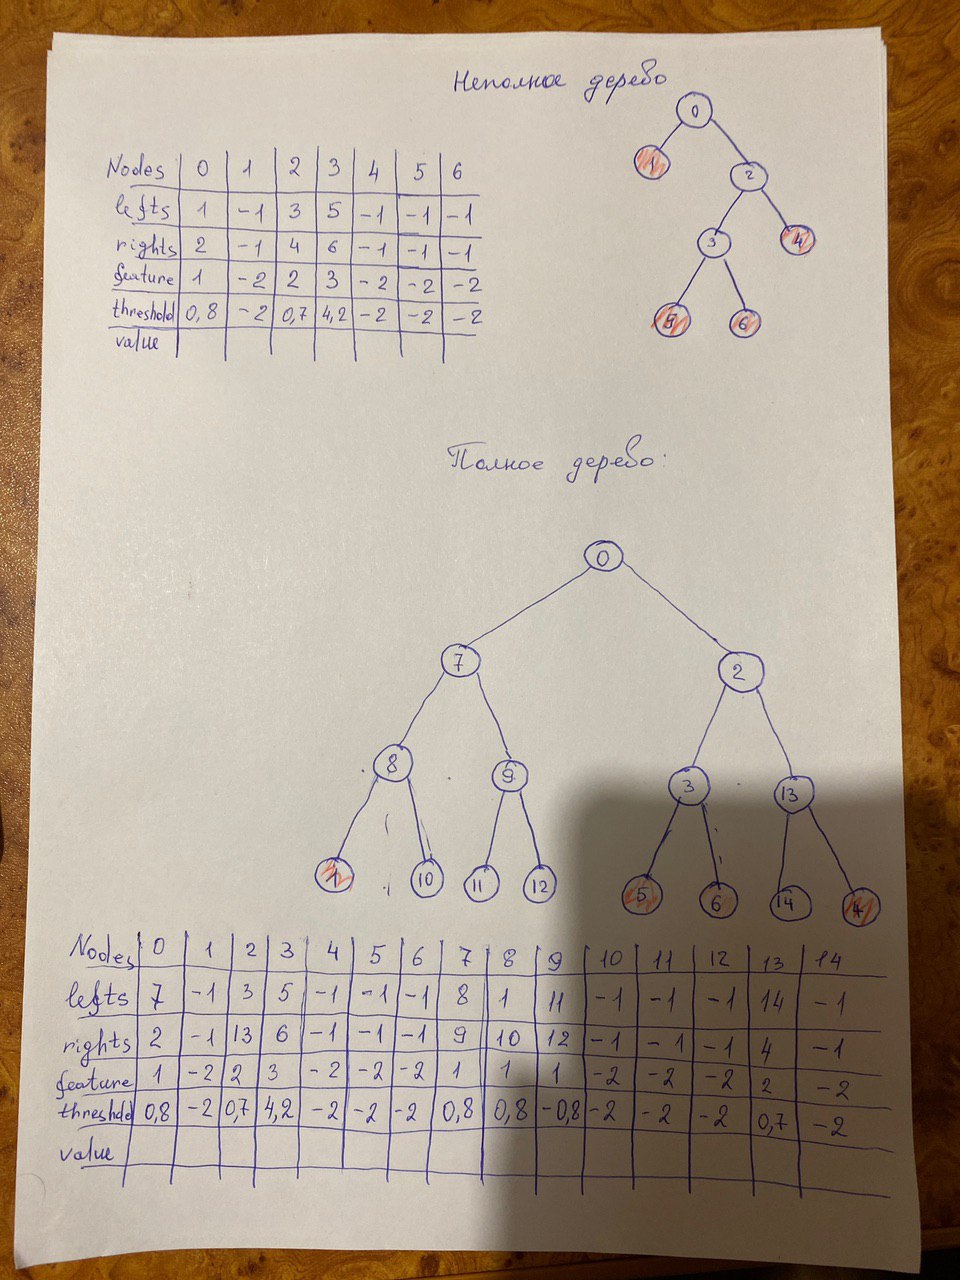
Параметры выше представлены в виде numpy массивов: на нулевой позиции находятся характеристики нулевой (корневой вершины), то есть левый потомок имеет индекс вершины - 1, правый - 2, индекс сравниваемой колонки - 1, значение с чем сравниваем 0,8. Числа -1 и -2 в массивах намекают на то, что эти вершины являются висячими узлами (далее по тексту - листья). Уже написан большой кусок кода, принимающий на вход полное дерево. И задача, за помощью с которой я обращаюсь к сообществу заключается в приведении неполного дерева к полному .
Нужно реализовать функцию которая на вход принимает дерево и глубину, к которому надо это дерево привести. Алгоритм работы следующий:
1 Найти количество вершин полного дерева, по сумме элементов геометрической прогрессии: 2*(2**depth - 1) + 1
2 Подготовить соответствующие параметры для заполнения полного дерева: children_left, children_right, feature, threshold. Длина массивов каждого из которых равна длине вершин полного дерева - 1 (2*(2**depth - 1))
3 Найти все листья;
4 Найти к какой глубине соответствует каждый лист;
5 Итерироваться по листьям и до тех пор пока не достигнута требуемая глубина, создать новую вершину и прицепить к нему лист (если левый - то левому, правый - правому). Индекс новых вершин начинать с количества вершин неполного дерева - 1
6 Новая создаваемая вершина копирует свойства родителя листа; Картинка дерева:
KhSV
 Denis
KhSV
@bladdon
Есть написанный код для своего классификатора, который работает с полным деревом
Dmitry
Кто что скажет про PyQt? Как инструмент для создания десктопных приложений пойдет?
а хто
Да пойдет в принципе, с другой стороны, нужно ли оно на питоне?
 Evgeniy
Кто что скажет про PyQt? Как инструмент для создания десктопных приложений пойдет?
Не советую делать десктопные приложение, мобилки захватили мир
а хто
Как неплохой вариант можно интерфейс сделать тупо сайтом на локалхосте
а хто
Но тут зависит от приложения
 A🐊🇺🇦
Не советую делать десктопные приложение, мобилки захватили мир
Есть задачи, которые не перейдут на мобилки 💁🏻♂️
Andrey
интерфейс то можно )) задача крутится на кластере, управляется с мобилки ))
Evgeniy
Кстати да
Evgeniy
+ скоро все кластера будут на базе мобилок
Evgeniy
На армах то бишь
Anonymous
Кто что скажет про PyQt? Как инструмент для создания десктопных приложений пойдет?
подойдет
он для этого и создавался
 Alex
Кто что скажет про PyQt? Как инструмент для создания десктопных приложений пойдет?
Есть еще PySide2, от разработчиков Qt.
Мало чем отличается от PyQt. Самое большое отличие — это лицензия.
 Sergey
Добрый день!
```coordH = coordsline[2]
coordsline[2] = coordH + random.uniform(0,randRange)
dataArray.append(coordsline)
coordsline[2] = coordH + flHeight - random.uniform(0,randRange)
dataArray.append(coordsline)```
Coordsline - список из трех элементов float
Как должно быть: к 3-ему элементу списка Coordsline добавляем рандомное значение и заносим этот список в dataArray, повторяем со списком то же самое, но в третем элементе добавляем константу flHeight. То есть должен получиться список из двух списков, где третьи элементы разные. Но они получаются одинаковыми. Подскажите ошибку.
Sergey
под каждую операцию создать свою копию?
 Amaro
под каждую операцию создать свою копию?
>>> a = [1, 2, 3]
>>> b = a
>>> b[2]=7
>>> a
[1, 2, 7]
>>>
Amaro
под каждую операцию создать свою копию?
>>> a = [1, 2, 3]
>>> b = a.copy()
>>> b[2] = 7
>>> a, b
([1, 2, 3], [1, 2, 7])
>>>
Sergey
 Ruslan
Камрады, в браузере делаю запрос
http://localhost:8004/services/8a2018c4-621b-4c10-9ce1-f3f5779c6fa9/?city=msk&subway=polyanka&subway=tverskaya
А в отладчике вижу только: request.path_qs = '/services/8a2018c4-621b-4c10-9ce1-f3f5779c6fa9/?city=msk&subway=tverskaya'
Должно же два значения для subway прилетать? Или надо какой-то режим включить?
Andrey
просто любопытно - у тебя на локалхосте крутится сервер, знающий про тверскую?
а хто
 Kirill
 Tishka17
Anonymous
просто любопытно - у тебя на локалхосте крутится сервер, знающий про тверскую?
аха да, это забавно выглядит
Anonymous
Камрады, в браузере делаю запрос
http://localhost:8004/services/8a2018c4-621b-4c10-9ce1-f3f5779c6fa9/?city=msk&subway=polyanka&subway=tverskaya
А в отладчике вижу только: request.path_qs = '/services/8a2018c4-621b-4c10-9ce1-f3f5779c6fa9/?city=msk&subway=tverskaya'
Должно же два значения для subway прилетать? Или надо какой-то режим включить?
в один вывод два варианта одного параметра
Anonymous
какая там логика
Alex
Камрады, в браузере делаю запрос
http://localhost:8004/services/8a2018c4-621b-4c10-9ce1-f3f5779c6fa9/?city=msk&subway=polyanka&subway=tverskaya
А в отладчике вижу только: request.path_qs = '/services/8a2018c4-621b-4c10-9ce1-f3f5779c6fa9/?city=msk&subway=tverskaya'
Должно же два значения для subway прилетать? Или надо какой-то режим включить?
можешь хоть вопрос нормально сформулировать?
Alex
что за сервер, как ты URL query пытаешься парсить, как проверяешь и т.п.
Anonymous
можешь хоть вопрос нормально сформулировать?
вопрос почему у него вместо двух запроса по двум subway возвращается по одному
Alex
Alex
вопрос почему у него вместо двух запроса по двум subway возвращается по одному
ответ: потому что он что-то сделал неправильно.
Amaro
вопрос почему у него вместо двух запроса по двум subway возвращается по одному
Вариант ответа: он пишет на пхп древнем и там надо [] добавлять...
Alex
Чтобы получить ответ вопрос надо строить так: у меня питон версии Х, есть П, версии М, мне нужно от него Й, я проделал Ё, я гуглил и читал про Б, С, но не получается, Ы. Без выполнения этих примитивных условий необходимых вопрошающему и остальным ответов не будет. И нехуй ныть.
Anonymous
Чтобы получить ответ вопрос надо строить так: у меня питон версии Х, есть П, версии М, мне нужно от него Й, я проделал Ё, я гуглил и читал про Б, С, но не получается, Ы. Без выполнения этих примитивных условий необходимых вопрошающему и остальным ответов не будет. И нехуй ныть.
можно начать с малого, и усложнять по мере необходимости
Anonymous
где русский проебал?