 Denis


Можно пандас, лично я без него делаю
 Ilya
А тут ещё думать надо о чем-то кроме простого использования бд?
 Андрей
Да
Бд ненужная прослойка и 500к строк питоном проще обработать
Андрей
И ручками иногда туда проще залезть, чем скл запрос написать
Андрей
А то ведь ДОЛГО
Ilya
Да сфига
Ilya
Понел
 Alex
А тут ещё думать надо о чем-то кроме простого использования бд?
почитай чат за сегодня. Один кадр днем показывал код бота где данные хранятся в файлах. Каждое обращение к хендлеру это open().read()
 Tishka17
Я за минуту с телефона написал два скуэл запроса. А ему с компа долго
 tfhx8
как это будет выглядеть с редисом?
Ilya
почитай чат за сегодня. Один кадр днем показывал код бота где данные хранятся в файлах. Каждое обращение к хендлеру это open().read()
О, это я во время, когда только запустили ботов в тг
Denis
Зачем в редисе хранить 20 мб файл?
tfhx8
Я за минуту с телефона написал два скуэл запроса. А ему с компа долго
если брать sqlite оно сможет 500запросов в с легко делать с поиском?
Tishka17
А с редисом не так удобно иерархические данные хранить
Ilya
Я за минуту с телефона написал два скуэл запроса. А ему с компа долго
А ещё автоклмплит который дополняет операции и название колонок
Tishka17
если брать sqlite оно сможет 500запросов в с легко делать с поиском?
Тебе же по первичному ключу надо доставать
tfhx8
А ещё автоклмплит который дополняет операции и название колонок
что автокомплит будет работать в консоли?
Tishka17
если брать sqlite оно сможет 500запросов в с легко делать с поиском?
У тебя 500rps обрабатывает один сервер?
Tishka17
Мне кажется тут проще кэшировать через nginx
Tishka17
Но 500рпс таких тупых скулайт выдержит лучше чем файл
Ilya
А вообще
tfhx8
У тебя 500rps обрабатывает один сервер?
мне питоновским скриптом надо поулчать конкретную строкуиз этого файла просто, все как бы)
Ilya
Тебе блин прям критична лишняя секунда ручного редактирования? Втф
Ilya
Или тебе надо 500рпс в ручную делать?
Denis
мне питоновским скриптом надо поулчать конкретную строкуиз этого файла просто, все как бы)
Грепом можно без питона
Tishka17
Тебе блин прям критична лишняя секунда ручного редактирования? Втф
Да он одну опечатку в файле сделает и запорет весь файл.
Tishka17
А контроля никакого
 Ivan
ещё запись редактором нового содержимого файла нифига не атомарная
Ilya
Кста вот да
tfhx8
ок,а то что питон, верене uwsgi будет каждый раз открывать соединение c sqlite, далее делать sql запрос, нежуто будет быстрее того, что просто открыл файл, считал строки, потом сделал поиск. В теории же ос закеширует это файл в памяти , почему не быстрее то?
 Vadim
Почему нельзя хранить файл и загружать его как dictionary?
Ivan
поиск перебором строк в файле - O(n)
поиск по бинарному дереву - O(log n)
Ilya
ещё запись редактором нового содержимого файла нифига не атомарная
Поэтому предлагаю такую схему. Для хранения данных юзать git репо. Каждый раз когда надо получить строчку делаем git pull и читаем питоном. А если надо в ручную редачить открываем в nano и правим и через гит заливаем изменение
Ilya
Гг
Ivan
sqlite тебе практически бесплатно автоматом делает индекс
Alex
ок,а то что питон, верене uwsgi будет каждый раз открывать соединение c sqlite, далее делать sql запрос, нежуто будет быстрее того, что просто открыл файл, считал строки, потом сделал поиск. В теории же ос закеширует это файл в памяти , почему не быстрее то?
Так не открывай соединение каждый раз! Пуль его!
Ivan
все операции с sqlite атомарные
tfhx8
Почему нельзя хранить файл и загружать его как dictionary?
можно и так. Так будет быстрее sqlite?
Vadim
+
Ivan
если оперативки хватает - быстрее
Ivan
поиск по хеш-таблице - O(1)
tfhx8
просто в будущем мне надо будету некоторых записей менять значения.В теори через sql такая смена будет просто. А так придется все записи перебирать
tfhx8
Почему нельзя хранить файл и загружать его как dictionary?
а есть пример? Просто мне кажется что не будет ли сильно тормазить то, что часто будет открываться и преобразовыватсья в dictionary?))
Alex
Поэтому предлагаю такую схему. Для хранения данных юзать git репо. Каждый раз когда надо получить строчку делаем git pull и читаем питоном. А если надо в ручную редачить открываем в nano и правим и через гит заливаем изменение
вспомнилось как на одной из первых работ коллега хотел бекапы БД хранить в гите.
tfhx8
Так не открывай соединение каждый раз! Пуль его!
тоесть перед запуском вебсервера uwsgi открыть соединение с sqlite базой и его передать вебсерверу, а далее внутри уже подключаться? А не будет ли дедлоков в бд, если сразу несколько потоков будут делать селекты?
Denis
Не будет
Alex
Alex
зачем ты собираешься блочить чтение?
Андрей
tfhx8
Скулайт в целом в потоки не умеет так-то
так вот я и говорил, почему мне на до было считывать с файла
Ivan
скулайт так-то нормально работает с конкурентностью
tfhx8
зачем ты собираешься блочить чтение?
я ничего не собираюсь блочить, это сам sqlite может блоки такие сыпать
Alex
так вот я и говорил, почему мне на до было считывать с файла
На этом моменте я могу только пожелать тебе удачно прострелить себе колено.
tfhx8
скулайт так-то нормально работает с конкурентностью
тоесть спокойно можно считывать 500р в секунду?)) И при таком считывании если послать команду на запись, не произойдет дедблока?)
Ivan
Ivan
тут умные дядьки всё придумали уже за вас
tfhx8
нет, почему?
точно же, просто я когда то с транзакциями практиковался с sqlite , там постоянно дедлоки были. А вот в postgey нормально все))
Ilya
PostgayQL
Ilya
Абстрактные какие-то вопросы
Ivan
а сколько максимум может sqlite считывать в с?
https://blog.expensify.com/2018/01/08/scaling-sqlite-to-4m-qps-on-a-single-server/
4 миллиона в секунду
Farrukh
Нужно было сделать exe файл - сделал с помощью PyInstaller
Возникла следующая проблема:
Как я понял exe'шник от PyInstaller'a после его запуска, работает только у себя внутри. Т.е. при создании exe'шника подтягиваются рекурсивно все модули, которые были импортированы через ""import bla_bla_bla"".
Мне нужно импортировать некоторые модули из другой папки динамически (т.е. в процессе работы программы). Для этого я как обычно сделал sys.path.append('folder/path') но этот путь просто на просто не учитывается после запуска exe'шника.
Знает кто как решить подобную проблему?
Андрей
Нужно было сделать exe файл - сделал с помощью PyInstaller
Возникла следующая проблема:
Как я понял exe'шник от PyInstaller'a после его запуска, работает только у себя внутри. Т.е. при создании exe'шника подтягиваются рекурсивно все модули, которые были импортированы через ""import bla_bla_bla"".
Мне нужно импортировать некоторые модули из другой папки динамически (т.е. в процессе работы программы). Для этого я как обычно сделал sys.path.append('folder/path') но этот путь просто на просто не учитывается после запуска exe'шника.
Знает кто как решить подобную проблему?
Мало того что пиинсталер не нужен, так ещё и импорты динамические. Это вредно в 99% случаев.
Farrukh
 Rookie
Нужно было сделать exe файл - сделал с помощью PyInstaller
Возникла следующая проблема:
Как я понял exe'шник от PyInstaller'a после его запуска, работает только у себя внутри. Т.е. при создании exe'шника подтягиваются рекурсивно все модули, которые были импортированы через ""import bla_bla_bla"".
Мне нужно импортировать некоторые модули из другой папки динамически (т.е. в процессе работы программы). Для этого я как обычно сделал sys.path.append('folder/path') но этот путь просто на просто не учитывается после запуска exe'шника.
Знает кто как решить подобную проблему?
Мб hidden imports. Но, кажется, они тоже учитываются только при сборке
 Nikolay
Никто. Никакие. Все используют jupyter notebook
first
А в таком коде таск перестанет сущевствовать после выполнения foo? Не надо же эвейтить таск и тд?
async def foo():
print('foo')
return
asyncio.get_running_loop().create_task(foo())
 Александр
 Александр
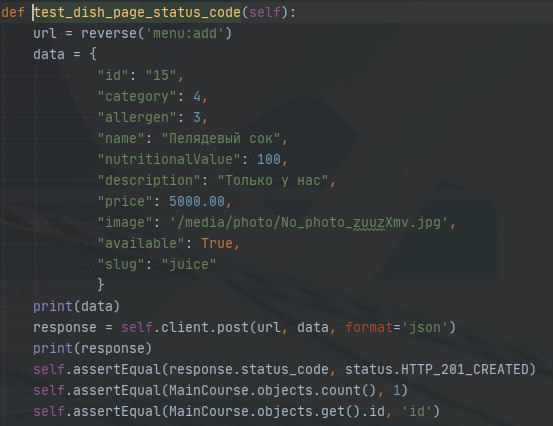
не понимаю все указано, почему не все данные передаются, судя по отчету постмен