чет долго
Я в MySQL не силен, простите. Есть подозрение что его транзакция не влазит в innodb_log_buffer_size (предполагаю у него таки innodb).
 Alex


 Tishka17
а автокоммит уже смотрели?
 🤍 geometry_std
короче. покажи:
1. код
2. схема таблицы
3. EXPLAIN запроса.
EXPLAIN: (1, 'SIMPLE', 'myprod', 'index', None, 'PRIMARY', '4', None, 485496, 'Using where')
Alex
EXPLAIN: (1, 'SIMPLE', 'myprod', 'index', None, 'PRIMARY', '4', None, 485496, 'Using where')
хз что это запусти EXPLAIN ANALYZE запроса из своего phpmyadmin если тебе так понятней.
🤍 geometry_std
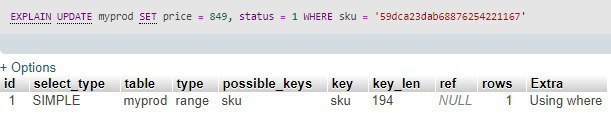 🤍 geometry_std
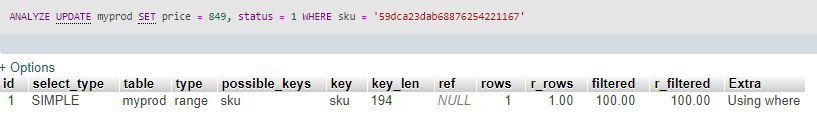 Tishka17
а индекс точно создался?
🤍 geometry_std
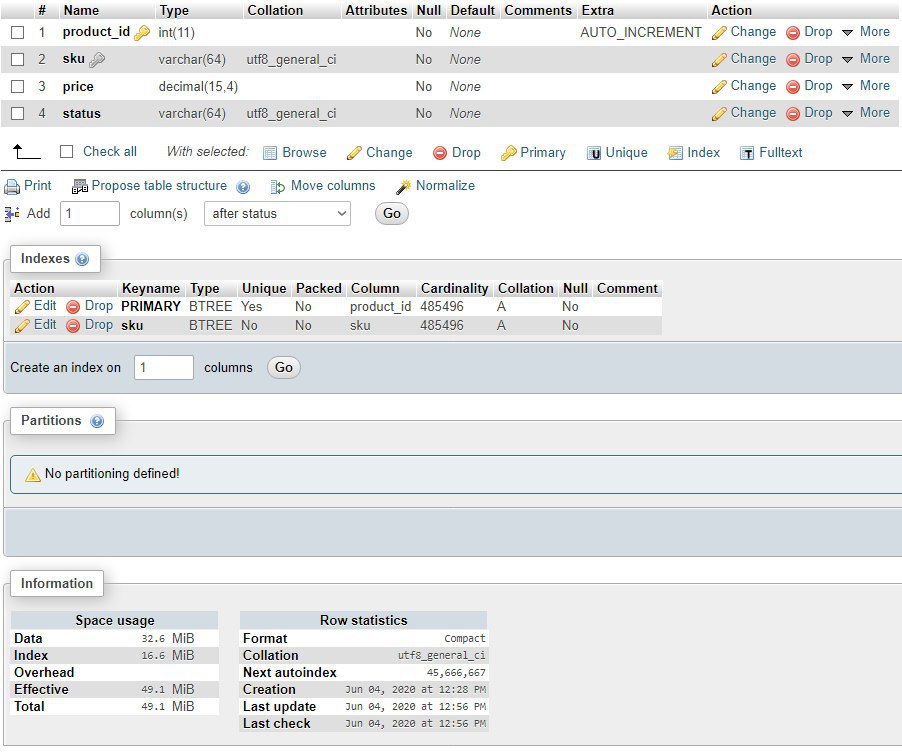 Alex
и покажи EXPLAIN ANALYZE запроса из mysql консоли. Я хз как это читать.
Tishka17
Anonymous
Как найти индекс самого большого числа в списке до сортировки?
 Lena
Чат как отсортировать список по позрастению первого элемента в кортеже и по убыванию второго. То-есть:
[(B, 10)(B, 8)(A, 15)]
надо превратить в:
[(A, 15)(B, 10)(B, 8)]
marty
да спасибо
 Denis
marty
 Philipp
Блин, не люблю такое ...
list(set([ObjectId(element.id) for element in response.Elements]))
Anonymous
Блин, не люблю такое ...
list(set([ObjectId(element.id) for element in response.Elements]))
Я обычно эту операцию в отдельную функцию кладу, ибо понятнее придумать что-то сложно.
Denis
🙈
Denis
зато в один проход.
>>> arr = [random.random() for i in range(1000)]
>>> timeit.timeit(lambda: arr.index(max(arr)), number=10000)
0.18445627300002343
>>> timeit.timeit(lambda: max(enumerate(arr), key=operator.itemgetter(1))[0], number=10000)
0.5744467580000219
🤍 geometry_std
и покажи EXPLAIN ANALYZE запроса из mysql консоли. Я хз как это читать.
из консоли выдаёт то же, чувствую себя невеждой.
Denis
а слабо так же с туплом из строк?
arr.sort(key=lambda x: x[1], reverse=True)
arr.sort(key=lambda x: x[0])
🤍 geometry_std
а он точно не broken? или как это в мускуле
время обработки то значительно уменьшилось..
Tishka17
arr.sort(key=lambda x: x[1], reverse=True)
arr.sort(key=lambda x: x[0])
ух, теперь вообще две сортировки
Alex
из консоли выдаёт то же, чувствую себя невеждой.
вполне возможно что это я от MySQL EXPLAIN ожидаю другого формата.
Tishka17
>>> arr = [random.random() for i in range(1000)]
>>> timeit.timeit(lambda: arr.index(max(arr)), number=10000)
0.18445627300002343
>>> timeit.timeit(lambda: max(enumerate(arr), key=operator.itemgetter(1))[0], number=10000)
0.5744467580000219
>>> arr = ["".join(random.choices(string.ascii_letters, k=1000)) for i in range(1000)]
>>> timeit.timeit(lambda: arr.index(max(arr)), number=10000)
0.3589548890013248
>>> timeit.timeit(lambda: max(enumerate(arr), key=operator.itemgetter(1))[0], number=10000)
1.219302442157641
прикольно, на больших данных не меняется соотношение
Tishka17
>>> arr = ["x"*10000+"".join(random.choices(string.ascii_letters, k=100)) for i in range(1000)]
>>> timeit.timeit(lambda: arr.index(max(arr)), number=10000)
12.350205660099164
>>> timeit.timeit(lambda: max(enumerate(arr), key=operator.itemgetter(1))[0], number=10000)
9.370476641925052
а вот на таких данных уже появляется разница в обратную сторону
Tishka17
в общем, вывод простой: пока сравнение происходит быстро - лучше два прохода. Как только сравнение долгое - лучше один.
Alex
пока функция сравнения значительно дешевле создания тупла и getitem преимущество у варианта с двумя проходами.
Tishka17
угу
Tishka17
А если разнообразие в списке маленькое - два прохода ещё больше выигрывают
Alex
опять же если не играться в однострочники, а брать обычную переменную с инкрементом, будет наиболее эффективное из решений (если не брать во внимание разницу в языке реализации)
Philipp
Ребят, что-то туплю, можно через listcomp выбрать данные из списков двойной вложенности?
Например из такого: [{"a": [{"b": 1}, {"b": 2}, {"b": 3}]}, {"a": [{"b": 4}, {"b": 5}, {"b": 6}]}]
получить такой: [1, 2, 3, 4, 5, 6]?
Anonymous
Как лучше всего получить результат произведения считанной строки из файла типа 99**683?
Anonymous
ну тюею степень
Philipp
тут не списки
Да, не совсем корректно выразился, список с объектами, внутри которых списки с объектами =) [Leo_inception_photo.jpg]
Alex
Как лучше всего получить результат произведения считанной строки из файла типа 99**683?
лучше всего распарсить и написать "выполнятор" выражений.
Anonymous
лучше всего распарсить и написать "выполнятор" выражений.
а есть вариант перевести только часть символов этой строки в числа и потом их возвести в степень?
Tishka17
а есть вариант перевести только часть символов этой строки в числа и потом их возвести в степень?
это и есть написать выполнятор
 Kirill
он и в другом чате есть, через разные капчи пробивается(
freezlite
как в psycopg2 пустую строку вставить в запрос желатиельно не аргументом а в сам запрос
Tishka17
как в psycopg2 пустую строку вставить в запрос желатиельно не аргументом а в сам запрос
'' не работает?
freezlite
нет, вырезает
freezlite
'' '' не пробовал
Dmitry Manoshin
Как можно итерироваться по матрице ячейкой 2 на 2. Чтобы захватывать сразу 4 числа
freezlite
similarity(array_to_string(aliases, ),
freezlite
вот после aliases должны быть пустые ковычки
freezlite
sql = "SELECT *, similarity(array_to_string(aliases, ' '),
freezlite
sql = "SELECT *, similarity(array_to_string(aliases, '' ''),
freezlite
как только не пробовал, со слешем тоже
freezlite
Что делает?
обманул '' '' выдает SELECT *, similarity(array_to_string(aliases, '' '')
freezlite
а одинарные как сделать не знаб)
Tishka17
freezlite
короче '' '' выдает как есть, а мне надо ' '
Adil
Как можно итерироваться по матрице ячейкой 2 на 2. Чтобы захватывать сразу 4 числа
Итерируешься как по обычной матрице, просто ещё берешь элементы [i][j+1], [i+1][j] и [i+1][j+1]. Ну и ещё нужно идти не до конца, а до n-1, m-1
Anonymous
Объясните валенку кому не сложно, почему в Python:
100 and 200 вернёт 200
Anonymous
>>> 100 and 200
200
>>> 100 or 200
100
 Serhii
Объясните валенку кому не сложно, почему в Python:
100 and 200 вернёт 200
и то и то правда, поэтому перезапишет сначала 100 и оставит 200
 Андрей
А 0 and 200 вернет 0
Tishka17
Объясните валенку кому не сложно, почему в Python:
100 and 200 вернёт 200
возвращает то число на котором стало понятно что можно дальше не считать истинность выражения
Anonymous
возвращает то число на котором стало понятно что можно дальше не считать истинность выражения
Вот это внезапно было конечно. Спасибо.
Андрей
А вот or будет искать до первого истинного
Serhii
поменяй местами 200 and 100