 sabsubsib


Можно с помощью своего сервера, а можно просто бесплатный конфиг
sabsubsib
Сайт с фри конфигами https://free-ss.site/
 Fargo
вот что то похожее я и пробовал, не сработало, буду ваш вариант пробовать =)
*
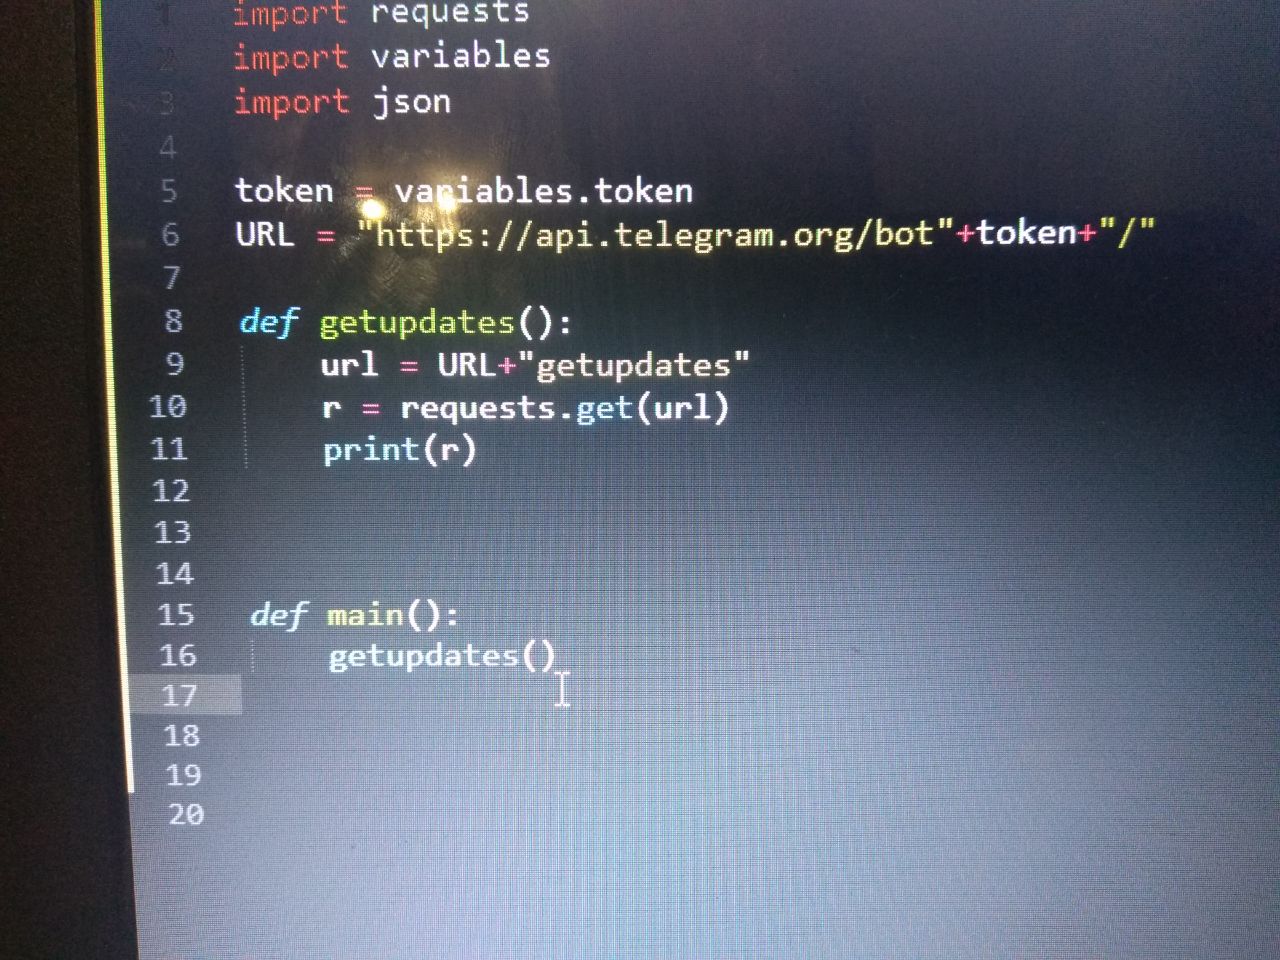
А как в SublimeText 3 вызывать метод))
 Георгий
*
Метод))
Сергей
Я вот не понимаю, а в чем отличие вызова в саблайме?
*
Я 3 час вникаю))
Хочу бота написать)
Сергей
method(parameters)
*
 Сергей
*
Как?)))
Anonymous
@AGAINHELLOWORLDinc
Anonymous
Tell hi or hello
Сергей
Ниче ты opencv
*
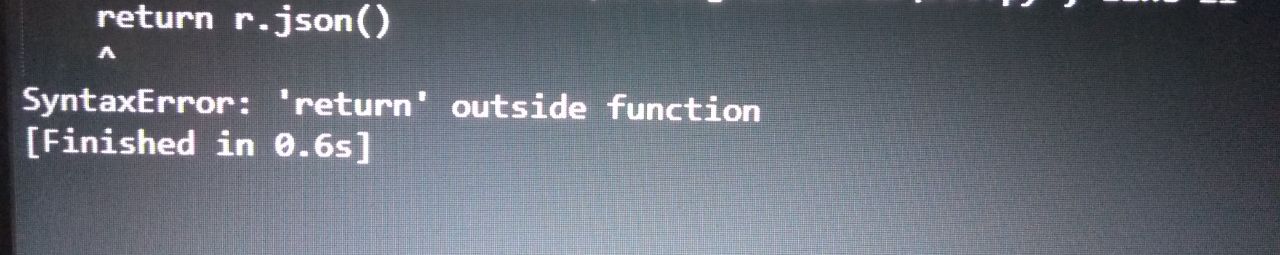
Зачем она тебе вообще? Убери строку def main и убери табуляцию перед getupdates
Я удалил там return было, в ошибке написано, что без функции оно не работает
Сергей
Каво
*
 Anonymous
*
Разобрался с табуляцией, спасибо.
Как функцию вызвать ?)
Пишу в консоли Subline Text'a 3 main()
Выдает ошибку:name 'main' is not defined
Anonymous
а разве это не в @ru_python_beginners?
*
Хз,просто чтобы показало результат выполнение метода)
Anonymous
Та я думаю за 2 года лям триста тысяч просмотра
Anonymous
А лекции слишком даже полезные , без особых углублений в математику , а лишь слегань базу затрагивает
 Alex
Ребят, у меня здесь NLP задача и я был бы очень благодарен если бы подсказал в каком направлении двигаться!
Есть значит у меня телефонные разговоры операторов с абонентами (речь уже преобразована в текст , и уже произведена классификация того что говорит абонент, и то что говорит оператор). Задача выявить чем абонент разочарован, чтобы при последующим звонке того же абонента, оператор выдел на экране в чём разочарование состояло.
Сейчас все реализовано следующим образом: с помощью regular expressions ведётся поиск отрицательных слов, типа "разочарован", "зол", и т.д. Далее от каждого такого слова отчитывается десять слов в право и десять в лево (пунктуации в тексте нету, поэтому нельзя просто выбрать интересуемое предложение). Получаем кусок текста который потенциально несет negative sentiment. Если в одном разговоре таких слов много, то будет создано много кусков текста. Далее используется Vader из NLTK для скоринга каждого такого куска текста. Выбирается наиболее негативный кусок и он и показывается оператору, когда этот же абонент звонит в следующий раз.
Алгоритм не идеальный по многим причинам. Основная:
Vader приписывает значительный отрицательный скор, обрывкам теста, которые по сути являются набором бессвязных слов. Понятно что Vader не особо в этом виноват, так как такое качество исходного текста. К слову, я не могу повлиять на способ преобразования звука в текст :(
Alex
Какие есть идеи на сегодняшний день:
1) Попробовать другие pre-trained модели (какие порекомендуете?).
2) Попробовать отследить где начинается предложение с негативным словом и где оно заканчивается (есть ли разработанные модели для этого?).
3) Модель которая бы говорила что-то вроде "этот кусок текста мусор и его оценивать не надо, его выкидываем".
4) Topic modeling. То есть все негативные куски текста классифицировать по топикам.
5) Выкинуть этап с regular expressions.
6) Сделать тестовые данные для модели, а не использовать pre-trained модель
Alex
Если честно, то мне кажется 1) не получится реализовать адекватно.
Так как мусора в кусках текста на столько много, то реализовать 2) тоже будет проблематично.
3) - не решение проблемы на 100% и опять же вопрос как реализовывать.
4) - не знаю как реализовывать, но наверное это лучшее что можно было бы предложить. Оператор будет видеть не какой-то неструктурированный набор текста, а осмысленное словосочетание ("дорогие услуги", "неудобный сервис", и т.д.).
5) У меня сомнения на счёт этого. Regular expressions находят хотя бы негативные слова из тонны мусора, без этого мне кажется любой последующий алгоритм будет плохо работать. То что успел понять точно - выкидывание regular expressions ведёт к значительному замедлению расчётов.
6) Думаю это не повредит и например способ 4) не будет без этого работать. На это уйдут месяцы, и хорошо бы знать, что они были потрачены не зря и есть общая идея как улучшить результаты.
В общем, спасибо что дочитали до конца и я открыт к любым вашим идеям.
 lbh
скорее надо юзать что-то из детекторов эмоционального состояния по тембру голоса. на словах можно очень мило разговаривать, а внутри при этом выбешивают звонильщики, и в следующий раз даже трубку не снимаю или снимаю и посылаю нахуй и кладу
lbh
к слову такой инструмент у мошенников отлично пойдет :)
Alex
скорее надо юзать что-то из детекторов эмоционального состояния по тембру голоса. на словах можно очень мило разговаривать, а внутри при этом выбешивают звонильщики, и в следующий раз даже трубку не снимаю или снимаю и посылаю нахуй и кладу
К сожалению, у меня нет доступа к инструменту, который преобразовывает голос в текст(
Adel
Если честно, то мне кажется 1) не получится реализовать адекватно.
Так как мусора в кусках текста на столько много, то реализовать 2) тоже будет проблематично.
3) - не решение проблемы на 100% и опять же вопрос как реализовывать.
4) - не знаю как реализовывать, но наверное это лучшее что можно было бы предложить. Оператор будет видеть не какой-то неструктурированный набор текста, а осмысленное словосочетание ("дорогие услуги", "неудобный сервис", и т.д.).
5) У меня сомнения на счёт этого. Regular expressions находят хотя бы негативные слова из тонны мусора, без этого мне кажется любой последующий алгоритм будет плохо работать. То что успел понять точно - выкидывание regular expressions ведёт к значительному замедлению расчётов.
6) Думаю это не повредит и например способ 4) не будет без этого работать. На это уйдут месяцы, и хорошо бы знать, что они были потрачены не зря и есть общая идея как улучшить результаты.
В общем, спасибо что дочитали до конца и я открыт к любым вашим идеям.
А обязательно это через nlp//ML решать? В интерфейсе оператора нельзя просто добавить листбокс с основными причинами недовольства, чтобы прямо во время разговора человек делал пометку напротив номера абонента, а в последующие диалоги операторы видели историю пометок по данному абоненту?
Alex
Жук
А обязательно это через nlp//ML решать? В интерфейсе оператора нельзя просто добавить листбокс с основными причинами недовольства, чтобы прямо во время разговора человек делал пометку напротив номера абонента, а в последующие диалоги операторы видели историю пометок по данному абоненту?
оператор заинтересован врать, а александр - попилить денежки на проекте
 Sergey
Доброго дня. Мне хотелось бы попросить совета по использованию ActiveMQ и STOMP вместе с Flask - нужно принимать сообщения и как-то извлекать из них информацию на постоянно работающем сервере. Проблема в том, что из-за многопоточности каждому листенеру достается только часть сообщений, даже если используются глобальные переменные. Т.е. из 5 сообщений доступ у меня в итоге есть только к 3.
 Ilya
 John Brown
Памагите пажожда(
John Brown
https://pastebin.com/uy8uVXJy
Подскажите, как передать функции calculate переменную B
 c
https://pastebin.com/uy8uVXJy
Подскажите, как передать функции calculate переменную B
тебе в бегиннерсы, а сначала вообще в учебник
c
переменную можно передать как аргумент или использовать поля в классе
Жук
https://pastebin.com/uy8uVXJy
Подскажите, как передать функции calculate переменную B
начнем с того, что ты вообще ничего не можешь передать в calculate, а значит ты не понимаешь что написал и/или просишь
Жук
Потом продолжим тем, что ты код этот не запустишь - у тебя как минимум переменная B нигде не объявлена
Sergey
Ты что-то не так делаешь...
Я ставлю листенер, который внутри себя (self.message_list) хранит список всех полученных сообщений и по команде выдает их через запрос на АПИ. Отправляю 5 сообщений, выдается 3.
Sergey
Более того, отправитель при подключенном PrintingListener фиксирует завершение отправки только 3 сообщений.
Жук
Я ставлю листенер, который внутри себя (self.message_list) хранит список всех полученных сообщений и по команде выдает их через запрос на АПИ. Отправляю 5 сообщений, выдается 3.
попробуй поставить лок на моменте получения сообщения
Sergey
попробуй поставить лок на моменте получения сообщения
Крутился вокруг этого, но не знаю, куда этот лок правильно будет подцепить.
Sergey
Внутри листенера он странно будет выглядеть.
Жук
в момент работы со списком
Жук
захватил лок - взял элемент - отдал лок
Sergey
https://pastebin.com/ZeaJtEjs
Sergey
Кручу такое сейчас, .
Жук
error_dict = {}
error_dict['headers'] = headers
error_dict['message'] = message
self.error_list.append(error_dict)
Жук
чем тебя error_list.append({'headers':headers,'message':message}) не устроил?
Жук
а лок можешь и не ставить, просто используй потокобезопусную очередь
Жук
queue вроде, или чота такое
John Brown
Ладно, спасибо и с наступающим
Sergey
чем тебя error_list.append({'headers':headers,'message':message}) не устроил?
Расширение такого формата будет лучше выглядеть. Тут либо строить стену из dict[key], оибо плести вермишель {'key': 'value, 'key1': value1}
Жук
2 еще терпимо, про 3 ниже я ничего не сказал
Жук
но я не профессиональный писака на питоне, мое мнение вполне может быть инвалид
Anonymous
всем привет. где хранятся переменные во время работы. и можно ли их востановить после остановки программы? безопасно ли там хранить очень важные пароли от криптоконтейнеров?
Жук
всем привет. где хранятся переменные во время работы. и можно ли их востановить после остановки программы? безопасно ли там хранить очень важные пароли от криптоконтейнеров?
читай что такое mmu и как получают доступ к памяти процесса
Sergey
https://pastebin.com/zYTDmRa6
Anonymous
читай что такое mmu и как получают доступ к памяти процесса
где лучше всего хранить пароли от шифрования , чтобы при остановке программы их было невозможно востановить?
Sergey
Все еще 6 уходят, 3 приходят. При этом есть явный паттерн - из отправленных 0, 1, 2, 3, 4, 5, 6 дошли 1, 3, 5
Sergey
Думаю, что тут потоки стомпа как-то замешаны, но это не очевидно.
Жук
with lock лучше, и если я не ошибаюсь, ты неправильно принципе используешь лок, чекай доку
Anonymous
где лучше всего хранить пароли от шифрования , чтобы при остановке программы их было невозможно востановить?
помогите пожалуйста. это очень важно)
Anonymous
mmu ?
c
Anonymous
а зачем тебе
Мне нужно хранить пароль от шифрования. Тоесть при запуске программы нужно ввести пароль. И его нужно где-то хранить так, чтобы при остановке программы этот пароль нельзя было достать(вонстановить).