pyautogui
фу, как пошло
 Alex


 Faglo
Ты же хотел простое?
да мне лишь бы взаимодействие с ае было, без автогуи и прочих штук для автоматизации юзеринпутовских задач
 Tishka17
Хм. Ае стоит 2к в месяц
Tishka17
Это вам не пайчарм
 Aragaer
а как в этих ваших f-строках указать число знаков после запятой?
 Pavel
а как в этих ваших f-строках указать число знаков после запятой?
https://docs.python.org/3/library/string.html#formatspec
 Anonymous
Насколько хорошей практикой является использование Pool из multiprocessing.dummy для выполнения параллельных задач?
Темы асинхронности, многопоточности и параллелизма всегда вызывали неприятные ощущения, в виду того, что многое непонятно и чувствовалось собственное сопротивление этим важным темам.
До этого момента для выполнения каких-то параллельных задач (обращение к API, пересчёты, etc.) я использовал вполне понятную снаружи (по крайней мере по написанию), и не совсем понятную внутри, возможность Pool'a из multiprocessing.dummy. Создавал нужные методы для вызова, списки, элементы которых будут в эти методы поступать при обработке, и, собственно, всё. Всё работало, естественно, быстрее, чем в однопоточном синхронном режиме. Но даже тогда сталкивался с тем, что не знаю, как следует манипулировать в тех или иных ситуациях, когда случаются затупы в работе программы. Например, в определенный момент времени (почти всегда это конец выполнения параллельных задач).
pool = ThreadPool(60) # from multiprocessing.dummy import Pool as ThreadPool
for _ in tqdm(pool.imap_unordered(do_something, user_list), total=len(user_list)):
pass
Метод do_something(user) обращается к API, для получения информации о user. Не буду акцентировать внимание на то, что в этом методе использую requests, знаю, что это медленно, но хотелось бы разобраться со всей этой темой в совокупности, чтобы пропали все вопросы.
user_list - список пользователей (['user_1', 'user_2', ..., 'user_2000']). Видно, что пользователей 2,000 и для каждого из них нужно получить информацию. Как писал ранее, при приближении прогресса к 100%, весь процесс как будто зависает. Сейчас отображено следующее: 100%|█████████▉| 1995/2000 [1:06:12<33:41, 404.22s/it]. Считаем, что API всегда доступно и лимиты не будут превышены. Конкретно тут в чём может быть проблема? Почему оно "зависает"? В кавычках, поскольку процесс не завис, а просто выполняется намного больше, чем при старте. Условно, когда была 1990 итерация, 1991-ая итерация началась через 15-20 секунд, от 1991 до 1992 — около 3-5 минут, а переход от 1994 до 1995 занял около 40 минут.
Если задать бóльшее число в ThreadPool(<number>), и/или уменьшить количество элементов в user_list, то никаких тормозов не остаётся, и программа выполняется успешно.
Aragaer
интересная тактика
Anonymous
where? I don't trust google much
Anonymous
where? I don't trust google much
lol, with google advice u will become a beggar. try coindesk or taklimakan, these 2 r the bestest
Aragaer
бот их поубивает или надо руками тыкать?
Anonymous
Ребят, кто может объяснить очень понятнвм языком что такое DNS?
Anonymous
В интернете много объяснений, но не могу понять вообще ничего
 Sergey
Это прям сильно утрированно
Sergey
Это типо айпишника, но он не меняется?
Айпишник привязан к этому имени, по имени проще обращаться
Anonymous
Тогда это типо IMEI, но днс в сети интернет?
Anonymous
Вообще чё то туплю😂
Tishka17
Ребят, кто может объяснить очень понятнвм языком что такое DNS?
Название сервера в интернете
Tishka17
Это так ФИО, по которому ты можешь позвонить в справочную и узнать номер
Anonymous
Спасибо, вроде чуть-чуть понял😁
Andrii
Драствуйте, почему pickle.load возвращает ошибку?
https://pastebin.com/mzWptKjQ
Alex
Драствуйте, почему pickle.load возвращает ошибку?
https://pastebin.com/mzWptKjQ
какую ошибку? зачем тебе pickle?
Andrii
какую ошибку? зачем тебе pickle?
EOFError: Ran out of input
Хранение данных для последующего доступа
Alex
А чем тогда пользоваться? Или имеется ввиду ошибка в коде?
нет, имеется ввиду что pickle не предназначен для хранения где-либо вне программы \ дерева процессов.
Alex
JSON храни
Alex
код - говно
Alex
Читай SOLID, узнай о существовании @classmethod, которые ты пытаешься использовать, но делаешь это коряво.
Alex
Сходи в чат новичков.
 Max
Это там: @ru_python_beginners
Andrii
Понял, принял
Николай
https://t.me/data_meetups_moscow/176
 ️Skill
Когда с помощью селениума получаю страницу она грузиться бесконечно. Соответственно я не могу ничего спарсить. Что с этим можно сделать?
 oneonwar
Когда с помощью селениума получаю страницу она грузиться бесконечно. Соответственно я не могу ничего спарсить. Что с этим можно сделать?
Но вообще цикл while и условие проверки на количество элементов до/после загрузки если там например прокрутка
User
Добрый вечер кто подскажет по коду)? https://repl.it/repls/UnfoldedGiddyBlog
User
требуется проверить строку на наличие элементов списка
 🌍 Олег NSD Всеволодович 🌍
коллеги я сейчас делаю ПО которое уничтожит ФСБ и прочие мировые спецслужбы. кому-то интересно?
User
все трезвые)) думаю нет)
 Stom
коллеги я сейчас делаю ПО которое уничтожит ФСБ и прочие мировые спецслужбы. кому-то интересно?
на Кащенко есть пару специалистов, им может быть интересно...
Alex
коллеги я сейчас делаю ПО которое уничтожит ФСБ и прочие мировые спецслужбы. кому-то интересно?
админам точно интересно.
@Tishka17 вызови человеку санитаров.
User
даже мой вопрос насчет any() выглядит лучше))
 Проксимов
 🌍 Олег NSD Всеволодович 🌍
оно опенсорс
🌍 Олег NSD Всеволодович 🌍
в гитхабе
 c
ору
 Romeo
Дано файл содержащий сведения об игрушках, указывается название игрушки (например кукла, конструктор и т.д.), ее стоимость в рублях и возрастные границы для детей, которым игрушка назначается (например, для детей от 2 до 5 лет). Составить подпрограмму поиска названий игрушек предназначенных детям и 4, и 10 лет.
Tishka17
🌍 Олег NSD Всеволодович 🌍
развернуть можно на самой дешевой VPS-ке
Tishka17
Федеративный
🌍 Олег NSD Всеволодович 🌍
когда все распределено
 Jonny
Я js'ник. Проблема такая Python3, я обращаюсь в скрипте к другому скрипту через subprocess.Popen... В этом скрипте есть input(). Как можно перенаеравлять входные и выходные данные?
Точнее, мне нужно заменить инпуты во втором скрипте, что бы он отправил сообщение в первый скрипт и ждал ответа...
Заранее спасибо.
 alexcher
 alexcher
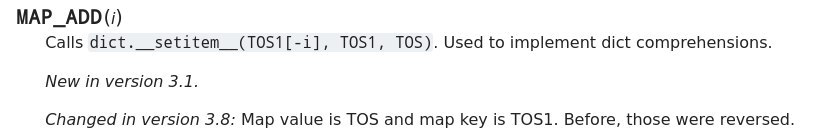
как оно работает? что такое TOS1[-i]. как понимаю, на этом месте должен быть дикт объект, однако чем тогда должен являться TOS1?
Pavel
Я js'ник. Проблема такая Python3, я обращаюсь в скрипте к другому скрипту через subprocess.Popen... В этом скрипте есть input(). Как можно перенаеравлять входные и выходные данные?
Точнее, мне нужно заменить инпуты во втором скрипте, что бы он отправил сообщение в первый скрипт и ждал ответа...
Заранее спасибо.
У Popen можно указать stdin, stdout, stderr
Pavel
Я js'ник. Проблема такая Python3, я обращаюсь в скрипте к другому скрипту через subprocess.Popen... В этом скрипте есть input(). Как можно перенаеравлять входные и выходные данные?
Точнее, мне нужно заменить инпуты во втором скрипте, что бы он отправил сообщение в первый скрипт и ждал ответа...
Заранее спасибо.
То есть stdin первого засунь в stdout второго, stdout первого в stdin второго
🌍 Олег NSD Всеволодович 🌍
Pavel
не, я про свой скрин
Мне кажется, что TOS1 - исходный словарь, а TOS - это конечный, который генератор словарей вернет
alexcher
Мне кажется, что TOS1 - исходный словарь, а TOS - это конечный, который генератор словарей вернет
а оно возвращает генератор словарей? тут же сказано, что это вызов dict.__setitem__, или ты о чем
🌍 Олег NSD Всеволодович 🌍
Не понятно как это поможет
будет софт который сложно обезвредить. да и не будет он незаконен юридически
🌍 Олег NSD Всеволодович 🌍
но такая где нет ни у кого преимущаства стартового
где все изначально равны
Tishka17
Джаббер довольно легко блокируется