Обычный лог, хм, ну давай другой возьму тоже большой
Я имею ввиду принтани его полностью в консоль, а не по лайнам
 Anvar

 Anvar
И что ты вообще хочешь сделать, если просто лог в консоль выводить можно хендлер добавить.
 Svyatoslav
Если его раскодировать с .read() то файл будет полный или на том же месте?
Я его распаковывать, все норм и открывал через open('file', 'r') и принт в консоли весь выдавал
Svyatoslav
И что ты вообще хочешь сделать, если просто лог в консоль выводить можно хендлер добавить.
Суть: прочитать текст в архиве (лог) найти совпадения и вывести совпадения в консоль
Anvar
Просто первая мысль это что файл закончился на этом месте
Anvar
Попробуй for line in fp.read().splitlines()
 Alex
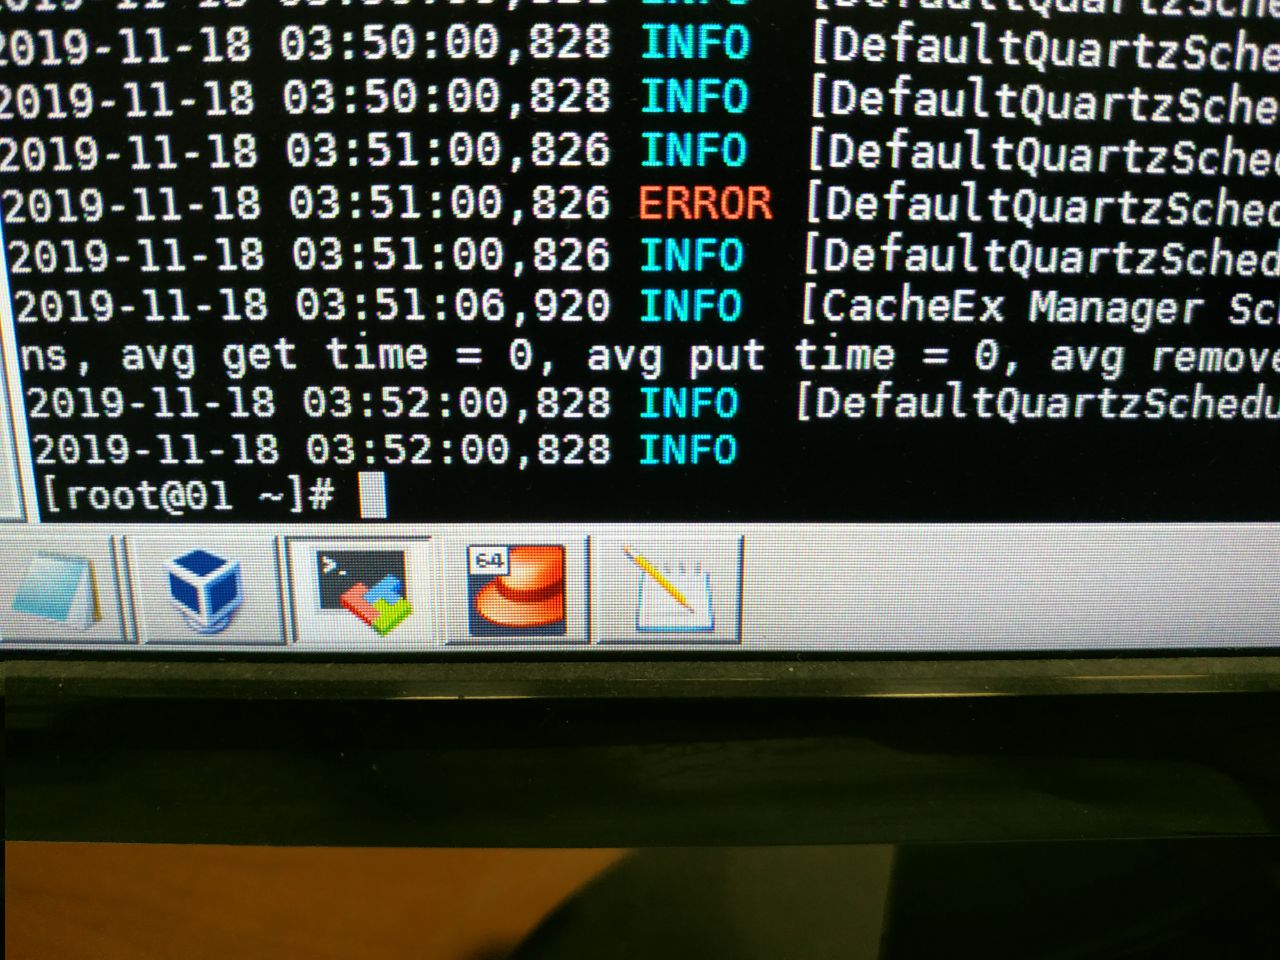
Вообще судя потому что он выдал весь тупл нужно сам файл посмотреть
по внешним признакам это выглядит как OOM killer.
 👑OGURCHIK🖤
и админа бань
Alex
но тогда это странно, т.к. ранее ТС читал файл в память и печатал так же до строки 7 тысяч что-то там
Svyatoslav
ну ты все же помониторь потребление памяти.
На стенде в виртуалке ровно в два раза увеличил память, на том же месте обрывается print
Svyatoslav
 Aito
Цепочка продолжается ,что такое топистартер
 Nikita
https://ru.wiktionary.org/wiki/%D1%82%D0%BE%D0%BF%D0%B8%D0%BA%D1%81%D1%82%D0%B0%D1%80%D1%82%D0%B5%D1%80
Alex
На стенде в виртуалке ровно в два раза увеличил память, на том же месте обрывается print
похоже на вот это
https://bugs.python.org/issue10900
Alex
@sv9tk сделай bzip2 -tvvv filename.bz2
Svyatoslav
Вконце вывода ок, тебе нужен весь вывод?
Svyatoslav
Пробую другой лог, ещё больше
Alex
не нужно
Alex
этого достаточно
Alex
судя по этому логу у тебя multi-stream архив
Alex
они не поддерживаются до python 3.3 в стандартном модуле bz2
Alex
твои варианты:
1) разархивировать при помощи консольной утилиты bzip2 и вызвать через subprocess
2) воспользоваться 3rd party пакетом, например bz2file
Svyatoslav
Ого, @cutwater спасибо, я таких архивов и не знаю... Ушел читать...
Svyatoslav
твои варианты:
1) разархивировать при помощи консольной утилиты bzip2 и вызвать через subprocess
2) воспользоваться 3rd party пакетом, например bz2file
Разархивировать кстати наверно не лучший вариант при 20 гиговых архивах
Alex
Разархивировать кстати наверно не лучший вариант при 20 гиговых архивах
дык никто не говорит разархивировать в файл.
Alex
запускаешь консольную утилиту, которая читает файл в pipe.
Alex
@dimaz_t успел.
Alex
Разархивировать кстати наверно не лучший вариант при 20 гиговых архивах
p = subprocess.Popen(['bzip2', '-d', '-k', filename], stdout=subprocess.PIPE)
и читаешь из
p.stdout
Alex
Разархивировать кстати наверно не лучший вариант при 20 гиговых архивах
но при этом ты изначально эти 20гиговые архивы пытался вычитать полностью в память. однако.
Svyatoslav
Svyatoslav
но при этом ты изначально эти 20гиговые архивы пытался вычитать полностью в память. однако.
Читал что readline как раз читает сразу по строково,а не изначально весь файл как readlines. Разве нет?
Alex
Читал что readline как раз читает сразу по строково,а не изначально весь файл как readlines. Разве нет?
да, но у тебя там где-то readlines проскакивали.
Svyatoslav
да, но у тебя там где-то readlines проскакивали.
Это опечатка, скопировал не с того теста своего
Alex
а вместо readline достаточно итерироваться по файлу (открытому в текстовом режиме)
tfhx8
как то можно в format() чтобы вместо {} обрабатывало {{}} ?
Alex
если у тебя форматная строка приходит откуда-нибудь снаружи - пихать ее в format крайне глупая идея.
Alex
как то можно в format() чтобы вместо {} обрабатывало {{}} ?
https://docs.python.org/3/library/string.html#custom-string-formatting
 Tishka17
если у тебя форматная строка приходит откуда-нибудь снаружи - пихать ее в format крайне глупая идея.
Ну смотря что за "снаружи". Может это тулза для переводов генерирует. Но тогда возможно вообще format не подойдёт
 Aragaer
риплейс!
Aragaer
а формат как вызывается?
tfhx8
просто возможно проще было бы в формате поменять и все
tfhx8
'''text''',format()
 Sergei
тебе экранировать символы надо?
Aragaer
>>> "{a} {b} {}".format("{}",a=1,b=2)
'1 2 {}'
Aragaer
йа добрый
Aragaer
ну чит в том, что {} берут из аргсов, а {x} берут из кваргсов и надо чтобы аргсы были все "{}", чтобы заменить "{}" на них же
Aragaer
но надо знать их количество. Но наверно лечится
tfhx8
тебе экранировать символы надо?
нет, он ругается на то что в тексте есть {} но они не предназначены для формата. Их можно вручную экранировать, но подумал что быстрее изменить внутри формата как то
Aragaer
>>> "{a} {b} {} moar {}".format(*(["{}"]*100),a=1,b=2)
'1 2 {} moar {}'
а вот так можно уже до 100 штук обработать
tfhx8
у меня в тексте хз сколько {}, но надо сделать замену через формат всего пару значений и из-за этого вручную экранировать лень
 Roman
Вопрос может не совсем по питону просто я парсер на нем делал. Есть такой ресурс kad.arbitr.ru по сути единственный актуальный источник арбитражных дел. Так вот эти ребята очень шустро банят если запросить много и часто. Открытого api нет. Если делать через пул проксей то посеветуйте нормальную библиотеку для работы через прокси а главное где брать этот пул так чтоб по адекватной цене. Ориентировочно 20к запросов в сутки к одному ресурсу надо. Т.е. несколько тысяч адресов источников.
Aragaer
>>> mah_str = "{a} {b} {} moar {}"
SyntaxError: invalid syntax
>>> mah_str.format(*(["{}"]*mah_str.count("{}")), a=10, b=20)
'10 20 {} moar {}'
Aragaer
/me думает, как еще можно тут извратнуться
Aragaer
>>> mah_str.replace("{}", "{{}}").format(a=10, b=20)
'10 20 {} moar {}' так слишком банально
tfhx8
>>> mah_str.replace("{}", "{{}}").format(a=10, b=20)
'10 20 {} moar {}' так слишком банально
он так экранирует и те что надо обработать
 Блин
у меня в тексте хз сколько {}, но надо сделать замену через формат всего пару значений и из-за этого вручную экранировать лень
Кажется, тут попахивает regex-ами
Aragaer
он так экранирует и те что надо обработать
нет, только те, которые голые. Или у тебя есть два варианта - которые надо обрабатывать и которые не надо? А как их тогда различать?
Sergei
Вопрос может не совсем по питону просто я парсер на нем делал. Есть такой ресурс kad.arbitr.ru по сути единственный актуальный источник арбитражных дел. Так вот эти ребята очень шустро банят если запросить много и часто. Открытого api нет. Если делать через пул проксей то посеветуйте нормальную библиотеку для работы через прокси а главное где брать этот пул так чтоб по адекватной цене. Ориентировочно 20к запросов в сутки к одному ресурсу надо. Т.е. несколько тысяч адресов источников.
ну и работаю с прокси элементарно. Если мне приходит не удовлетворительный ответ, то меняю прокси из списка и елаю новый запрос. По сути рекурсивный запрос пока не будет ответ номральный
Aragaer
ну или если уж ты точно знаешь позиции, то вариант с ["{}"]*mah_string.count("{}") это почти - можно нужные позиции заменить на что тебе надо
Sergei
для работы с запросами использую https://pypi.org/project/requests/
tfhx8
нет, только те, которые голые. Или у тебя есть два варианта - которые надо обрабатывать и которые не надо? А как их тогда различать?
вот я и гвоорил, можно ли сменить внутри формата {} чтобы к примеру он смотрел вместо {} на ## или {{}}
Sergei
https://requests.readthedocs.io/en/master/user/advanced/#proxies