 Tishka17


В одном случае итерации идут строго друг за другом, в другом - вразнобой. Что в общем не одно и то же
 Алексей
Вот сишный код
#include <stdio.h>
int main () {
printf("start\n");
unsigned long long i=0;
while (i<20000000000){
i++;
if (i==19999999999) {
printf("19999999999\n");
}
}
printf("end");
return 0;
}
Алексей
Вот гошный код
package main
import "fmt"
func main() {
fmt.Println("start")
i := 0
for i<20000000000 {
i++
if i == 19999999999 {
fmt.Println("19999999999")
}
}
fmt.Println("end")
}
Anonymous
Tishka17
Обычного Лонга хватит
Алексей
Вот растовский код
fn main() {
println!("start");
let mut n: u64 = 0;
while n < 20000000000 {
n += 1;
if n == 19999999999 {
println!("19999999999");
}
}
println!("end");
}
Алексей
Попробуй посмотрим что будет у тебя
Anonymous
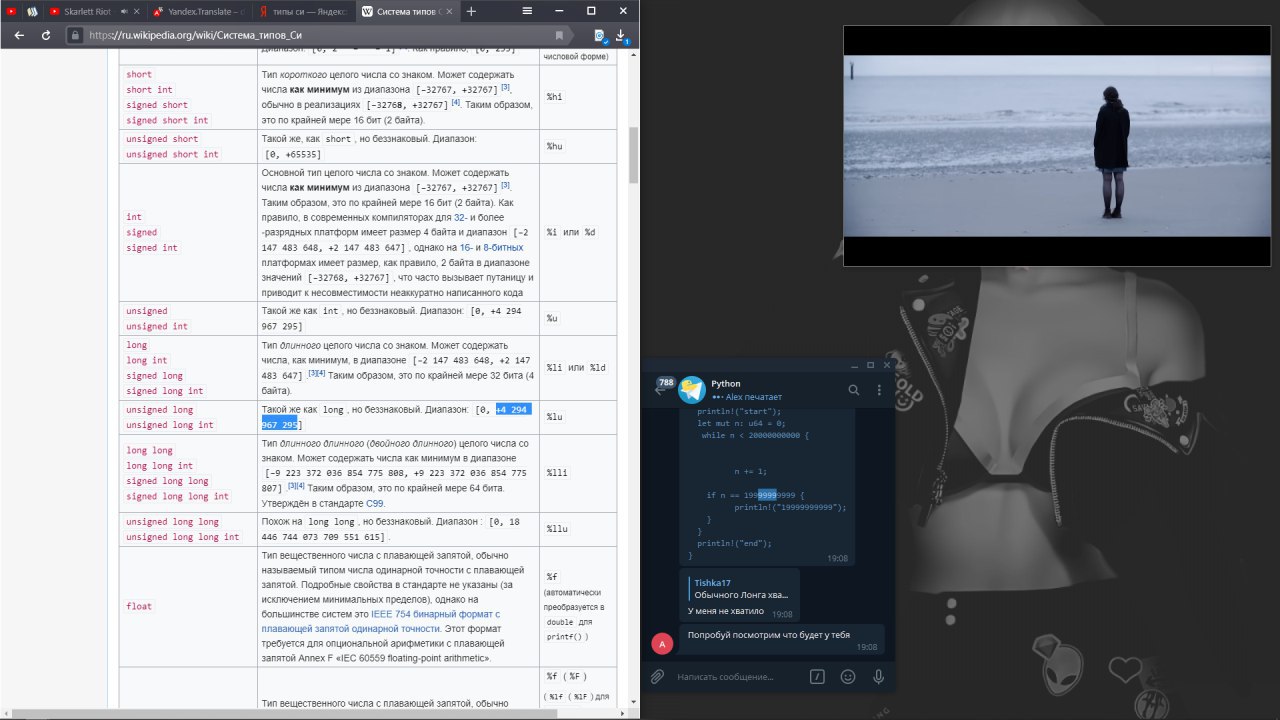 Anonymous
Не хватает, видишь
 Alex
Alex
На 64 битных платформах на основных платформах и компиляторах long 8 байт
Tishka17
Tishka17
Хотя по-моему врет
Алексей
А насчёт нескольких ядер: это будет уже другой код, который работает по другому. Так что бенчмарк нечестный
Да я понял что нечестный, но просто захотелось 65 минут как-нибудь сократить
Tishka17
На лонг, если я правильно помню, было одно требование - не короче инт. Который не короче чем шорт. Который минимум байт
Алексей
у меня на unsigned long программа на си уходила в бесконечный цикл
Алексей
Кстати ребят а что будет если в этот бенчмарк добавить задействование памяти, скажем в цикле каждое новое число вносить в список, что будет по потреблению памяти в С, Rust, Go, Python?
Tishka17
Иди почитай что-нибудь
Tishka17
Порядок по потреблению памяти ты назвал
Tishka17
Должна была с варнингом скомпилироваться вообще
Алексей
А будет вообще кому-нибудь интересно если я это исследование по скорости работы и памяти оформлю в виде статьи и выпущу ну скажем на habr?
Tishka17
Да вроде все очевидно, не?
Tishka17
Про то, как работает все в каждом из указанных языков сто раз писали
 Alexey
Подскажите возможно ли в pytest-xdist сделать один коннект к базе данных а не по коннекту на каждый слейв? Или есть ему какая-нибудь альтернатива для распараллеливания тестов?
Tishka17
Подскажите возможно ли в pytest-xdist сделать один коннект к базе данных а не по коннекту на каждый слейв? Или есть ему какая-нибудь альтернатива для распараллеливания тестов?
Кстати, а как вы чистите базу между тестами?
Tishka17
Хотя если слейвы, наверно у вас ридонли соединение
Alexey
Чищу перед тестами, у каждого слейва свой кусок тестовых данных
Tishka17
А как гарантируете, что тест не разломает всю базу?
 Ihor
А Как можно обрубить доступ к видеопотоку? Ну и с другого додатка?
Tishka17
Есть какая-то методология подготовки тестовых данных?
Ihor
Есть видеопоток и надо показывать по подписке и только на одном домене
 Kirill
Кстати, а как вы чистите базу между тестами?
Можно для каждого "потока" создавать свою "копию" базы.
Tishka17
Можно для каждого "потока" создавать свою "копию" базы.
Вот мне интересно, как нормальные люди это делают
Alexey
А как гарантируете, что тест не разломает всю базу?
С этим не было проблем никогда, удаляю только то что создал в текстах и будет мешать в будущем
Tishka17
С этим не было проблем никогда, удаляю только то что создал в текстах и будет мешать в будущем
А как делаешь в такой ситуации: одному тесту нужна пустая база, другому - заполненная.
Alexey
Можно для каждого "потока" создавать свою "копию" базы.
Не, мне не нужно 30 баз
Kirill
Вот мне интересно, как нормальные люди это делают
Не знаю на сколько я нормальный, но у меня тесты при старте, в сессионных фикстурах запускают докер-контейнеры с нужными базами (оптимизированными для тестов). Поэтому активация xdist просто буде в каждом потоке поднимать свой контейнер с базой
Tishka17
Kirill
Сколько времени выполняется?
На ssd довольно быстро, особенно по сравнению с временем работы самих тестов
Kirill
Ну и оно ведь только один раз запускается, а дальше уже отдельная фикстура чистит базу перед каждым тестом
Alexey
На базу юай и ресты завязаны, тестирую юай и ресты, это все очень громоздкое, запускаю в 30 потоков
Alexey
Они иногда конфликтуют, мне нужен 1 коннект
Tishka17
Или как сказал @cykooz под каждый поднимай свою базу
Kirill
Они иногда конфликтуют, мне нужен 1 коннект
А чем поможет один конект, если у тебя в базе будут "шаренные" между разными тестами данные?
Tishka17
В одном коннекте будет вообще отстой, у тебя начнут транзакции смешиваться
Tishka17
Ну и хз как Коннект шарить между тредами
 👑OGURCHIK🖤
Check_thread = false
👑OGURCHIK🖤
🤔
Kirill
Надёжнее в каждом потоке создавать отдельную базу с уникальным именем, и работать с ней.
Tishka17
)) ну типа ждать пару часов не хочется вместо 15 минут
Так я начал с вопроса: как конфликтов избегаете
Tishka17
Оказывается никак
twisted.sonnet
 twisted.sonnet
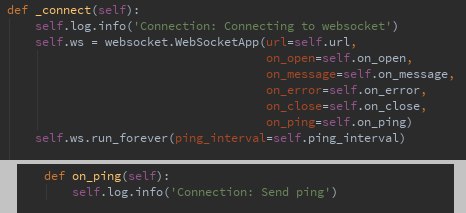
он же по идее отсылается каждый раз в установленный период в ping_interval=? или я дурак?
Alexey
Оказывается никак
)) ну единственный конфликт который у меня случается это сработывает юник констрейнт когда я вставляю что-то через сиквенс.некствелуе а его уже другая сессия использовала
Alexey
Я думал что если что-то делать и коммитить в рамках одной сессии то такой проблемы не будет
Kirill
)) ну единственный конфликт который у меня случается это сработывает юник констрейнт когда я вставляю что-то через сиквенс.некствелуе а его уже другая сессия использовала
Значит повезло. В дальнейшем может стать только хуже
Kirill
)) ну единственный конфликт который у меня случается это сработывает юник констрейнт когда я вставляю что-то через сиквенс.некствелуе а его уже другая сессия использовала
И если это у тебя основной код так работает с секвенсами, то у тебя проблема побольше чем просто конфликты в тестах.
 Dmitry
помогите кто-нибудь(((
имел кто-нибудь дело с concurrent.futures.ThreadPoolExecutor ?? у вас ошибки были с его использоывавнием?
👑OGURCHIK🖤
Dmitry
ох какие строгие))
Dmitry
я просто привык к флуду в таких чатах
👑OGURCHIK🖤
Ну тогда спрашивай там где привык
Dmitry
там шарписты, они в питоне не шарят
 Dmitry