почему?
патамушта
 Алексей


 tfhx8
можно же файл целиком не читать
Алексей
его надо будет прочитать от начала до конца
tfhx8
тоесть чтоб он в оперативу не загружался весь
Алексей
причём тут оператива вообще?
tfhx8
а считать данные по ходу, забыл как называется такой метод считывания б ольших файлов, у кого оперетивые мало
Алексей
ты понимаешь, что последовательно читать 100гб файл - это не быстро
tfhx8
его надо будет прочитать от начала до конца
разве нельзя прочитать от начала и до конца, если к примеру файл больше по размеру чем оператива?
 👑OGURCHIK🖤
tfhx8
ты понимаешь, что последовательно читать 100гб файл - это не быстро
ну сколько? Ну сутки, ну пусть неделя. Главное сделать файл с индексами
👑OGURCHIK🖤
🤔
Алексей
ну сколько? Ну сутки, ну пусть неделя. Главное сделать файл с индексами
а, если плевать, то читай
Алексей
вперёд
Алексей
почему нельзя?
Алексей
можно
👑OGURCHIK🖤
🤔100гб
👑OGURCHIK🖤
Ля
Алексей
если тебе не жалко кучи времени, то можно
Алексей
ну или можно сделать как я предложил изначально и это будет работать меньше секунды без предварительной обработки
tfhx8
вы как думаете, если будет файл со смещениями, и будет 1000 потоков который "одновременно" будут получать данные по рандомному смещению, то скорость будет меньше 0.0001s?
tfhx8
скорость считывания такой строки
Алексей
нет
tfhx8
тогда хренова
Алексей
но ты можешь сгенерировать 1000 рандомных строк меньше чем за 0.0001s (наверное)
Алексей
и никто не будет проверять есть ли они в этом файле или нет
tfhx8
но ты можешь сгенерировать 1000 рандомных строк меньше чем за 0.0001s (наверное)
не, мне нужны строки именно в файле). Тогда наверно этот большой файл разбить на n файлов с 10к строками к примеру, где также на каждый файл сделать файл со смещениями. Чтобы увеличить скорость взятия строки.
Алексей
хорошая идея, точно сработает как надо (нет)!
Алексей
и тебе кстати тыщу потоков не помогут
Алексей
потому что тут скорее всего всё упрётся в дисковый IO
tfhx8
тут видимо как то нужно на ходить оптимальное решение
tfhx8
сколько файлов и по сколько строк лучше сделать
tfhx8
или же 1 файл со всеми строкками
Алексей
тут задача толком не сформулирована
Алексей
так что оптимальное решение сложно будет найти
tfhx8
что не понятного в задачи? Есть большой файл, надо считывать рандомно строки в 1000 запущенных потоков. Как сделать это быстрее и эффективнее именно для считывания строки. Я не совсем понимаю чем на уровне железа будет отличаться считывания строки с одного файла или с мелких. Может овчинка выделки не стоит, все на мелкие делить и по скорости также будет
Wqw
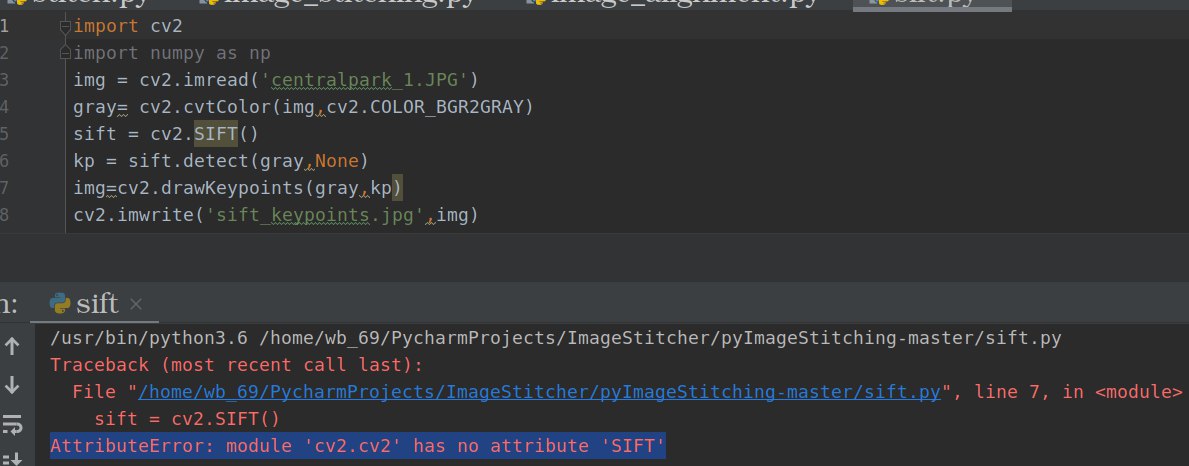
Всем привет)Возникает такая ошибка:AttributeError: module 'cv2.cv2' has no attribute 'SIFT'.Ничего дельного в интернете по устранению проблемы не нашёл, пример если что брал из документации
 c
алибаба и 1000 запущенных потоков
 Tishka17
что не понятного в задачи? Есть большой файл, надо считывать рандомно строки в 1000 запущенных потоков. Как сделать это быстрее и эффективнее именно для считывания строки. Я не совсем понимаю чем на уровне железа будет отличаться считывания строки с одного файла или с мелких. Может овчинка выделки не стоит, все на мелкие делить и по скорости также будет
это не задача, это какой-то промежуточный этап решения большой задачи
Алексей
что не понятного в задачи? Есть большой файл, надо считывать рандомно строки в 1000 запущенных потоков. Как сделать это быстрее и эффективнее именно для считывания строки. Я не совсем понимаю чем на уровне железа будет отличаться считывания строки с одного файла или с мелких. Может овчинка выделки не стоит, все на мелкие делить и по скорости также будет
почему 1000 потоков? откуда файл взялся, насколько большой, зачем это всё надо? какое распределение у рандома?
Tishka17
100 гигабайт текста, 1000 потоков
Tishka17
охуенное ТЗ
c
Tishka17
почему не 1 петабайт и миллиард потоков?
c
cv2 надо импортировать
c
код и трейсбэк в студию
tfhx8
просто такое хрен нагуглишь, поэтому тут и написал
Wqw
 Алексей
такие задачи решают субд, вроде постгреса
его не устроило гипотетическое решение в виде гипотетической субд его гипотетической задачи
tfhx8
почему 1000 потоков? откуда файл взялся, насколько большой, зачем это всё надо? какое распределение у рандома?
распределение рандома будет идти по количеству сформированный индексов, тоесть от 1 до n индексов
Алексей
c
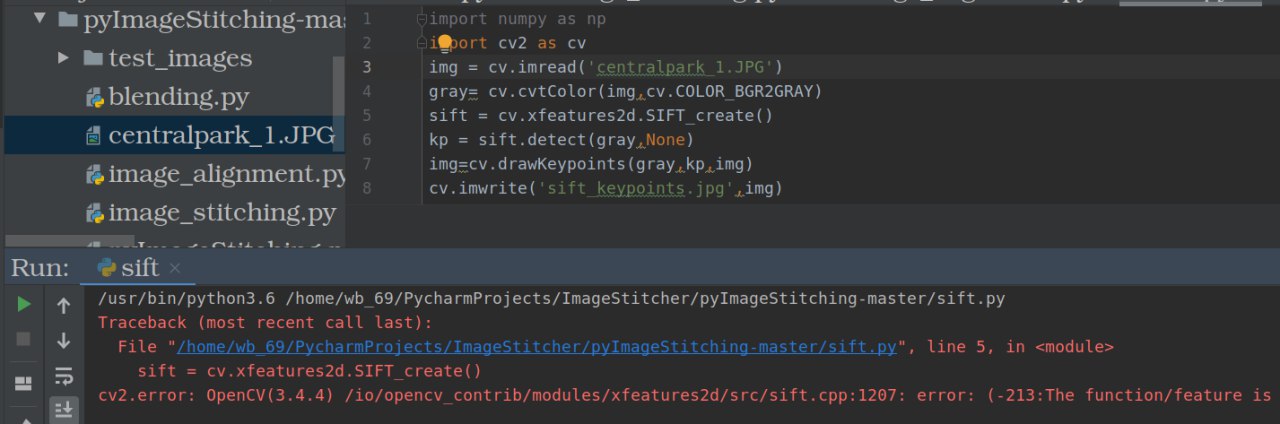
там cv2.xfeatures2d.SIFT_create()
👑OGURCHIK🖤
 Tishka17
распределение рандома будет идти по количеству сформированный индексов, тоесть от 1 до n индексов
ты не ответил на вопросы
 tfhx8
ты не ответил на вопросы
может для железа, что 1 большой файл, что куча мелких по скорости нчего не даст