снаружи не видно, где ручка вызывающая удаление
Да. Но без модерирования оно быстро будет выгнано отовсюду. Спам
 🏳️ Phil


 Sergei
но на голанге в гиг можно вместитья вполне. там два тонких хендлера и сторадж.
Sergei
пойду закажу rpi zero w
Sergei
:D
🏳️ Phil
ну ты б ещё excel-таблицу сделал
В смысле? Я прсто хотел не изобретать свои индексы. Но нет, так не получилось. Но там конечно немного другое. несколько миллионов записей линейно влить в базу
🏳️ Phil
но на голанге в гиг можно вместитья вполне. там два тонких хендлера и сторадж.
Можно и меньше. В принципе, покумекав и не за вечер, с подбором хорошей флешки, без бэкапа это действительно на том же Go пишется даже на просто zero
Sergei
Sergei
бекап того же rocksdb очень дешёвый ;)
Sergei
В смысле? Я прсто хотел не изобретать свои индексы. Но нет, так не получилось. Но там конечно немного другое. несколько миллионов записей линейно влить в базу
дядь, правда, миллион записей это не то, чем стоит пугать в 2020.
🏳️ Phil
вчера ты другое говорил ;)
Ну может вы меня уболтали. Но в итоге мы вообще ушли от изначальной темы. То что мым тут обсудили тупо нерентабельно
Sergei
Ну может вы меня уболтали. Но в итоге мы вообще ушли от изначальной темы. То что мым тут обсудили тупо нерентабельно
конечно. правда написание сокращателя урлов на пхп более нерентабельно.
Sergei
я вообще стриггерился на то что ты привёл проект как серьёзный и тяжёлый
🏳️ Phil
дядь, правда, миллион записей это не то, чем стоит пугать в 2020.
Не, ну слушай, велкам. Не то чтобы это имело бы какую-то цель, но записать миллион записей хоть в какой-нибдуь k/v оказалось задачей не очень простой. Делать свою с деревом я не пробовал. В итоге я просто отказался от записи на диск, потому что цена подьёма их xml оказалась 20-40 секунд, никакая запись даже близко не подходила, смысла продолжать изыскания не было.
Но я с удовольствием послушаю, где я облажался и про непроблемы миллиона записей
 Vladimir
🏳️ Phil
конечно. правда написание сокращателя урлов на пхп более нерентабельно.
Это был питон. Я думаю, он им и остался
Sergei
проверить есть ли домен или урл в списке заблокированных
если там ещё с адресами и баны есть по айпи, то надо дерево пилить
🏳️ Phil
непонятно. тебе сложно описать?
Ммм... Если всё ещё нужно - я попробую. Да, вощникла сложность с быстрым описанием
Sergei
а то в v6 материализовать нельзя
Sergei
Ммм... Если всё ещё нужно - я попробую. Да, вощникла сложность с быстрым описанием
просто асимметрия усилий. мне надо реверсить твоего бота.
Sergei
я не чтобы поиздеваться. мне кажется, что там упущено какое-то быстрое решение и так-то я помочь хочу и мне интересно.
Sergei
задача "залить миллион значений в k-v базу" вызывает недоумение
🏳️ Phil
ну задача по факту оказалось ложной. она не нужна ни для чего. но поскольку я попытался так сделать, то мнение имею :))
Sergei
Sergei
Потыркал пару готовых k/v и начал в них заливать
какой тип данных и сколько? как сэмулировать?
🏳️ Phil
какой тип данных и сколько? как сэмулировать?
https://youtu.be/zwzaS8OWapY я тут самый первый. Устал, доклад делал в упор. Но описываю что как
🏳️ Phil
какой тип данных и сколько? как сэмулировать?
P.S. Это было бессмысленно. Это по факту действительно не надо. Я хотел память поэкономить за счет диска, но по факту это не надо
Sergei
да я всё пытаюсь выяснить, что нужно сделать с “обычной k->v” чтобы миллион записей был проблемой
🏳️ Phil
Ну вот
Sergei
каких записей-то :(
🏳️ Phil
https://github.com/usher2/gck022020 презенташка
🏳️ Phil
https://github.com/usher2/gck022020/blob/master/ru/dumpparsing.pdf она же скомпиленная
Vladimir
https://github.com/usher2/gck022020/blob/master/ru/dumpparsing.pdf она же скомпиленная
а есть код работы с bbolt'ом?
Sergei
я просто щас НА ПИТОНЕ вставляю в редис 5000 строк в секунду
🏳️ Phil
а есть код работы с bbolt'ом?
Нет скорее всего. Я там в какой-то момент пароль в github вогнал и порезал ревизии
🏳️ Phil
а есть код работы с bbolt'ом?
Ты намекаешь на то, открывал я на каждую сроку транзакцию или одну на всё? Вроде и так, и так попробовал
Vladimir
Ты намекаешь на то, открывал я на каждую сроку транзакцию или одну на всё? Вроде и так, и так попробовал
я не намекаю ни на что, мне просто интересно было бы посмотреть на код, вдруг будет понятно почему так медленно
Vladimir
но если кода нет, то и ладно
🏳️ Phil
Случайно, но нет. Самому уже интересно стало. Я хочу намекнуть, что я хотел это вогнать в гиговую VDS
Sergei
6 мегабайт на элемент в XML - потенциально больно, но это вполне решается SAX-парсером
Sergei
ага, учитывая, что мы лезем внутрь - это малобольно
🏳️ Phil
Ну там вообще я про парсер много
 Alexander
я не вижу проблем и согласен с сергеем что даже с учетом бэкапа и прочего это пишется за рабочий день программистом средней руки
"любой второкурсник справится" :)
Sergei
не очень понятно, почему время разбора так важно, если ты говоришь про узкое место в базе.
в принципе у тебя разбор идёт параллельно с вставкой.
 Aleksey
сейчас толсятки из гигантов поправят код щорса и будет 128 байт на всю работу
 Aleksey
на 0.02m cpu
Sergei
скажи, а что аудитория в этот момент сказала? :)
Sergei
не очень понятно, зачем ты парсил IP-адрес, если база это будет делать потом повторно. или не будет?
Sergei
xxhash еще получше будет
🏳️ Phil
не очень понятно, почему время разбора так важно, если ты говоришь про узкое место в базе.
в принципе у тебя разбор идёт параллельно с вставкой.
Время разбора важно, чтобы очередь не копилась. Я просто взял минимальные промежутки между порциями данных. Ну и конечно психологическое число
Sergei
а зачем ты обратно в XML преобразовывал???
Sergei
Время разбора важно, чтобы очередь не копилась. Я просто взял минимальные промежутки между порциями данных. Ну и конечно психологическое число
кажется, что тебе можно вставлять в базу прямо в процессе парсинга. непонятно, зачем ты консолидируешь всё в раме.
Sergei
Что не так?
то что волатильная мапа без указателей становится очень тяжёлой. ты ж сам об этом говоришь в следующем слайде.
просто от кода, где мапка на структуру без указателя мне сразу стало больно. и в следующем слайде ты сказал о боли. я подозреваю, что аудитория испытала похожие эмоции.
🏳️ Phil
а зачем ты обратно в XML преобразовывал???
Посчитать хэш всего <content >...</content> включая возможно изменившиеся аттрибуты. Я до сих пор помню - переписал эту часть в Сапсане после Хайлоада, и полвагона пялилось на наклейки Go и повербанк с лого Хайлода. Это отвлекало
Sergei
🏳️ Phil
кажется, что тебе можно вставлять в базу прямо в процессе парсинга. непонятно, зачем ты консолидируешь всё в раме.
Мы где-то разошись в синхронизации показаний. Я отказался в итоге от пихания в базу. Или я не понимаю вопроса
Sergei
Мы где-то разошись в синхронизации показаний. Я отказался в итоге от пихания в базу. Или я не понимаю вопроса
мне казалось что здесь ты читал XML и пихал в k->v базу, не?
Sergei
 Sergei
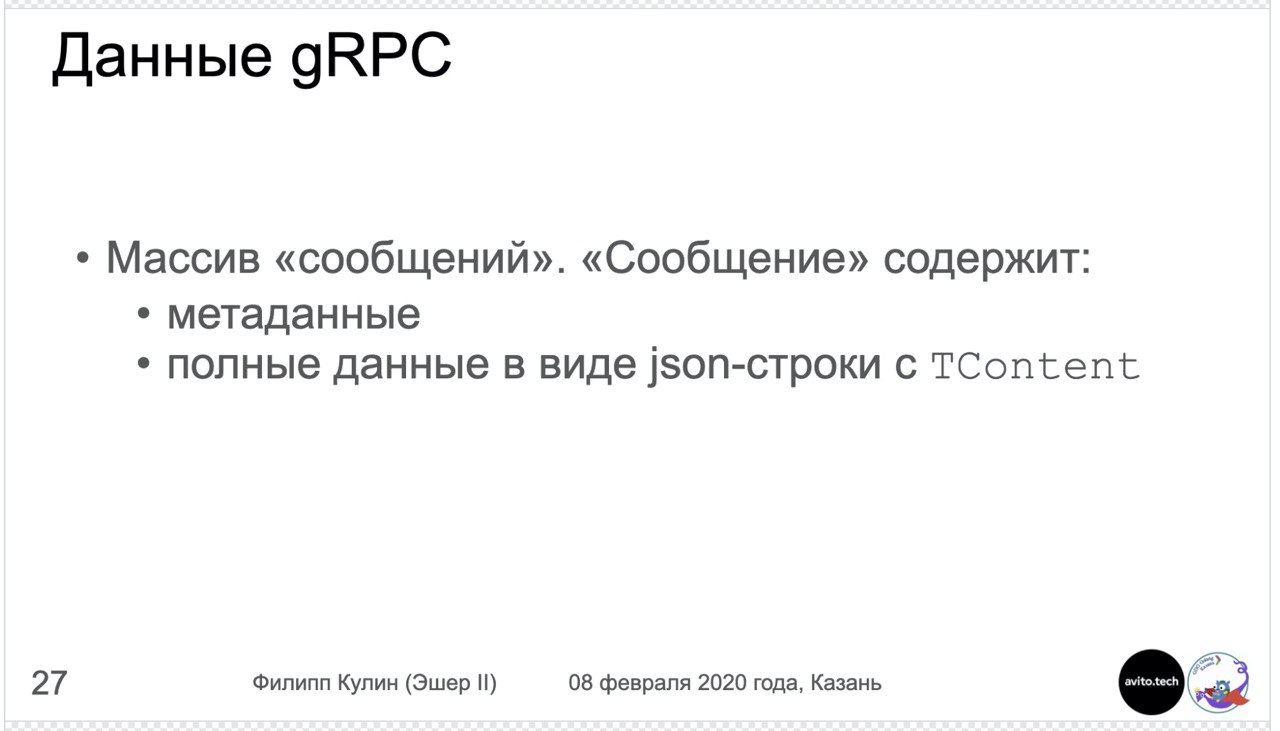
блин, я однажды пошутил про то что кто-то будет пихать JSON или XML прямо сырыми в типизированные форматы типа Protobuf
Sergei
сколько я потом видел это в реальной жизни...
🏳️ Phil
то что волатильная мапа без указателей становится очень тяжёлой. ты ж сам об этом говоришь в следующем слайде.
просто от кода, где мапка на структуру без указателя мне сразу стало больно. и в следующем слайде ты сказал о боли. я подозреваю, что аудитория испытала похожие эмоции.
Да понимаешь... Аудитория похоже вообще была не готова к такому разбору. Кстати, а поясни мне этот момент. Я не уверен, что я до конца понял что случилось. Это прямо вообще очень яркая произошедшая хрень
Sergei
Да понимаешь... Аудитория похоже вообще была не готова к такому разбору. Кстати, а поясни мне этот момент. Я не уверен, что я до конца понял что случилось. Это прямо вообще очень яркая произошедшая хрень
если мапка хранит элементы прямо в себе, то в момент роста она должна переместить гораздо больше данных в оперативе
Sergei
когда хеш-таблица скейлится
🏳️ Phil
мне казалось что здесь ты читал XML и пихал в k->v базу, не?
Я хотел. И сделал. Но потом отказался. Я там же рассказываю про это
🏳️ Phil
Sergei
вместо перезаписи указателей с места на место ей приходится копировать сами данные. как ты говоришь твоя TContent - толстая, до шести мегабайт. в результате в раме вместо условных (50 байт на элемент * миллион элементов = 50 мбайт) ты перемещаешь (мегабайт на элемент * миллион элементов = терабайт)
Sergei
впрочем, похоже, что у тебя средний размер таки не мегабайт
🏳️ Phil
если мапка хранит элементы прямо в себе, то в момент роста она должна переместить гораздо больше данных в оперативе
Ну для меня не совсем понятно. Этот TContent 244 байта что ли. 8 vs 244 не прямо смущает. Но по факту похоже там охрененно дорогой grow, что прямо вот вообще заметно
Sergei
Ну для меня не совсем понятно. Этот TContent 244 байта что ли. 8 vs 244 не прямо смущает. Но по факту похоже там охрененно дорогой grow, что прямо вот вообще заметно
ну емое, это на элемент. ты ж сам говоришь что у тебя миллион элементов.
это 244 мегабайта памяти, причем мапка делает не потоковый доступ, это постоянно кеш-мисс
Sergei
я не очень понимаю, почему там 244 байта, ты ж говоришь что у тебя может быть 6 МБайт на элемент?
🏳️ Phil
вместо перезаписи указателей с места на место ей приходится копировать сами данные. как ты говоришь твоя TContent - толстая, до шести мегабайт. в результате в раме вместо условных (50 байт на элемент * миллион элементов = 50 мбайт) ты перемещаешь (мегабайт на элемент * миллион элементов = терабайт)
Не, ну 6Mb это данных под TContent. Сама-то она 2xx байт. Там же строки да указатели
🏳️ Phil
я не очень понимаю, почему там 244 байта, ты ж говоришь что у тебя может быть 6 МБайт на элемент?
Я ей чтотото там рантйм сайзоф сделал
Sergei
один хрен.
ты парсишь XML похоже на правду, но неочевидно, не ломаешь ли ты там дрова.
история с JSON отъедает перформанса еще некисло так.
на чуть более высоком уровне что там происходит?
у тебя есть XML с выгрузкой, ты эту выгрузку как-то парсишь и нормализуешь, а потом что? как ты используешь результат парсинга?