Ты сами pvки мониторишь?
Скажем с нуля поднял тачку есть два дам один дефолтный при создании тачки с разными патрициями. Другой отделений новый дам на /opt .
 Martin

 Martin
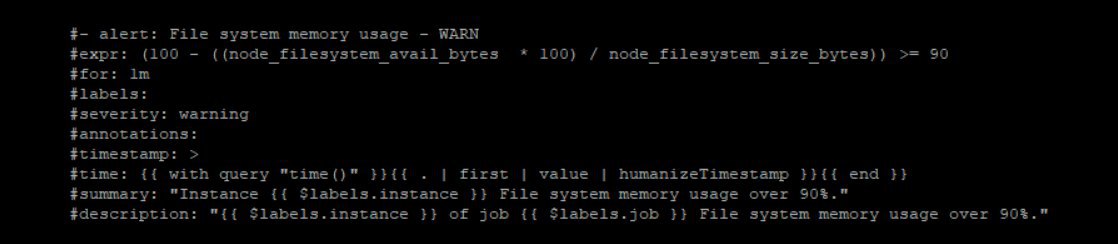
И он не корректно подсчитывает процент занятого места.
 George
Ну, ок
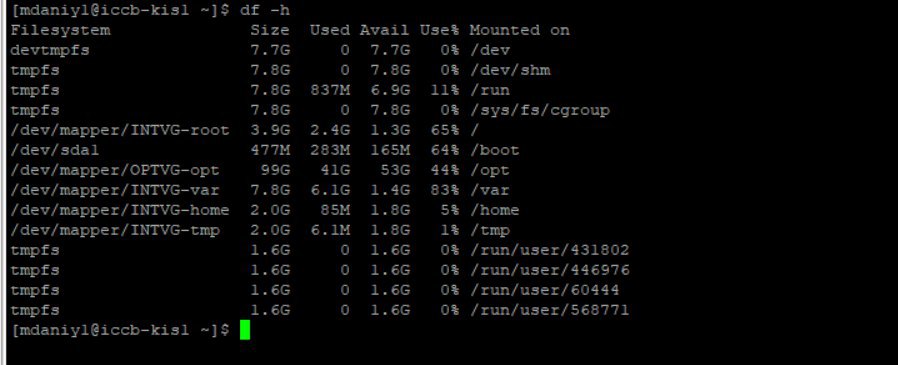
Но вообще так помочь невозможно - никаких конкретных данных. Ни версии node exporter, ни метрики и выхлопа df -h
Martin
Martin
 Martin
 Andrii
всем привет, может быть кто-то подскажет, хочу поднять кластер эластика в докера на 3 нодах
docker-compose.yml на всех 3 нодах одинаковый
cat docker-compose.yml
version: '2'
services:
elasticsearch:
image: docker.elastic.co/elasticsearch/elasticsearch:5.0.2
restart: always
container_name: elasticsearch
environment:
- bootstrap.memory_lock=true
- "ES_JAVA_OPTS=-Xms6g -Xmx6g"
- xpack.security.enabled=false
- "discovery.zen.ping.unicast.hosts=real_ip_node1:9500,real_ip_node2:9500,real_ip_node3:9500"
ulimits:
memlock:
soft: -1
hard: -1
ports:
- "9400:9200"
- "9500:9300"
volumes:
- ./hunspell:/usr/share/elasticsearch/config/hunspell
- esdata:/usr/share/elasticsearch/data
- ./elasticsearch.yml:/usr/share/elasticsearch/config/elasticsearch.yml
- /backup_es/snapshot:/backup_es/snapshot
volumes:
esdata:
driver: local
тут меняется только node.name
cat elasticsearch.yml
node1
cluster.name: docker
node.name: n1
network.host: 0.0.0.0
bootstrap.memory_lock: true
xpack.monitoring.enabled: false
cluster.routing.allocation.disk.threshold_enabled: false
discovery.zen.minimum_master_nodes: 2
transport.host: 0.0.0.0
path.repo: ["/backup_es/snapshot"]
node2
cluster.name: docker
node.name: n2
network.host: 0.0.0.0
bootstrap.memory_lock: true
xpack.monitoring.enabled: false
cluster.routing.allocation.disk.threshold_enabled: false
discovery.zen.minimum_master_nodes: 2
transport.host: 0.0.0.0
path.repo: ["/backup_es/snapshot"]
docker exec -it elasticsearch env
PATH=/usr/share/elasticsearch/bin:/usr/local/sbin:/usr/local/bin:/usr/sbin:/usr/bin:/sbin:/bin
HOSTNAME=c08afe882535
TERM=xterm
bootstrap.memory_lock=true
ES_JAVA_OPTS=-Xms6g -Xmx6g
xpack.security.enabled=false
discovery.zen.ping.unicast.hosts=real_ip_node1:9500,real_ip_node2:9500,real_ip_node3:9500
JAVA_HOME=/usr/lib/jvm/java-1.8-openjdk
HOME=/usr/share/elasticsearch
в логах второй ноды
[2019-09-22T12:37:38,791][WARN ][o.e.d.z.ZenDiscovery ] [n2] failed to connect to master [{db3}{FfkGHzdXT-OJhZ8XWZf1BQ}{Mydsy6sqTOOBSZSrszMjsA}{172.23.0.2}{172.23.0.2:9300}], retrying...
org.elasticsearch.transport.ConnectTransportException: [n1][172.23.0.2:9300] connect_timeout[30s]
на первой ноде curl 127.0.0.1:9400/_cat/nodes?v
[2019-09-22T12:38:06,686][WARN ][r.suppressed ] path: /_cat/nodes, params: {v=}
org.elasticsearch.discovery.MasterNotDiscoveredException
at org.elasticsearch.action.support.master.TransportMasterNodeAction$AsyncSingleAction$5.onTimeout(TransportMasterNodeAction.java:214) [elasticsearch-5.0.2.jar:5.0.2]
с первой ноды
docker inspect -f '{{range .NetworkSettings.Networks}}{{.IPAddress}}{{end}}' elasticsearch
172.23.0.2
с второй
docker inspect -f '{{range .NetworkSettings.Networks}}{{.IPAddress}}{{end}}' elasticsearch
172.25.0.2
что не так с настройками, почему он коннектится со второй ноды к первой через внутренние айпишки докера или может кто-то такое уже настраивал и поделится конфигами?
Martin
 George
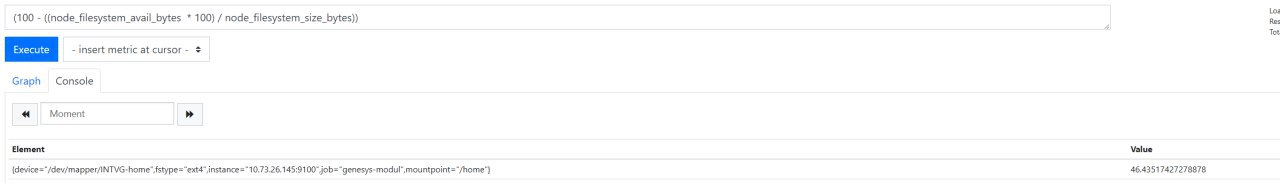
Чтобы понять в чем дело - надо взять ноуд экспортер и в текстовом виде поглядеть на сами значения пустого места
Martin
Отдели проблему с алертом и с метрикой - это для начала
ок не получаю правилный алерт насчет юзед спеис
George
Я уж не говорю о том, что ценности совать эластик в докер особо нет, если ноды все равно выделенные
Andrii
Я уж не говорю о том, что ценности совать эластик в докер особо нет, если ноды все равно выделенные
там будет не только эластик на нодах, но надо в докере, почему нельзя в докере это все поднять? почему такие сложности?
George
там будет не только эластик на нодах, но надо в докере, почему нельзя в докере это все поднять? почему такие сложности?
Кто сказал, что надо в докере?
George
😳
George
Для вдохновения
George
https://github.com/cloudalchemy/ansible-prometheus/blob/384ce839888b8f082deba130aae87d1a108e472c/defaults/main.yml#L122
 Navern
Пусть в доцкере поднимает, норм тема
 Евгений
И он не корректно подсчитывает процент занятого места.
Это касается только thin provisioning, с нормальными разделами node_exporter нормально работает
George
https://github.com/samber/awesome-prometheus-alerts/blob/f7f94ed81ed389d0e29e8996cebc6b984e920da8/_data/rules.yml#L68
George
Это касается только thin provisioning, с нормальными разделами node_exporter нормально работает
Реально подтверждаешь проблему ?
George
Пока коллега разбирается со странными проблемами - я б уже ансиблом раскатил эластик официальным или полуофициальные плейбуком
George
Я уж не говорю, что при _пересоздании_ контейнера у него хостнейм поменяется
Как отреагирует стейтфул приложение типа эластика на это - хз.
(*) Можно хостнеймы и айпи в докере зафиксировать.
 Старый
George
А чего сразу не в кубернетесь?
Евгений
Реально подтверждаешь проблему ?
Ну это полгода назад было, даже больше, когда я ловил с thin provisioning проблемы типа свободное место считалась от реального размера thin pool'а
Andrii
Я уж не говорю, что при _пересоздании_ контейнера у него хостнейм поменяется
Как отреагирует стейтфул приложение типа эластика на это - хз.
(*) Можно хостнеймы и айпи в докере зафиксировать.
так проблема в том, что 2 нода коннектится по внутреннему айпишнику к 1 ноде, почему не по real ip ноды?
[2019-09-22T12:37:38,791][WARN ][o.e.d.z.ZenDiscovery ] [n2] failed to connect to master [{db3}{FfkGHzdXT-OJhZ8XWZf1BQ}{Mydsy6sqTOOBSZSrszMjsA}{172.23.0.2}{172.23.0.2:9300}], retrying...
org.elasticsearch.transport.ConnectTransportException: [n1][172.23.0.2:9300] connect_timeout[30s]
George
Бридж выкинуть. Сделать network host mode
George
Тогда эластики сконнектятся.
George
Инфа 💯%
George
Все остальное - сильно сложнее (либо всё-таки вынести эластик из докера)
 kSandr
а ктонить конфигурил fluent-bit ? может проконсультировать ?
George
Ох
George
Спрашивай конкретные вопросы
George
Если что - есть @ru_logs
George
😂😂😂😂
George
У нас есть только один идеолог рсислога
Navern
он за весь чат работает) по-моему он и в этом чате есть)
Andrii
Бридж выкинуть. Сделать network host mode
а какие вообще подводные камни могут быть кластер эластика в докере?
George
а какие вообще подводные камни могут быть кластер эластика в докере?
Любые. Прилетят инопланетяне и заберут твой кластер
George
А если серьезно - ты ведь даже TZ в контейнере не выставлял ?
George
Мы, например, очень прикольно выстрелили в ногу себе как. Гитлаб. В докере. На центось. Используется devicemapper. Гитлаб пишет логи на эфемерный слой контейнера (wat!!??). Упёрлись в ограничение 10 гиб на контейнер
Сказать, что оно очевидное - ничего не сказать
George
нет, я про смену hostname и т.д.
А, ну, да - вообще инстанс может подумать, что он это не он. И прохерит данные
Но это больше не к эластику, а вообще. В целом
Andrii
А если серьезно - ты ведь даже TZ в контейнере не выставлял ?
ты про ?
environment:
- "TZ=Asia/Yekaterinburg"
я пока на тесте это все поднимал, тестил TZ пока не нужен был
Navern
Мы, например, очень прикольно выстрелили в ногу себе как. Гитлаб. В докере. На центось. Используется devicemapper. Гитлаб пишет логи на эфемерный слой контейнера (wat!!??). Упёрлись в ограничение 10 гиб на контейнер
Сказать, что оно очевидное - ничего не сказать
> использовали девайсмаппер
> пострадали
Не испытал сочувствия как-то
George
ты про ?
environment:
- "TZ=Asia/Yekaterinburg"
я пока на тесте это все поднимал, тестил TZ пока не нужен был
Да, если не делать, то внутри скорее всего УТС, но гарантировать не могу
George
devicemapper по дефолту в центос, в старой убунте - aufs, в новой - overlay
Navern
Почему ?
ну потому что девайсмаппер + докер это конфигурация которая часто стреляет в ногу тебе. В разных местах в том числе и по перформансу
Navern
devicemapper по дефолту в центос, в старой убунте - aufs, в новой - overlay
в центосе он от жизни бедной
George
Navern
на старом ядре
George
Т.е. ты вообще отрицаешь центос и докер ?
George
Ты только что разрушил мою веру в тебя 😂😂😂
Navern
не зря
Navern
центос8 выйдет и норм будет
Navern
может быть