 release-tracker


Вышла новая версия Carbon, extension for DateTime: 1.29.2
 Poseidon
mysql deprecated,разве нет?
 Anonymous
есть таблица в ней 2 поля
id
table
хочу сделать JOIN с таблицой имя которой хранится в столбце table, такое реально делать? если да, то как?
Poseidon
Ну так я и спрашиваю
 Andrey
есть таблица в ней 2 поля
id
table
хочу сделать JOIN с таблицой имя которой хранится в столбце table, такое реально делать? если да, то как?
Советую почитать про "нормальные формы"
 Luka
Подскажите, как правильней сделать. Нужно определить существует ли ячейка в таблице базы данных, чтобы ошибка не сработала
Anonymous
Советую почитать про "нормальные формы"
таблицы уже существуют, большой проект, мне просто интересно возможно ли динамически подставлять значение столбца как имя таблицы
 1Bot
Рнр уже без баз данных никак
 Nikita 🔥
Ребята
Nikita 🔥
всем привет
Nikita 🔥
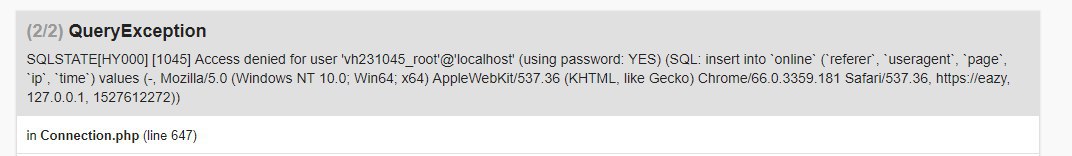
У меня такая проблема, не могу подключиться к бд, использую Laravel
 Igor
Народ, нужна поддержка. Нужно спарсить статьи с сайта ~300 страниц на каждой по 10 статей. Отправляю запросы через guzzle парсинг через simple html dom, фреймворк laravel.
Как у меня всё построено сейчас:
При get запросе на мой сайт (пусть будет '/parse') паралельно отправляются запрос на ссылки всех страниц со статьями чтобы получить массив ссылок на все статьи сайта.
Далее паралельно отправляются запросы по полученным ссылкам, результаты запросов парсятся.
Результаты парсинга выводятся в виде массива на страницу (ларавеловская функция dump() - аналог var_dump())
Я понимаю что как пытаться выводить такой огромный объем данных на страницу разом, так и паралельно отправлять 3000 запросов это извращение.
Если пытаться спарсить за раз около 50 страниц (500 статей) то всё ещё идёт более - менее нормально, но при больших объёмах начинает происходить какая-то дичь.
Собственно вопрос - как правильно спарсить такой объём данных и сохранить его (в бд / файл ... не важно где )?
За любые подсказки и инфу буду весьма признателен
Nikita 🔥
 Nikita 🔥
Как пофиксить?
Nikita 🔥
Мне сайт надо просто запустить, есть ФТП доступ к исходникам и бд
Nikita 🔥
а тут такое
Nikita 🔥
На опенсервер залил, создал бд в phpmyadmin
Nikita 🔥
базу имортировал в phpmyadmin
Nikita 🔥
 Dmitry
я хочу локально запустить
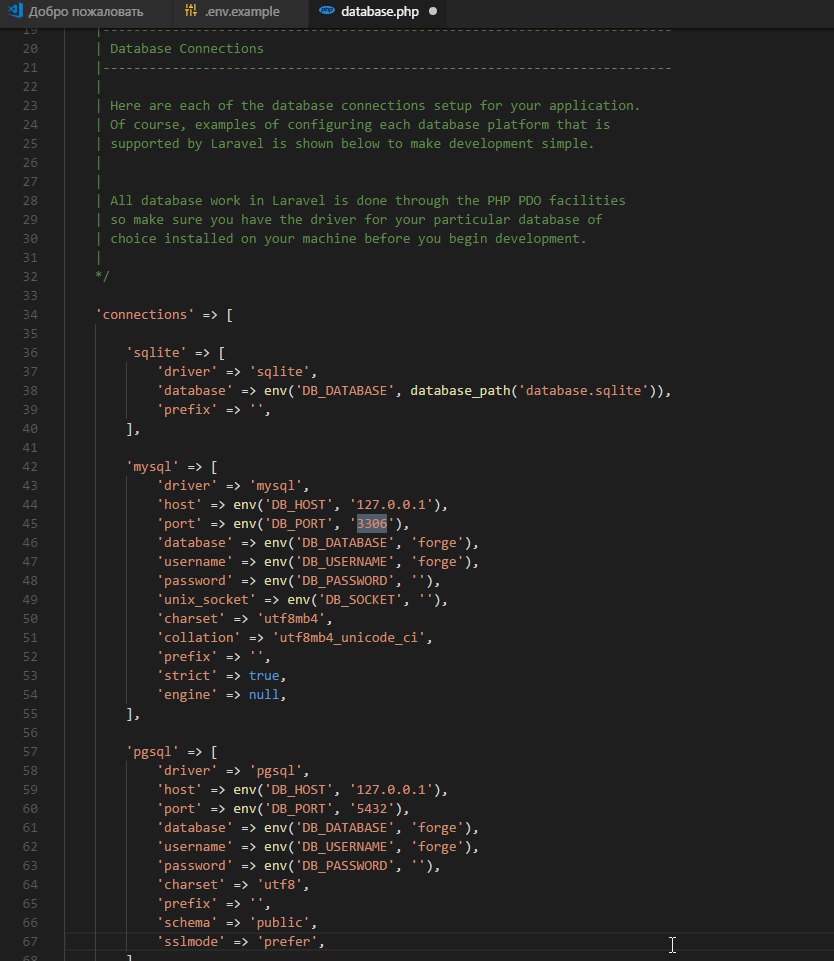
ну запускай. зайди в базу через pma и создай пользователя для этой базы
Dmitry
Nikita 🔥
все
Nikita 🔥
пофиксил
Nikita 🔥
в файле environment поменял
 Golodnyi
Народ, нужна поддержка. Нужно спарсить статьи с сайта ~300 страниц на каждой по 10 статей. Отправляю запросы через guzzle парсинг через simple html dom, фреймворк laravel.
Как у меня всё построено сейчас:
При get запросе на мой сайт (пусть будет '/parse') паралельно отправляются запрос на ссылки всех страниц со статьями чтобы получить массив ссылок на все статьи сайта.
Далее паралельно отправляются запросы по полученным ссылкам, результаты запросов парсятся.
Результаты парсинга выводятся в виде массива на страницу (ларавеловская функция dump() - аналог var_dump())
Я понимаю что как пытаться выводить такой огромный объем данных на страницу разом, так и паралельно отправлять 3000 запросов это извращение.
Если пытаться спарсить за раз около 50 страниц (500 статей) то всё ещё идёт более - менее нормально, но при больших объёмах начинает происходить какая-то дичь.
Собственно вопрос - как правильно спарсить такой объём данных и сохранить его (в бд / файл ... не важно где )?
За любые подсказки и инфу буду весьма признателен
Если ты прекратишь дампить массив на экран, то все спарсится нормально, но в целом твоя задача достойна угнетения, а не поощерения
Dmitry
поздравляю
Igor
Igor
Собственно красть я ничего не собираюсь) Просто делаю сайт для себя так сказать в партфолио. Для сайта нужна бд, и набраться опыта. Вот ставлю себе такие задачи и пытаюсь выполнить. Так или иначе умение парсить всем ведь пригождается, и совсем не обязательно в воровстве контента)
Dmitry
Golodnyi
В эпоху рест апи, парсить никому кроме пиратов не надо)
Dmitry
а так навык так себе
Igor
Тут дело даже не столько в самом парсинге, сколько в побочках - уметь отправлять запросы, работа с файлами, регулярки и тп
Golodnyi
Ты не тем занимаешься, выдуманные задачи так себе портфолио, делай реальные проекты
Igor
Ты не тем занимаешься, выдуманные задачи так себе портфолио, делай реальные проекты
Собственно реальный проект я сделать и хочу, для него бд нужна, а потому я её и парсю
Golodnyi
Собирай БД из открытых источников
Igor
Ставь задачу в очередь и отображай текущий статус
Можно поподробнее пожалуйста? Какую задачу? Как?
Dmitry
Собирай БД из открытых источников
ну тут опять палка о двух концах. сайт в интернете - открытый источник. просто иногда пишут в копирайт грозные словечки
Dmitry
Можно поподробнее пожалуйста? Какую задачу? Как?
https://yandex.ru/search/?text=%D1%82%D0%B0%D1%81%D0%BA%20%D0%BC%D0%B5%D0%BD%D0%B5%D0%B4%D0%B6%D0%BC%D0%B5%D0%BD%D1%82&&lr=146
Golodnyi
Сайт в интернете под копирайтом, открытый источник это когда дают api для выгрузки данных
Igor
Dmitry
Сайт в интернете под копирайтом, открытый источник это когда дают api для выгрузки данных
ты знаешь api у википедии?
Golodnyi
Тот же в киноход даёт актуальную инфу о фильмах в прокате по стране, яндексы, гуглы и много ноунеймов много всего дают
Dmitry
существуют разные лицензии
Dmitry
технически, любой сайт в интернете - свободный
Golodnyi
Если явно не разрешают, значит запрещено
Dmitry
юридически - нет
 Vesper
Народ, нужна поддержка. Нужно спарсить статьи с сайта ~300 страниц на каждой по 10 статей. Отправляю запросы через guzzle парсинг через simple html dom, фреймворк laravel.
Как у меня всё построено сейчас:
При get запросе на мой сайт (пусть будет '/parse') паралельно отправляются запрос на ссылки всех страниц со статьями чтобы получить массив ссылок на все статьи сайта.
Далее паралельно отправляются запросы по полученным ссылкам, результаты запросов парсятся.
Результаты парсинга выводятся в виде массива на страницу (ларавеловская функция dump() - аналог var_dump())
Я понимаю что как пытаться выводить такой огромный объем данных на страницу разом, так и паралельно отправлять 3000 запросов это извращение.
Если пытаться спарсить за раз около 50 страниц (500 статей) то всё ещё идёт более - менее нормально, но при больших объёмах начинает происходить какая-то дичь.
Собственно вопрос - как правильно спарсить такой объём данных и сохранить его (в бд / файл ... не важно где )?
За любые подсказки и инфу буду весьма признателен
не правильная архитектура так делать изначально. Это во-первых должно быть асинхронно, лучше использовать AJAX для вывода на фронт, время работы этого механизма не известно, может вывалится по таймауту. Сам парсер вообще реализовать микросервисом, ларка пусть только фронт рендерит
Golodnyi
а почему не на оборот?
Потому что ты не можешь на улице пнуть каждого, кто явно тебе это не запретил, но можешь того, кто явно это разрешил
Dmitry
Потому что ты не можешь на улице пнуть каждого, кто явно тебе это не запретил, но можешь того, кто явно это разрешил
я могу пнуть каждого. другой вопрос, что мне за это будет
Golodnyi
Отсутствие лицензии в опен соурс воспринимается как no license, это не копируемый контент
 Rodion
А NDA в России и на Украине же не имеет юридической силы и им можно поддереться?
Golodnyi
Сомнительно
Golodnyi
Нда договор
Igor
не правильная архитектура так делать изначально. Это во-первых должно быть асинхронно, лучше использовать AJAX для вывода на фронт, время работы этого механизма не известно, может вывалится по таймауту. Сам парсер вообще реализовать микросервисом, ларка пусть только фронт рендерит
Благодарю за ответ, можно чуть по подробнее пожалуйста? Что такое микросервисы? Что вы имеете ввиду под реализацией через микросервисы? С ajax тоже ещё не работал и что это - представляю слабо. Грубо говоря мне нужна примерная последовательность действий чтобы понять что к чему, что искать и изучать
Vesper
Благодарю за ответ, можно чуть по подробнее пожалуйста? Что такое микросервисы? Что вы имеете ввиду под реализацией через микросервисы? С ajax тоже ещё не работал и что это - представляю слабо. Грубо говоря мне нужна примерная последовательность действий чтобы понять что к чему, что искать и изучать
отдельное приложение, которое будет отвечать чисто за парсинг и можно даже AJAX апишку туда воткнуть, либо разбить на два, парсинг отдельно, AJAX api отдельно. Можно писать такие на ReactPHP, Swoole, Workerman. Ларка будет рендерить фронт, а на фронте JS, который будет дергать данные по AJAX и пока они подготавливаются будет рисовать прогрессбар и тд. Такой подход не удет лочить контекст рендера страницы во время работы тяжелого парсера на сервере, и даст возможность более гибко реагировать на события и информировать пользователя
Igor
отдельное приложение, которое будет отвечать чисто за парсинг и можно даже AJAX апишку туда воткнуть, либо разбить на два, парсинг отдельно, AJAX api отдельно. Можно писать такие на ReactPHP, Swoole, Workerman. Ларка будет рендерить фронт, а на фронте JS, который будет дергать данные по AJAX и пока они подготавливаются будет рисовать прогрессбар и тд. Такой подход не удет лочить контекст рендера страницы во время работы тяжелого парсера на сервере, и даст возможность более гибко реагировать на события и информировать пользователя
Огромное тебе спасибо) Я так понимаю подобные алгоритмы популярная тема?
Igor
Т.е. если что-то тяжеловатое надо - пишутся отдельные приложухи?
Vesper
Благодарю за ответ, можно чуть по подробнее пожалуйста? Что такое микросервисы? Что вы имеете ввиду под реализацией через микросервисы? С ajax тоже ещё не работал и что это - представляю слабо. Грубо говоря мне нужна примерная последовательность действий чтобы понять что к чему, что искать и изучать
ну надо посмотреть сначала что такое AJAX, грубо говоря это асинхронная подгрузка данных на уже отрендеренную страницу. JS в браузере делает http запрос на сервер в фоне, получает данные в JSON парсит и встраивает в страницу
Vesper
Т.е. если что-то тяжеловатое надо - пишутся отдельные приложухи?
конечно, в едином контексте это не делается
Igor
конечно, в едином контексте это не делается
понятно, завтра буду разбираться. Я вижу ты человек опытный, можно к тебе периодически обращаться если какие-то вопросы будут?
Vesper
Т.е. если что-то тяжеловатое надо - пишутся отдельные приложухи?
https://github.com/hellvesper/isblocked/blob/dev/server.php вот например я делал микросервис, который скачивает CSV, парсит его, загоняет в in memory sqlite базу и отдает с нее данные по AJAX запросам в JSON
 Asel
кто знает как получить данные из контакт форм 7? нужно вставить имя и фамилию в другие страницы
Asel
add_action( 'wpcf7_mail_sent', 'your_wpcf7_mail_sent_function' );
function your_wpcf7_mail_sent_function( $contact_form ) {
$title = $contact_form->title;
$submission = WPCF7_Submission::get_instance();
if ( $submission ) {
$posted_data = $submission->get_posted_data();
}
if ( 'Electronic Signature Form' == $title ) {
$yourName = $posted_data['your-name'];
$yourLastName = $posted_data['your-lastname'];
}
}
Asel
не работает :(
Vesper
эм в смысле после поста?
Asel
эм в смысле после поста?
нет я добавила в конце add_shortcode( 'driversinfo', 'your_wpcf7_mail_sent_function' ); и пытаюсь шорткодом вставить инфу на отдельные страницы
Vesper
нет я добавила в конце add_shortcode( 'driversinfo', 'your_wpcf7_mail_sent_function' ); и пытаюсь шорткодом вставить инфу на отдельные страницы
если юзер не запостил форму, то и данных этих еще нет на бекенде
Asel
запостил но не работает все равно