 Олег


а
Олег
т.е. это не 2 кластера
Олег
а 1 кластер с 2 пулами
 Stanley
Я пробовал и два кластера тоже
Stanley
Это я уже пошел проверять на тему "может там ребята что-то не так настроили"
Stanley
rbd ls -c /etc/ceph/ceph.conf -k /etc/ceph/ceph.client.cinder.keyring -n client.cinder -p volumes
Работает
Stanley
Разницы два или один кластер, как я понимаю нет. Синдер и рбд оперируют cepn(x).conf и keyring. Если они разные - он будет считать это все разными кластерами.
По крайней мере, судя по коду - это так
Stanley
Для тестов там еще третий бекенд приделан
Олег
))))
 Artemy
Возвращаясь к теме мульти-бекендов синдера на цефе - кто-либо это вообще пробовал? Чтобы два цефа, два бекенда?
Да весь цеф ВК клауд так работает 😊
Олег
И так. И так. Считай что два кластера
короче вот такой конфиг работает:
[rbd-1]
volume_driver = cinder.volume.drivers.rbd.RBDDriver
volume_backend_name = rbd-1
rbd_pool = volumes
rbd_ceph_conf = /etc/ceph/ceph.conf
rados_connect_timeout = 5
rbd_user = cinder
rbd_cluster_name = ceph
rbd_keyring_conf = /etc/ceph/ceph.client.cinder.keyring
rbd_secret_uuid = 9c635f5c-8049-4f01-8f69-25c17b58bf36
report_discard_supported = True
[rbd-2]
volume_driver = cinder.volume.drivers.rbd.RBDDriver
volume_backend_name = rbd-2
rbd_pool = volumes2
rbd_ceph_conf = /etc/ceph/ceph2.conf
rados_connect_timeout = 5
rbd_user = cinder2
rbd_cluster_name = ceph
rbd_keyring_conf = /etc/ceph/ceph.client.cinder2.keyring
rbd_secret_uuid =
report_discard_supported = True
 Никита
Олег
ток что проверил специально для тебя
Олег
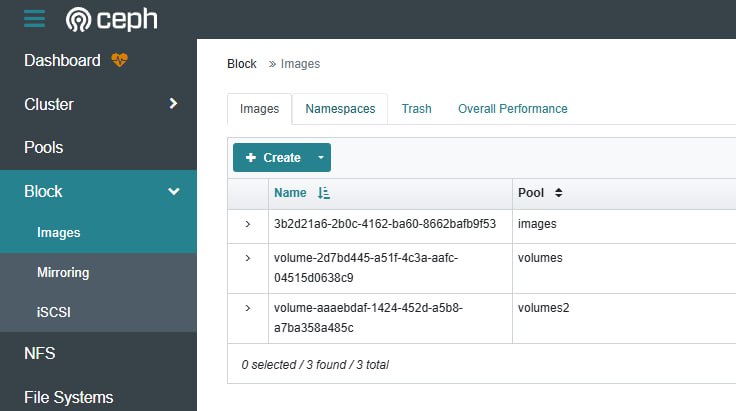
1 кластер, 2 пула, 2 юзера
Олег
 icewolf
вот так работает?
icewolf
а если у тебя два backend один на быстрых дисках другой на крутилках?
Stanley
а если у тебя два backend один на быстрых дисках другой на крутилках?
Тупо два пула и разными классами осд рпзнести
Stanley
Тут речь именно про два разных цефа
Олег
быстро или медленно )
icewolf
Тут речь именно про два разных цефа
два разных кластера два разных агрегейта.. ну в целом а почему бы и нет
Artemy
Рассказывай тогда. А то я в печале...
1. Кластеры должны иметь разные имена
2. Категорически рекомендуется чтобы они имели нестандартные имена (то есть кластера ceph не было. Иначе эта мразь читает по умолчанию ceph.conf и привет
Stanley
Stanley
Я так и знал :(
Artemy
3. rbd_cluster_name, rbd_user делать уникальные для каждого кластера
icewolf
Artemy
Нет, ты с порядком ошибся
Artemy
Правильная схема это "один кластерный N-сервисный бакэнд на каждый цеф"
Stanley
Понятное дело что один цеф лучше. Но вот захотелось мне два
Stanley
О, давай.
Stanley
А то походу Артем прав, надо имена давать уникальные
Stanley
Ща тож катну
Artemy
Ну вот как это делал я тогда - есть кластеры цефа - например ssd1, ssd2, ssd3
Есть кластеры синдера, например ssd1, ssd2, ssd3
В каждом кластере два бакэнда - например
server1@ssd1#poolnamame
server2@ssd1#poolnamame
Оба этих бакэнда ходят на один цеф - на ssd1
Соответственно если у нас три цефа - то три синдеркластера и шесть синдербакэндов
Олег
это ты наверное cinder-volume ноды имеешь ввиду ?
Artemy
Да
Artemy
Ну а если ты с синдеркластерами не выделываешься, ну тогда все просто - уникальные имена кластеров, правильно зашитые кейринги в сикреты в либвирте, правильное указание юзеров.
Artemy
И всё полетит
Stanley
Ну вот как это делал я тогда - есть кластеры цефа - например ssd1, ssd2, ssd3
Есть кластеры синдера, например ssd1, ssd2, ssd3
В каждом кластере два бакэнда - например
server1@ssd1#poolnamame
server2@ssd1#poolnamame
Оба этих бакэнда ходят на один цеф - на ssd1
Соответственно если у нас три цефа - то три синдеркластера и шесть синдербакэндов
Пытаюсь осознать. Но пока не особо хочу
Stanley
Ну а если ты с синдеркластерами не выделываешься, ну тогда все просто - уникальные имена кластеров, правильно зашитые кейринги в сикреты в либвирте, правильное указание юзеров.
Вот походу изза дефольного ceph кластера оно говнится
Artemy
Скорей из-за того, что ты не все нужные параметры перекрыл в синдере.
Stanley
Скорей из-за того, что ты не все нужные параметры перекрыл в синдере.
Все. Один то бекенд нормально взлетает
Artemy
Потому что дефолтный кластер ceph я встречал и с ним было больно но победили
Stanley
Там как раз прикол в том, что rdb ls - работает, а инициация дравера из синдре-волума - нет. Хотя креды одни и те же
Stanley
Не помогло... Ну буду дальше копать. В любом случае пасиб...
Artemy
rbd ls -n <username> -p <poolname> ?
Artemy
Потому как rbd ls вообще без особых указаний идет с кредами client.admin
Stanley
Потому как rbd ls вообще без особых указаний идет с кредами client.admin
Разумеется с полным указанием пользователя, рингов и пула
Stanley
Работает.
Artemy
Там как раз прикол в том, что rdb ls - работает, а инициация дравера из синдре-волума - нет. Хотя креды одни и те же
В конфиге кластера укажи юзера. Кейринг положи в файл /etc/ceph/$clustername.client.$username.keyring
Artemy
Причем именно в файле конфига кластера
Artemy
И явно укажи и rbd_cluster_name и rbd_ceph_conf
Олег
всё работает
Олег
))
Олег
[rbd-1]
volume_driver = cinder.volume.drivers.rbd.RBDDriver
volume_backend_name = rbd-1
rbd_pool = volumes
rbd_ceph_conf = /etc/ceph/ceph.conf
rados_connect_timeout = 5
rbd_user = cinder
rbd_cluster_name = ceph
rbd_keyring_conf = /etc/ceph/ceph.client.cinder.keyring
rbd_secret_uuid = 9c635f5c-8049-4f01-8f69-25c17b58bf36
report_discard_supported = True
[rbd-2]
volume_driver = cinder.volume.drivers.rbd.RBDDriver
volume_backend_name = rbd-2
rbd_pool = volumes2
rbd_ceph_conf = /etc/ceph/ceph2.conf
rados_connect_timeout = 5
rbd_user = cinder2
rbd_cluster_name = ceph
rbd_keyring_conf = /etc/ceph/ceph.client.cinder2.keyring
rbd_secret_uuid =
report_discard_supported = True
[rbd-3]
volume_driver = cinder.volume.drivers.rbd.RBDDriver
volume_backend_name = rbd-3
rbd_pool = volumes
rbd_ceph_conf = /etc/ceph/ceph3.conf
rados_connect_timeout = 5
rbd_user = cinder3
rbd_cluster_name = ceph
rbd_keyring_conf = /etc/ceph/ceph.client.cinder3.keyring
rbd_secret_uuid =
report_discard_supported = True
Олег
даже rbd_cluster_name одинаковый
 Mr
icewolf
Для нее нету рабочей iser почти ни у кого
есть у Oracle но тоже то еще гавнище, особенно в связке с ocfs
Artemy
даже rbd_cluster_name одинаковый
Такие веселые конфиги обычно потом в самых неожиданных местах стреляют
icewolf
Oracle VM Server слышали..? Запах гниения и веблягухи..
Олег
Такие веселые конфиги обычно потом в самых неожиданных местах стреляют
ну в моём случае не выстрелит ))))
Artemy
Ну да, деплой-онли клауд
Stanley
Колла не дает запихнуть rbd_keyring_conf = /etc/ceph/ceph3.client.cinder2.keyring
Сючка
Stanley
Но мы ее победим
Stanley
Все оказалось банально. Колла не пропускала и не копировала кастомный кейринг, требуя чтобы был формат <cluster>.client.cinder.keyring
Stanley
Подкинул руками <cluster>.client.<username>.keyring и все завелось
Stanley
Но колла - дала жару конечно. Потом рольки покопаю чего это она так отрабатывает. Видимо мало кто такой ерундой занимается
icewolf
естественно, колла в данном случае это для разрабов.. развернул стенд на 5-7 нод проверил нагрузки и все.