 Denis


ну короче у нас 20к работали в SNAT и 2к работали в 1:1
Denis
логгинг то в рашке самое знаменитое, а как фсбшникам отвечать?
 Stanislav
ну дык понятно же что аеспи3к
Denis
мы 20к раскидывали по 3натам
Denis
а с этих натов у кого 1:1 нат был - рероутили с них на отдельный сервак, чтобы очереди не набивать в conntrack
Denis
нееее, экстрим только который роутит
Denis
на наты ) на железки
Stanislav
зачем такие сложные железки, на хуовее можно раскидать по src-ip
Stanislav
на свиче)
 Volodymyr
о, машина времени
Volodymyr
я переместился туда
Volodymyr
в моем случае в 2009
Volodymyr
драйвера от яндекса на em
Denis
фряху я проклял тогда когда от pppoe от одного абона сервак завешало так, что даже с клавы не але было ))))))
Denis
сила фряхи!
Denis
у нас там не емки были, а igb вроде уе
Volodymyr
Volodymyr
ух
Denis
именно!
Stanislav
фига
Denis
mpd5 патченное))) бгггг
Stanislav
ну он ж продает вроде
Volodymyr
 Volodymyr
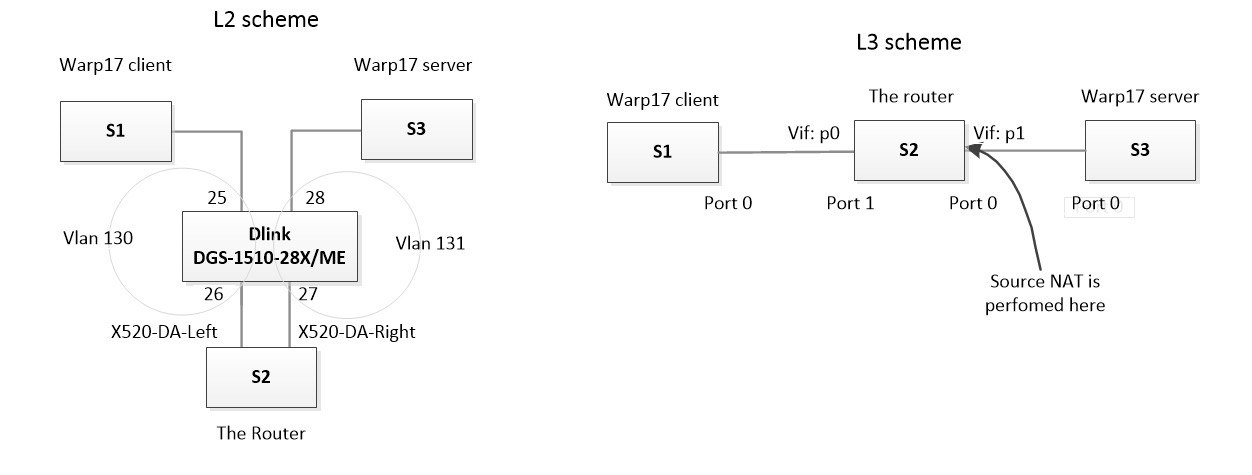
схема с 1510
Volodymyr
это просто ЛОЛ
Denis
да говно кому оно надо вообще уже, да и pptp ну....
Volodymyr
на все 1.5 мегабайта буфера прокачается )
 sexst
ииии ты думаешь ускорится?)))))))
Нужно взять две карты. Каждую воткнуть в слот pci-e, идущий от отдельного сокета. Очереди карьы прибить к ядрам именно того сокета, куда она воткнута. Максимально сделать так, чтобы трафик одной сессии всегда попадал на один и тот же сокет, tx пакета осуществлялся той же очередью и ядром, что и rx. Оперативку взять в максимально быстрой конфигурации.
Denis
да ты задрот, но правильный задрот )))))
sexst
И протянет сильно больше 10G. Там всё в неотимальное перекидывание пакета упирается и в вымывание кеша
Denis
думаешь взять 2 однопортовика и фигануть их к каждому процу?)))
Denis
NUMA это для бестолковых было сделано, но для большего удобства типа
Denis
там и память то в разы дольше работает
Denis
ага )
sexst
думаешь взять 2 однопортовика и фигануть их к каждому процу?)))
Да. Иначе сейчас одна карта ходит ко второму процу через межпроцессорную шину т.е. через жопу и грузит свой процессор + дрочит оперативку неоптимально
sexst
Numa в таких задачах - прямо первое, что нужно учитывать
Denis
хммм надо попробовать!
Denis
да я давно знал что NUMA говно медленное, но не думал что оно так скажется на сетевых операциях, хотя реально..... есть там темы в этом плане
sexst
да я давно знал что NUMA говно медленное, но не думал что оно так скажется на сетевых операциях, хотя реально..... есть там темы в этом плане
NAT в больших масштабах очень завязан на работу с оперативкой.
Denis
не у нас новые, E5 типа, хотя опять таки философский вопрос - что такое старое и что новое?
sexst
Тогда и 9G + 2-3G не было бы)
Denis
на L3 я бы сказал
sexst
Максимально быстрая память, в идеале максимально кешастые процессоры.
Denis
vf?
Denis
без него VPP вообще не взлетит
Volodymyr
Denis вот тебе на сон грядущий
Volodymyr
Dark Packets and the end of Network Scaling
В продолжение графика. В University of California San Diego изучили проблему влияния времени доступа к DRAM на вероятность потери сетевых данных.
Известно, что inter-packet gap для 100GbE около 5.2 нс, а время доступа к DRAM - 100 нс. Учитывая то, что нет возможности вручную выделять себе on-chip LLC (L3 cache) на CPU, то кеширование происходило автоматически и с временем доступа порядка 12 нс.
Даже при ипользованием Intel DDIO и DMA из NIC в L3 cache, получается существенное количество cache-miss, что в свою очередь приводит к необходимости задействования значительно более медленной DRAM. При обозначенных ранее ТТХ DRAM это ожидаемо приводит к переполнению аппаратных и программных очередей и сбросу пакетов, называемых в статье - Dark Packets. Обойти проблему попытались простым путем - распараллелить пакеты между ядрами процессора, но такой метод оказался немасштабируемым: для 100Gbps нужно 20 физических ядер, а для 400Gb/s уже 79.
В попытках решить проблемы был придуман и имплементирован так называемый CacheBuilder API, использующий Intel Cache Allo-cation Tool APIs и современные инструкций Intel процессоров, в следствие чего удалось в явной форме выделить под приложение часть LLC (L3 cache) и разместить в нём LPM, Hash и exact-match таблицы. В качестве примера используются процессор Xeon E5-2650v5 c 30MB LLC и DPDK приложение для L3 forwarding. Это позволило добиться 40Gb line rate без потерь пакетов размеров 192 байт уже на двух ядрах при задействовании 24MB кэша.
Аналогичный подход мы видим и в NPU современных сетевых вендоров, где есть "быстрый" on-chip SRAM и "медленный" off-chip DRAM.
Хорошо описанная проблематика, много тестов и графиков, характеризующие степени зависимости между скоростью канала, размером пакетов, количеством ядер, количеством обращений к DRAM, промахов кэша и прочим - это всё про прилагаемый PDF.
https://www.sysnet.ucsd.edu/~voelker/pubs/darkpackets-ancs18.pdf
sexst
И можно парочку десяток влегкую поиметь. Мы, в общем-то, упирались в то, что пустые pci-e слоты закончились, а имеющиеся были в полку утилизированы.
Denis
И можно парочку десяток влегкую поиметь. Мы, в общем-то, упирались в то, что пустые pci-e слоты закончились, а имеющиеся были в полку утилизированы.
пиши в ЛС если че ) есть о чем думаю перепи..ть
Volodymyr
писателей у нас тут нет
sexst
Последнее ещё: nftables попробовать. Там advanced конструкции в плане nat. Можно много записей в одно правило ебануть
Denis
ТЗ и не выполнишь тут слишком сильно пока Linux Network Stack не возьмут себя в руки, а они и не возьмут, потому что это не выгодно тот же Intel их донатит сильно, не могут они в укор себе работать
sexst
И это будет реально в один байткод собираться и в один хук в netfilter вызываться.
Denis
агааааа, они просто не развивают эту технологию по понятным причинам
sexst
Т.е. меньше шансов вымывания кеша опять же
Volodymyr
у меня так брат умер
Denis
в контрек особо забивается очередь при дудосе )
sexst
Классическая тема
Denis
но я написал лоховской скрипт на баше ))))
Denis
бгггггггг
sexst
На сеге была безумно сложная battletoads. Но фишка в том, что pal и ntsc имеют разный fps, в итоге она тупо в странах с pal была чуть быстрее нужного. И вот она, боль
sexst
Also миссия с вертолетиком в gta3 из этой же оперы
Denis
Denis
кстати на сеге бэтлтодс не особо то красотка была
Denis
вот на снеееесе
sexst
В pal я в детстве джойстик разбил)
sexst
но я написал лоховской скрипт на баше ))))
Все так делают, да. Dos тупо обрезается выше на железе.
Denis
в идеале ты понимаешь что у одного клиента в контреке не будет больше 10к записей ведь так? ну если контрек правильно настроен
Denis
а если там за овер 100к то это явно атака, еще и по кипстейстам если отсортировать
Denis
но - этот анализ грузит CPU время
sexst
в идеале ты понимаешь что у одного клиента в контреке не будет больше 10к записей ведь так? ну если контрек правильно настроен
Ну типа того, да. Мониторится рейт новых сессий на клиента и их количество. При превышении за окно времени - режем временно.
Denis
я бы с баша перепилил данную тему на GO или типа того, чтобы отслеживать всплески и относительно всплесков далее отслеживать соединения - красивая логика да?
Denis
но я гошечку не знаю к сожалению, вообще на перле тоже такое можно придумать )))
Denis
я пока в ipset говнюков складываю, и то пока без timeout
sexst
Гошечка быстрее. Правда если с ядром через netlink общаться, то получится куча дорогих в go syscall'ов
Denis
а вообще за пару месяцев я выявил что в основном приползает с нескольких пидорских подсеток ддос