 yopp


т.е. если операция в оплоге, она уже на диске
yopp
пойду узнаю больше про данные. вероятно они append only. тогда можно считать чексумму данных.
тогда для ситуации ролбека можно считать документы, а для бекапа считать чексуму, например почасовую или 15минутную
ну это всё не поймает in-flight операции. т.е. клиент отправил инсерт с w:1, монга его получила и положила в движок, дала клиенту ack. ack долетел до клиента, но монга хлопнулась до того как движок успел записать что-то на диск
монга поднялась, но так как ни в журнал, ни в хранилище ничего не записалось, она эту операцию восстановить не может
yopp
в теории, на клиенте можно мониторить clusterTime
yopp
и если внезапно у ноды clusterTime отъехал назад, то теоретически можно считать что операция на самом деле не закомитилась
yopp
но я сходу не могу сказать насколько это надёжный индикатор
 Aleksey
звучит дороже чем повышение w
yopp
да, потому что это тоже вариант state persistency :)
yopp
чтоб узнать что что-то пропало, надо записать информацию о том, что может пропасть
Aleksey
вероятно из этого sli я смогу мотивировать подъем w. типа смотрите мы теряем транзакции потому что плохой w
Aleksey
но не наоборот
Aleksey
с учетом того что само по себе это редкая операция это тот еще квест
yopp
Ну тоесть при j: 1, в принципе ack будет значить что с высокой долей вероятности «потерю» будет видно в роллбэке
yopp
насколько дорого для вашего деплоймента j: 1 эт только тебе видно
yopp
но с j: 1 там тоже есть небольшой таймфрейм когда можно потерять незаметно
Aleksey
мне тоже не видно. я только на мониторинг смотрю. базу в глаза не видел ещё
yopp
а что, часто падает и что-то теряется?
Aleksey
нет конечно
Aleksey
это мыслеупражнение и попытка уровнять разные системы между собой
yopp
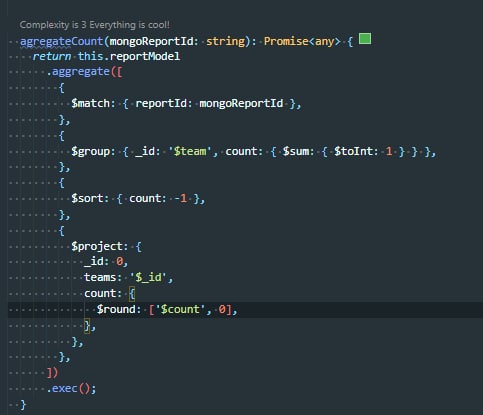
С данными sli сложно считать в реалтайме
yopp
 Aleksey
С данными sli сложно считать в реалтайме
вероятно лучше зайти со стороны чтения и понять целостность данных.
yopp
Всем привет!
Подскажите, есть ли ограничение на кол-во коллекций создаваемых на инстансе? У нас кейс предполагает создание большого кол-ва коллекций долго живущих коллекций (чтения запись 50 на 50). Но с небольшим кол-вом данных. В среднем 500-5000 записей в коллекции. Структура данных в рамках коллекции однотипная. А вот коллекций может быть 10к-100к. В перспективе на каждой коллекции будут свои индексы, по мере необходимости
Можем ли мы столкнуться с какими то лимитами при такой огранизации?
Любые идеи пожалуйста. Заранее спасибо
UPD Хоститься планируем на mongodb atlas если это имеет значение
Вероятнее всего это будет не самая оптимальная организация. 5000*100 000, это максимум 500 млн документов, что вобщем-то не так уж и страшно.
yopp
Верификация данных эт оч сложно
Aleksey
для произвольных да. для частных случаев вероятно нет. но тут уже будет вопрос не к монге а к приложению.
Aleksey
спасибо yopp. был рад поболтать.
 George
Вероятнее всего это будет не самая оптимальная организация. 5000*100 000, это максимум 500 млн документов, что вобщем-то не так уж и страшно.
Я верно вас понял вы говорите о все в одной коллекции? Не понял ваше сообжение
 Александр
Верификация данных эт оч сложно
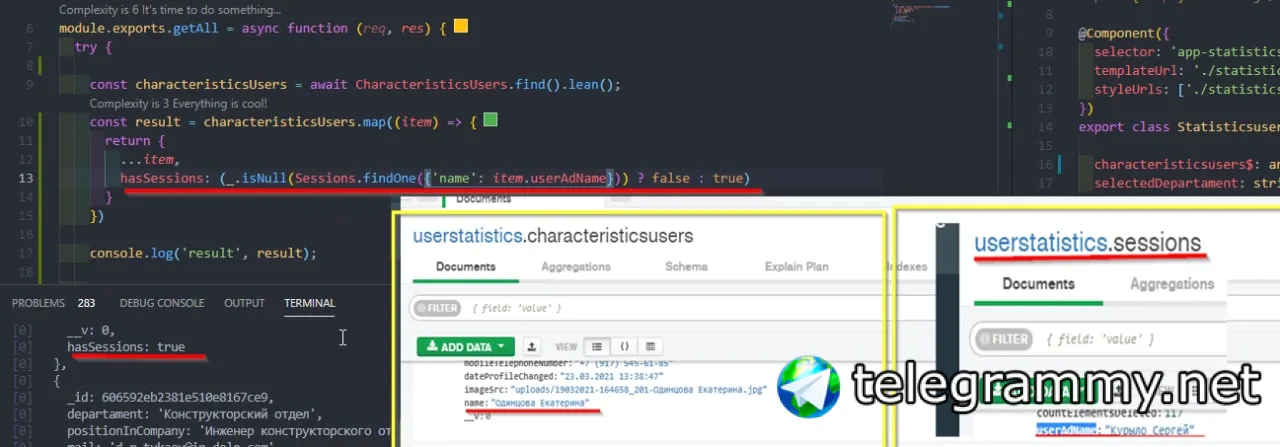
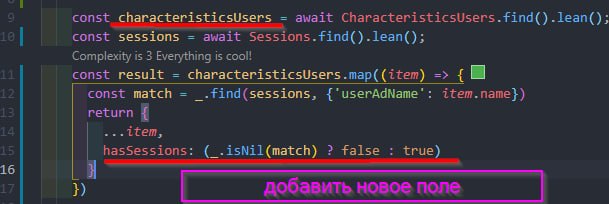
Подскажите пожалуйста...Есть две коллекции. Есть ключ (имя пользователя). В первой коллекции хочу создать поле true/false, если есть документ с таким полем во второй коллекции. Если есть объект с полем userAdName, то true. Что- то такое. Какими методами пользоваться ?
const infUser = _.find(res.informationUsers, {
userAdName: cUser.name
});
 Viktar
Хочу сделать покрывающий индекс для полей field1,field2,field3,field4
в документе около 300 полей
как должен выглядеть запрос, что бы не экстрактить весь документ а взять его из индекса?
db.collection.find({},{field1:1,field2:1,field3:1,field4:!}) ?
yopp
_id: 0 ещё
 yopp
в этом случае и его надо в индекс добавить
yopp
имеет, но вопрос про covered query. А он работает только если проекция точно совпадает с индексируемыми полями
yopp
Так как в coumpound индексе не указан _id, то без _id: 0 планировщик не сможет сделать covered query и всё равно пойдёт на диск за документом, чтоб вернуть _id
Максим
Понял. Не знаю пока об этом.
𝙊𝑙ẽ𝘨
Привет, посоветуйте пожалуйста хороший хостинг для mongodb, чтобы можно было слать по 1-3к запросов в секунду (не всегда, а пару минут например). Чтобы была возможность прям из хоста просматривать/редактировать базу. По бюджету баксов 20-30 наверное
Александр
 I
Вопрос, есть ли в mongoDb, аналог HashMap, TreeMap, т.е ключ значение который может хранить
 Mike
доброго времени суток!
как переименовать базу данных через mongorestore?
флаги nsInclude, nsFrom, nsTo протестил, не работают 😢
 ✙ Nikita
Подскажите пожалуйста, для поля в документе, типа массива строк, по которому поиск будет осуществляться через оператор $in, можно ли построить индекс и как?
yopp
Вопрос, есть ли в mongoDb, аналог HashMap, TreeMap, т.е ключ значение который может хранить
Да, он в терминах BSON называется Document
I
Да, он в терминах BSON называется Document
т.е $push: {key: "$foo", value: { $push : "$bar"}}
I
если я хочу добовлять в массив, по ключю
Rus
Делаю телеграмм бота, с использованием монго.
Надо в массив добавить новый объект. Подскажите как можно это сделать?
 Alexey
$push
 ᅠEmil 🇦🇿
Делаю телеграмм бота, с использованием монго.
Надо в массив добавить новый объект. Подскажите как можно это сделать?
Ты имеешь ввиду новый элемент в коллекцию?
 Alexandr
Господа, нужна подсказка: есть кластер из 2 нод. По нему распределена GridFS. На 1 ноде 1,8Тб данных, а на 2 только 720Гб. При этом sh.status говорит, что на 1 ноде 5014 чанков, а на 2 - 5013. Как бы поровнее распределить данные? А то 1 вчера колом встал, когда место закончилось. Надо что-то срочно решать...
 Alexander Cheprasov
Ребята, привет! Подскажите, я хочу сделать лотерейные билеты, у которых будет ID и я хочу его сделать числовым. Как при добавление новой записи (билета), сделать автоматический инкримент?
Есть как в SQL id с автоинкриментом?
использую: Mongoose
 Ilya
mongoose?
Ilya
ой, да.. не уточнил
https://www.npmjs.com/package/mongoose-auto-increment
есть такое, но чот хз
Alexander Cheprasov
https://www.npmjs.com/package/mongoose-auto-increment
есть такое, но чот хз
воу, круто! спасибо!
yopp
Господа, нужна подсказка: есть кластер из 2 нод. По нему распределена GridFS. На 1 ноде 1,8Тб данных, а на 2 только 720Гб. При этом sh.status говорит, что на 1 ноде 5014 чанков, а на 2 - 5013. Как бы поровнее распределить данные? А то 1 вчера колом встал, когда место закончилось. Надо что-то срочно решать...
Только отключив балансировщик и подвинув часть чанков на ноду где больше свободного места
yopp
ещё можно попробовать поделить чанки
yopp
тогда балансировщик сам их перенесёт
yopp
https://docs.mongodb.com/manual/reference/method/sh.splitFind/#mongodb-method-sh.splitFind
yopp
https://docs.mongodb.com/manual/reference/method/sh.moveChunk/#mongodb-method-sh.moveChunk
Alexandr
А не опасно это - руками таскать? Тем более на production?
yopp
Единственная опасность это нагрузка при балансировке потом
yopp
самый простой вариант это splitFind
yopp
ещё можно попробовать уменьшить размер чанка, раз у вас такая проблема
yopp
но для этого надо оценить медианный размер чанка на шардах, после чего уменьшить размер чуть ниже этого значения
Alexandr
Ок, спасибо, будем разбираться. Мне разработчики говорят, что чанк - это минимальная единица хранения данных в монго. И соответственно в 1 чанке лежит примерно 1 файл (фильм) в районе 1,5 гигабайт. Нужено это для того, чтобы по возможности файлы с фильмами не делились между серверами.
Alexandr
Пока никак не найду команду, чтобы проверить размер чанка...
Alexander Cheprasov
Парни, такая проблема...
У меня на серваке почему-то установилась монго версии 2.6.....
И я это понял не сразу, уже база в бою....
Как мне корректно смигрировать?
yopp
Ок, спасибо, будем разбираться. Мне разработчики говорят, что чанк - это минимальная единица хранения данных в монго. И соответственно в 1 чанке лежит примерно 1 файл (фильм) в районе 1,5 гигабайт. Нужено это для того, чтобы по возможности файлы с фильмами не делились между серверами.
Если вы используете gridfs то при загрузке файла драйвер будет резать его на фрагменты, это gridfs чанки. Размер такого фрагмента можно регулировать в драйвере, это задача приложения. По умолчанию размер фрагмента 255кБ и делать меньше его в большинстве случаев бессмысленно.
В шардированном кластере чанк имеет другое значение: это диапазон ключа шардирования, который покрывает какое-то количество документов.
Размер чанка так-же ограничен, но уже настройками сервера db.setting.find({_id: ‘chunk_size’}). При превышении размера, диапазон будет разделен на два и соотвественно чанк разделится на два новых в соотвествии с двумя новыми диапазонами. Если ключ больше не делится, то чанк будет помечен как jumbo.
Балансировщик чанков работает очень примитивно: он пытается равномерно распределить чанки по шардам, но не по размеру, а по количеству.
yopp
Размер фрагмента файла ограничен максимальным размером документа, минус дополнительные поля ~15Mb. Размер чанка ограничен 1гб
yopp
С hashed индексом фрагменты файлов в gridfs должны более-менее равномерно распределятся по кластеру
yopp
Парни, такая проблема...
У меня на серваке почему-то установилась монго версии 2.6.....
И я это понял не сразу, уже база в бою....
Как мне корректно смигрировать?
самый быстрый вариант mongodump, поставить последнюю версию, mongorestore
yopp
если у вас standalone, других вариантов в принципе нет
yopp
если у вас репликасет, то ещё возможен rolling upgrade по всем минорным версиям: 2.6 -> 3.0 -> 3.2 -> 3.4 -> 4.0 -> 4.2 -> 4.4
yopp
по одной обновляете каждую ноду до следующей минорной версии
Alexander Cheprasov
yopp
https://docs.mongodb.com/manual/replication/
Alexander Cheprasov
Буду разбираться, спасибо)
Страшно конечно, базу уничтожить....
Посмотрю как проверить что у меня репликасет, надеюсь на это и поднимусь по минорным версиям
yopp
Буду разбираться, спасибо)
Страшно конечно, базу уничтожить....
Посмотрю как проверить что у меня репликасет, надеюсь на это и поднимусь по минорным версиям
в любом случае сделайте mongodump и сложите бэкап в несколько физически разных мест
Alexandr
Если вы используете gridfs то при загрузке файла драйвер будет резать его на фрагменты, это gridfs чанки. Размер такого фрагмента можно регулировать в драйвере, это задача приложения. По умолчанию размер фрагмента 255кБ и делать меньше его в большинстве случаев бессмысленно.
В шардированном кластере чанк имеет другое значение: это диапазон ключа шардирования, который покрывает какое-то количество документов.
Размер чанка так-же ограничен, но уже настройками сервера db.setting.find({_id: ‘chunk_size’}). При превышении размера, диапазон будет разделен на два и соотвественно чанк разделится на два новых в соотвествии с двумя новыми диапазонами. Если ключ больше не делится, то чанк будет помечен как jumbo.
Балансировщик чанков работает очень примитивно: он пытается равномерно распределить чанки по шардам, но не по размеру, а по количеству.
Подключился к mongos, выполнил db.setting.find({_id: ‘chunk_size’}) - в ответ ничего. Под другим пользователем (который dbadmin) - "errmsg" : "not authorized on test to execute command { find: \"setting\", filter: { _id: \"chunk_size\" }