 Viktar


Почему будут пропускаться?
 Narek
А зачем вам на ид завязываться?
Потому-что он вроде как должен гарантировать монотонное увеличение и уникальность
Narek
Почему будут пропускаться?
Потому-что если грубо говоря у тебя подряд десять записей с updatedat=100, ты получил первый такой и сделаешь ge 100 он про пустит остальные девять
Viktar
Я не совсем понимаю вашу задачу. Вывести документы отсортированные по апдейту + пагинация?
Narek
Да, при этом чтобы если мы дошли до конца и у какого-то документа обновился updatedat - можно было следующим чтением получить его
Viktar
Потому-что если грубо говоря у тебя подряд десять записей с updatedat=100, ты получил первый такой и сделаешь ge 100 он про пустит остальные девять
Курсор выведет вам все документы, которые больше
Narek
Ну
Viktar
Если у вас 100 документов с одинаковым апдейтом, то выведется все 100
Narek
А если я хочу доставать по 5 штук?
Viktar
Так делайте скип и лимит.
Narek
Это медленно)
Viktar
Сделайте индекс на поле)
Viktar
Плюс кеш, по схеме что я описывал выше
Narek
Индекс не поможет при скипе
Narek
Скип за o(n) работает, это медленно
Viktar
Не быстро, но сразу скажу, если вы передвигается по курсору больше 5-6 страниц, и вам это реально надо, что бы это было мгновенно, то что то вы с архитектурой не то сделали.
 Vladimir
Если делать ge по updatedat будут пропускаться документы с одинаковым updatedat
ну ок, $gte + skip решит проблему неуникального updateAt
Viktar
Грузите в кеш например. Или используйте инмемори дБ.
Narek
Narek
Например в нашем случае это нужно чтобы синхронизировать записи в монге и в эластике
Vladimir
Звучит как полумера, разве нет?
ну оно работает и вполне стабильно. может конечно есть и другие способы, но для себя пока не нашел
Narek
Например в нашем случае это нужно чтобы синхронизировать записи в монге и в эластике
Грубо говоря некий update reader хранит последний курсор в бд и при старте читает данные после него и пишет в эластик, дочитывает до конца и ждет, потом когда какая-то запись обновляется ожидается что он получит ее со следующим ридом по этому же курсору
Viktar
Например в нашем случае это нужно чтобы синхронизировать записи в монге и в эластике
Такую синхронизацию я делал через апдейт сразу в два места. Но мне не надо была быстрая запись.
Narek
ну оно работает и вполне стабильно. может конечно есть и другие способы, но для себя пока не нашел
Скип грустно звучит на самом деле, скажем если будет 10к записей с одинаковым updatedat (а у нас нет гарантий что такого не может быть) будет грустненько
Narek
Такую синхронизацию я делал через апдейт сразу в два места. Но мне не надо была быстрая запись.
Типа сразу и в бд и в эластик писать?
Narek
Достаточно неконсистентно
Vladimir
Скип грустно звучит на самом деле, скажем если будет 10к записей с одинаковым updatedat (а у нас нет гарантий что такого не может быть) будет грустненько
а кто делает апдейты документов? человек\автоматика? какова вероятность, что у вас будет >100 одинаковых updateAt?
Narek
Система конечно
Narek
Вероятность ненулевая
Viktar
Почему не консистентно? Оборачиваете код в транзакцию и пишете и туда и сюда, иначе откатываете.
Vladimir
Система конечно
ну понятно ,что в базу пишет не человек. но в конечном итоге кто делает изменения в документах?
Narek
Почему не консистентно? Оборачиваете код в транзакцию и пишете и туда и сюда, иначе откатываете.
Потому-что транзакция монги не распространяется на эластик
Narek
Viktar
Транзакцию делаете в коде который пишет изменения. Не в монге.
Vladimir
Тоже система
ну ок тогда. можно тогда в updateAt вместо времени ObjectID делать :) он в себе и время содержит и монотонно возрастает
Viktar
Вернее и в монге, но это уже низкоуровневая транзакция
Narek
ну ок тогда. можно тогда в updateAt вместо времени ObjectID делать :) он в себе и время содержит и монотонно возрастает
Ну вот похоже да, единственный вариант
Narek
Я правда не очень понял, судя по документации objectid это 4 байта на время, 5 рандомных и 3 - инкрементальный каунтер
Narek
Если порядок именной такой, то из-за рандомных значений тоже может произойти «запись в прошлое»
Narek
Почему, как раз решит
Viktar
Каким образом? Тот же скип лимит придется применять
Narek
Нет, ge
Narek
Objectid гарантирует что одинаковых значений не будет
Viktar
Хорошо, у вас будет 100 документов больше, а вам надо по 5
Narek
Ну лимит сделаем
Narek
Скипа то не будет
Narek
Лимит не дорогая операция, скип дорогая
Viktar
20 курсоров будет?
Narek
С чего бы?
Viktar
Тогда как вы пейджинг сделаете по этим 100 записям?
Narek
Да в смысле? Достаешь первые 10, сохраняешь значение updatedAt последнего в курсор
Narek
Потом делаешь ge по этому курсору
Narek
И так далее
Viktar
)) это будет новый курсор
Narek
А, в этом смысле
Narek
Ну да, так работает пагинация курсорная
Viktar
Это пейжин запросом. Он будет медленнее чем скип на существующем.
Narek
Нет конечно
Viktar
Этот метод, что вы описываете это инкрементная загрузка. Она подходит для етл процессов с большим количеством записей. Обычно это называют батчами. Пейджинг это обычно для вывода используют.
Viktar
Да для большого объема данных, что бы побить на батчи этот способ лучше.
Narek
Для вывода пользователей это тоже лучше
Narek
Пагинация курсорами всегда будет аутперформить пагинацию по лимит офсет
Narek
Плюс не будет проблем с дублями
 Alexander Cheprasov
 Alexander Cheprasov
 Alexander Cheprasov
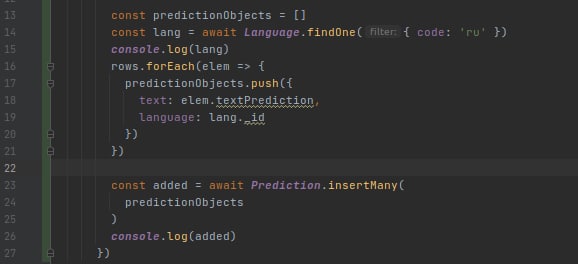
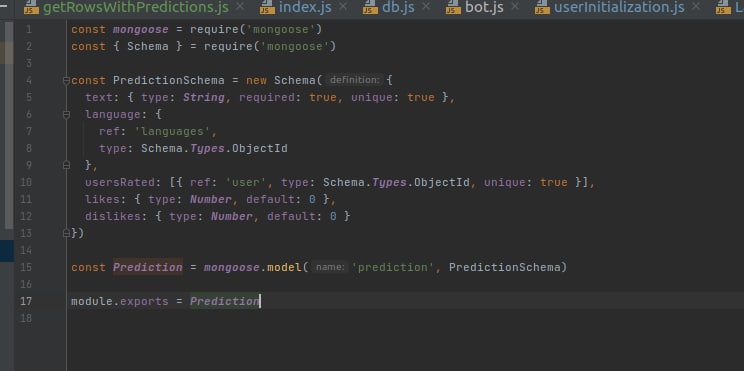
уже удалял коллекцию, потом удалял таблицу, потом удалял полностью mongo .... в чем может быть тут проблема?
Viktar
уже удалял коллекцию, потом удалял таблицу, потом удалял полностью mongo .... в чем может быть тут проблема?
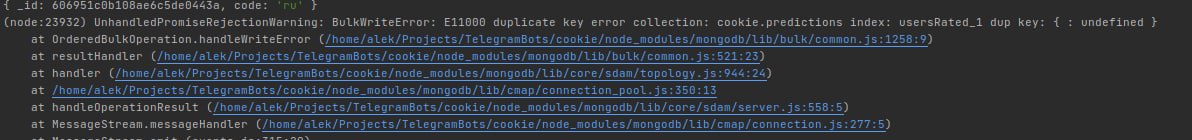
Дубликаты по уникальному полю
Alexander Cheprasov
так все уникальное((
Alexander Cheprasov
у меня в схеме только одно поле уникальное text
Alexander Cheprasov
Дубликаты по уникальному полю
как монго определяет уникальность? Может быть разным текст одинаков для монго?
Alexander Cheprasov
 Viktar
В уникальном индексе usersRated_1 дубликат
Viktar
Подозреваю он у вас по полю usersRated.
Viktar
Там стоит у вас свойство уникальности
Alexander Cheprasov
usersRated - удалил как уникальный, все равно ошибка сохраняется
Я уже пробовал в схеме оставлять только текст, все равно ошибка
Alexander Cheprasov
db.dropDatabase() после внесения правок в схему помогло
Alexander Cheprasov
Как я понял индексы живут всегда, не зависимо есть они в схеме или уже нет?