Доброе утро :)
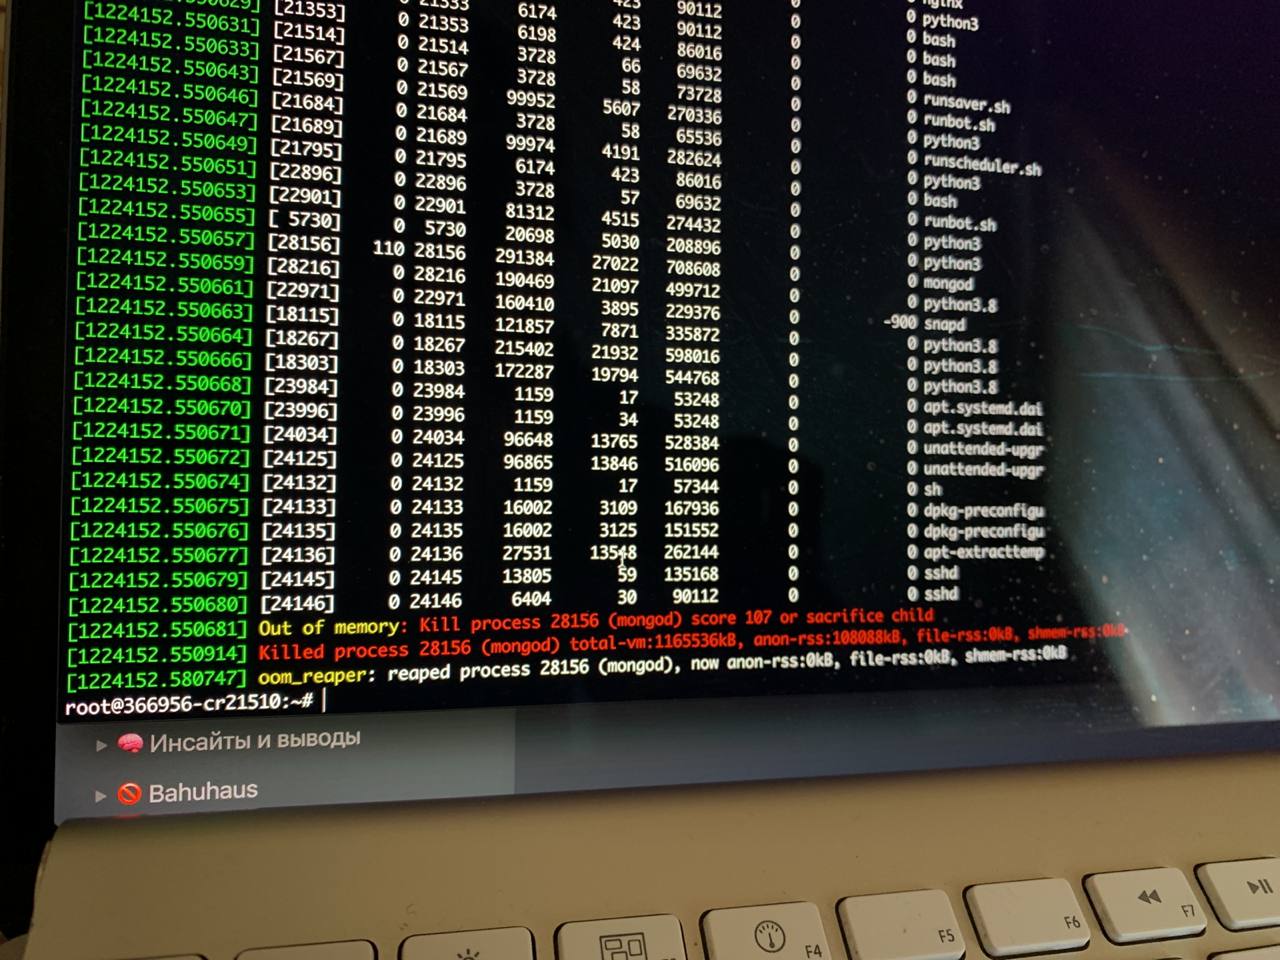
Это же OOM Kill?
https://pastebin.com/f2Et8tw8
Чтобы были запуски нужно просто добавить в .service
Restart=always
RestartSec=3
Перезапустить менеджер конфигураций через systemctl daemon-reload
а потом перезапуск демона монги systemctl restart mongodb
верно?
 Oleh Kopyl

 Oleh Kopyl
Привет!
Подскажите, почему aggregate зависает, если я запускаю mongo shell из под рута?
Пробовали на другом сервере?
Какая спека сервера? Какая ось? Какая версия монги?
У меня у самого шелл как-то коряво работает. Например когда я делаю find() то не выводит все 95к+ документов из коллекции, но если делаю этот же find() из Python, то получаю абсолютно все документы.
 Daniil
Пробовали на другом сервере?
Какая спека сервера? Какая ось? Какая версия монги?
У меня у самого шелл как-то коряво работает. Например когда я делаю find() то не выводит все 95к+ документов из коллекции, но если делаю этот же find() из Python, то получаю абсолютно все документы.
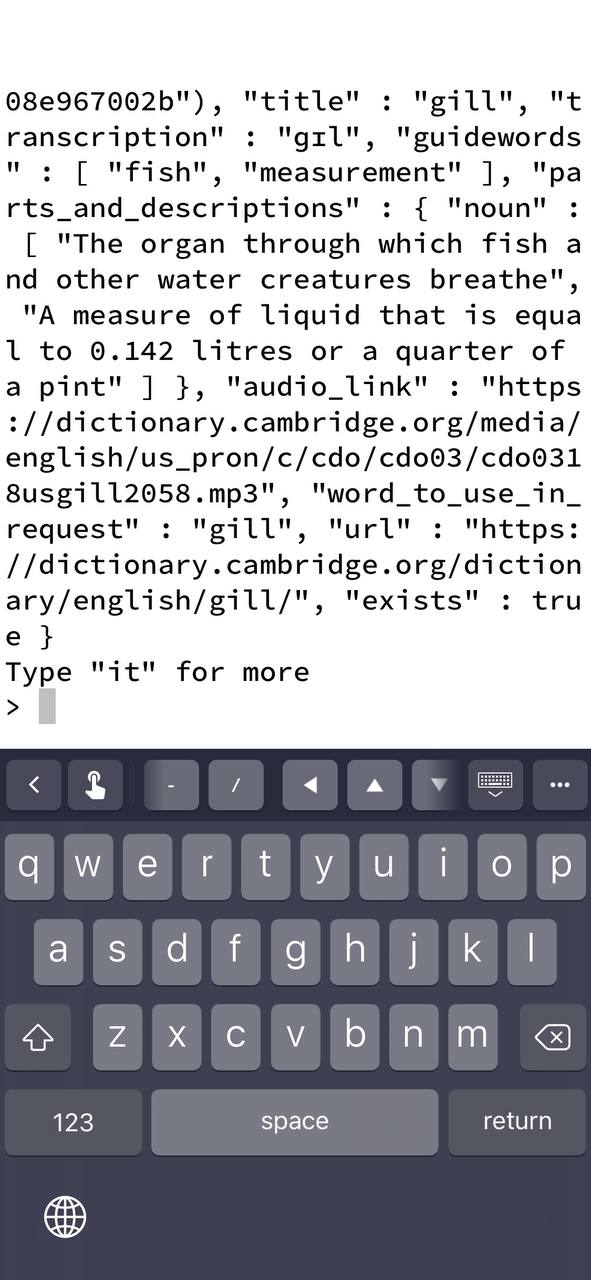
Так он и не должен выводить все доки, он выводит по 20 штук по моему
Daniil
Чтобы следующие 20 штук получить нужно ввести it
Oleh Kopyl
Так он и не должен выводить все доки, он выводит по 20 штук по моему
А почему, кстати?
Почему тогда из Python выводит абсолютно все на find()?
Oleh Kopyl
Чтобы следующие 20 штук получить нужно ввести it
 Viktar
Пробовали на другом сервере?
Какая спека сервера? Какая ось? Какая версия монги?
У меня у самого шелл как-то коряво работает. Например когда я делаю find() то не выводит все 95к+ документов из коллекции, но если делаю этот же find() из Python, то получаю абсолютно все документы.
Файнд возвращает курсор. По нему надо интегрироваться в шеле. it выводит следующие записи
Oleh Kopyl
Viktar
Да. Телефон поменял))
Oleh Kopyl
 Sergey
Добрый день. Можно ли сделать выборку из таблицы и потом эту выборку удалить? Какой командой?
Sergey
Вопрос снимается :)
Oleh Kopyl
Добрый день. Можно ли сделать выборку из таблицы и потом эту выборку удалить? Какой командой?
Выборка и так в монге не хранится
Sergey
Выборка и так в монге не хранится
это факт, мне просто нужно было удалить именно с конкретными значениями
Oleh Kopyl
это факт, мне просто нужно было удалить именно с конкретными значениями
Вот этого не знаю как.
Я бы через python итерировался по _id выборки и удалял
kk
это факт, мне просто нужно было удалить именно с конкретными значениями
db.collection.remove(<запрос>)
kk
https://docs.mongodb.com/manual/reference/method/db.collection.remove/
 I
Вопрос, а можно как то забуфирезировать данные в память. Вроде как лимит 100мб только. А можно увеличить? К примеру, по такому сценарию: прежде чем выполнить операции манга считает все таблицы в оперативку и даст еще приличный буфер в памяти
I
Для промежуточных группировок и т.д
 Oleg
Вопрос, а можно как то забуфирезировать данные в память. Вроде как лимит 100мб только. А можно увеличить? К примеру, по такому сценарию: прежде чем выполнить операции манга считает все таблицы в оперативку и даст еще приличный буфер в памяти
вроде лимит управляются параметром: https://docs.mongodb.com/manual/reference/configuration-options/#storage.wiredTiger.engineConfig.cacheSizeGB
I
I
А есть еще рецепты по ускорению?
 D.
https://docs.mongodb.com/manual/reference/method/cursor.allowDiskUse/
I
Может многопоточка там и т.д
 Lev
Как спровоцировать ошибку при upsert?
Dima
привет
подскажите как mongo сделать аналог read for update lock ?
чот не могу найти ничего внятного, кроме атомарных операций
спасибо
 yopp
yopp
yopp
Вопрос, а можно как то забуфирезировать данные в память. Вроде как лимит 100мб только. А можно увеличить? К примеру, по такому сценарию: прежде чем выполнить операции манга считает все таблицы в оперативку и даст еще приличный буфер в памяти
А что вы имеете ввиду? Размеры внутренних буферов для сортировок, агрегаций и других операций жестко ограничены на каждый запрос и не меняются
I
Ну в общем, я просто пытаюсь помочь, может не могу передать всю суть проблемы. Просто очень долго делается запрос. Более минуты
I
Очень много данных
I
Вот и думаю может у них трабла с кешем
yopp
Подскажите, пожалуйста, как лучше в бд магазина реализовать систему скидок, если скидка может быть:
по карте
по купону
просто скидка на некоторые товары
в зависимости от частоты совершенных покупок
Вероятнее всего сделать отдельную коллекцию в которой хранить типы фиксированных скидок, с коэффициентами и максимальными размерами, а для заказа сделать возможность для каждой позиции ч заказе или применить фиксированную из отдельно коллекции или ручную
I
Знаю что упор на группировку из нескольких таблиц
yopp
Ну в общем, я просто пытаюсь помочь, может не могу передать всю суть проблемы. Просто очень долго делается запрос. Более минуты
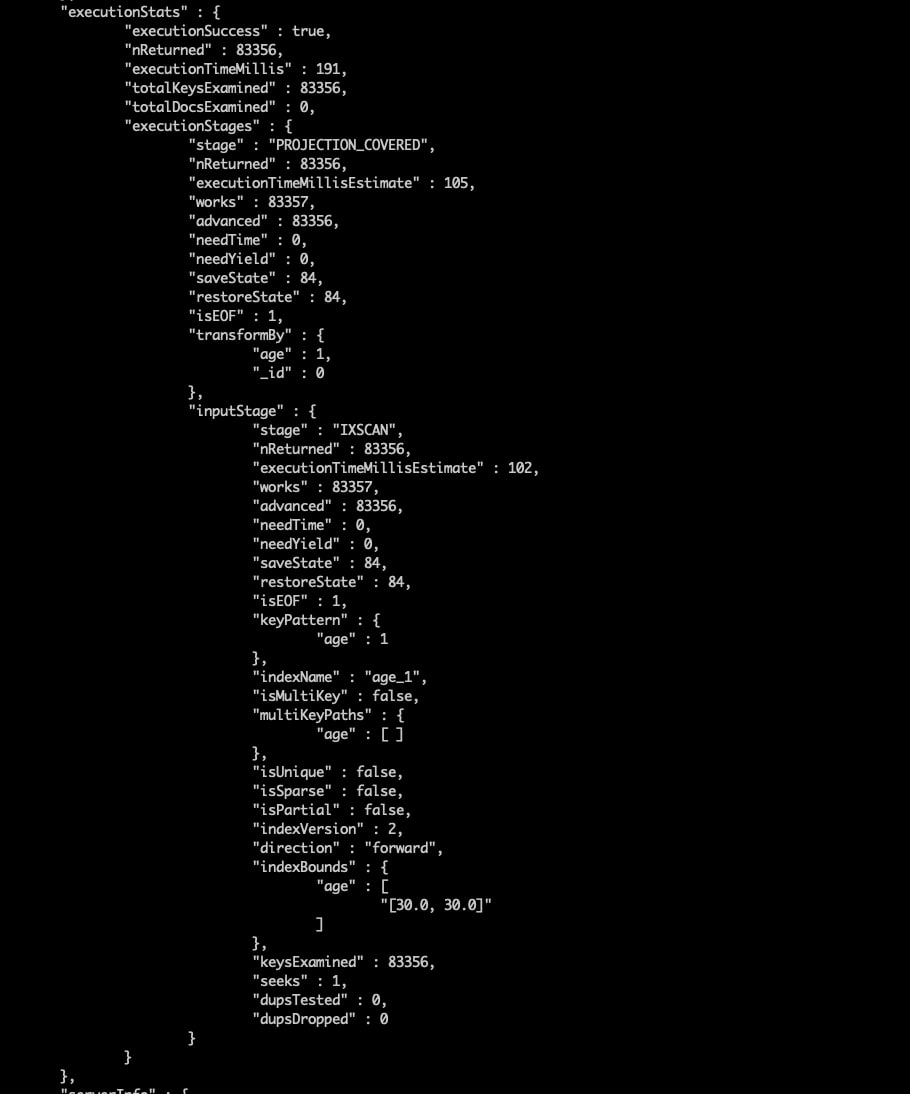
Практически гарантированно дело не в буферах. В первую очередь стоит посмотреть на explain({"executionStats":1}) и определить где сейчас бутылочное горлышко
I
Данных, где то три таблицы и в каждой приблизительно 10000 тыс документов
yopp
Вероятнее всего проблема решиться созданием поддерживающих запросы индексов
yopp
Данных, где то три таблицы и в каждой приблизительно 10000 тыс документов
10000 тыс это 10 млн или 10 тыс?
I
Кажется 10000 но, при группировки видимо создаются различные варианты и происходит перемножение
I
Тыс
yopp
10 тысяч документов это небольшие объемы. Вероятнее всего хватит создать индексов по медленным запросам
I
Вероятнее всего проблема решиться созданием поддерживающих запросы индексов
А где можно почитать ?
I
По индексам и т.д, т.е что бы ускорить всю эту громадину
yopp
https://docs.mongodb.com/manual/tutorial/optimize-query-performance-with-indexes-and-projections/
I
yopp
Да... хз... какого нибудь, Разного. Протестить как код реагирует на это
С несколько десятков потоков пытаться создать один и тот-же документ. И то, начиная с 4.2 не прокатит. Ещё можно попробовать через currentOp поймать и отстрелить запрос
yopp
Ну или ноду уронить
I
@dd_bb еще вопрос, сильно ли влияет на скорость если у документа много данных?
I
Но от документа требуется только id например, при групировки
yopp
Зависит от того, сколько «много» :)
yopp
Но да, чем больше размер документа, тем больше надо читать данных с диска, тем дольше будет выполнятся запрос
I
Но да, чем больше размер документа, тем больше надо читать данных с диска, тем дольше будет выполнятся запрос
Ну да, именно в этом ключе хотел понять :)
I
А то где то читал что мол, не важно сколько в документе данных если мы от него требуем только индексовый ключ,
yopp
Не совсем так
yopp
Индекс позволяет только найти документ. Но если требуется получить данные из найденного документа, то их скорее всего нет в индексе и необходимо прочитать документ. А для этого нужно его загрузить :)
yopp
И это можно сделать только целиком
I
Да, логично
yopp
Единственное исключение это covered queries: когда проекция и условия запроса полностью покрываются одним индексом
I
Т.е получается, мы находим документ по индексу, индекс как указатель дает нам доступ к документу, и если у документа много данных, хоть нам и нужно будет от него только два поля, но те данные которые в нем есть, будут тормозить процесс чтения. Верно?
yopp
Да, примерно так
I
Спасибо
I
А намного эластик круче монги, когда речь заходит о агригации , групировки
I
?
 Zaur
 yopp
А намного эластик круче монги, когда речь заходит о агригации , групировки
На этот вопрос невозможно ответить не сравнив эти два хранилища на реальных данных и с реальными запросами
yopp
Если вы хотите на время чтения и обновления заблокировать другие операции с документом, то это невозможно. В монге в принципе нет user defined locks. Проще говоря только сама монга может блокировать данные.
Но за счёт того, что транзакции изолированны и не видимы для других клиентов до коммита, вы можете обернуть все операции в транзакцию и получить почти такой-же эффект.
Разница только в том, что клиенты смогут читать документ до завершения транзакции, но увидят новую версию сразу после её применения и достижения требуемого уровня гарантии доступности.
Из минусов — при параллельном обновлении одного документа будут возникать конфликты, которые вашему приложению придётся разрешать самостоятельно
Dmitriy
Коллеги, подскажите пожалуйста по агрегациям.
У меня есть документы такого вида (products)
_id: string;
user: string;
currency: 'UAH' | 'RUB' | 'USD'
income: number;
Мне нужно по итогу сделать так
user: 10,
info:
{
UAH: (Сумма income у которых currency UAH),
RUB: (Сумма income у которых currency RUB),
USD: (Сумма income у которых currency USD),
}
Просто подскажите каким методом лучше всего пользоваться? Я пока вижу только вариант в group info делать акумулятор, но может кто подскажет другой какой то выход?
yopp
Коллеги, подскажите пожалуйста по агрегациям.
У меня есть документы такого вида (products)
_id: string;
user: string;
currency: 'UAH' | 'RUB' | 'USD'
income: number;
Мне нужно по итогу сделать так
user: 10,
info:
{
UAH: (Сумма income у которых currency UAH),
RUB: (Сумма income у которых currency RUB),
USD: (Сумма income у которых currency USD),
}
Просто подскажите каким методом лучше всего пользоваться? Я пока вижу только вариант в group info делать акумулятор, но может кто подскажет другой какой то выход?
На мой взгляд наиболее простой вариант это сделать в два три шага:
$group: _id: { user, currency }, income: $sum {income}
$group: _id: { user }, info: $push [_id.currency, income]
$addFields: info: $arrayToObject info
Dmitriy
хм, спасибо за подсказки
yopp
А user: 10 это количество пользователей?