 yopp


Не подстроки, суффиксы или префиксы, не по семантическому расстоянию и даже не разным языкам одновременно
 Dmitry
Тогда мы сделали все правильно, что навесили полнотекстовый индекс на поле с доменами, только надо было заменить симолы точки на что-то другое, верно? То есть мы ищем подстроку (простое доменное имя) в строке (сложное доменное имя).
yopp
Возможно можно утверждать что если у вас много текстовых сообщений и вы хотите искать среди них подстроки, то используйте elasticsearch но не mongo?
Если говорить об этом примере и задачи поиска сегмента в URL который начинает с google, то нет
yopp
yopp
Так как словом является googlecontent, а текстовый индекс не поддерживает частичных совпадений
Dmitry
Я имел ввиду этот пример
Тогда что можете предложить для решения задачи в данном примере в рамках mongo?
yopp
Сделать ещё одно поле, в которое складывать сегменты массивом
yopp
По этому полю сделать индекс и уже по нему искать префиксом
Andrey
Тогда что можете предложить для решения задачи в данном примере в рамках mongo?
посмотрите неправильный(но есть +) пример...https://github.com/Cgboal/SonarSearch
Andrey
там почти также как предлагает yopp
Dmitry
То есть токенизировать url, и в новое поле складывать массив токенов?
yopp
Плюс если это свести к Attributre-Value паттерну, то можно ещё сделать поле в которое можно складывать разные данные и делать обобщённый поиск
Dmitry
Итак: 0.145.227.35.bc.googleusercontent.com -> [0, 145, 227, 35, bc, googleusercontent, com] - как из этого массива я могу найти google?
yopp
{v: 128, a: 'ipv4'}, {v: 'google', a: 'dns.a' } ...
yopp
yopp
Монга автоматически построит multikey индекс
yopp
{v: 128, a: 'ipv4'}, {v: 'google', a: 'dns.a' } ...
И тут compound index {v, a}
Dmitry
{v: 128, a: 'ipv4'}, {v: 'google', a: 'dns.a' } ...
Эту магию я не понял, как 0.145.227.35.bc.googleusercontent.com превратилось в {v: 128, a: 'ipv4'}, {v: 'google', a: 'dns.a' }
yopp
Dmitry
Ясно, то есть это документы одной коллекции
yopp
Я так понимаю что вы пытаетесь сделать поиск по dns зонам. В данном случае вы можете делать в одном документе токенизацию по всем типам записей
Dmitry
Итак, в mongo нет инстумента поиска подстроки в строке на примере: поиск google в строке googleusercontent ?
Dmitry
Я так понимаю что вы пытаетесь сделать поиск по dns зонам. В данном случае вы можете делать в одном документе токенизацию по всем типам записей
Верно, в mongo мы храним: {"timestamp":"1608996183","name":"0.145.227.35.bc.googleusercontent.com","type":"a","value":"35.227.145.0"} - такие записи
 Алексей
А в stats, в wiredTiger.block manager какие значения?
"block-manager" : {
"allocations requiring file extension" : 310527,
"blocks allocated" : 594913,
"blocks freed" : 286190,
"checkpoint size" : 343856025600.0,
"file allocation unit size" : 4096,
"file bytes available for reuse" : 44572495872.0,
"file magic number" : 120897,
"file major version number" : 1,
"file size in bytes" : 388428673024.0,
"minor version number" : 0
}
Алексей
Вы вызываете compact на коллекции с чанками ?
да. db.runCommand({compact: "fs.chunks"})
yopp
да. db.runCommand({compact: "fs.chunks"})
Да, у вас "file bytes available for reuse" : 44 572 495 872.0
Compact к сожалению не гарантирует что он отдаст пространство назад файловой системе
yopp
Но если вы собираетесь в gridfs снова что-то записать, то эти 43гб будут использованы
Алексей
Ну да. Это я понимаю. Просто тут пишут что мол используйте compact чтобы место освободить. Хотя в другом месте документации написано что не во всех случаях диск освобождается. Ладно спасибо за ответ.
https://docs.mongodb.com/manual/faq/storage/#how-do-i-reclaim-disk-space-in-wiredtiger
yopp
Верно, в mongo мы храним: {"timestamp":"1608996183","name":"0.145.227.35.bc.googleusercontent.com","type":"a","value":"35.227.145.0"} - такие записи
Вы их можете проиндексировать с собственной токенизацией по предложенной выше схеме. Например используя { a: <type + column (ex a.ttl’, `a.data, a.name`>), v: <value> (ex: `128, googlestorage …) }
yopp
В этом случае вы сможете делать запросы вида {'idx.a': 'a.ttl', 'idx.v': {$gt: 3200} } или сложные,
в духе $and: [{'idx.a': 'a.ttl', 'idx.v': {$gt: 3200} }, {'idx.a': 'a.name', 'idx.v': /\Agoogle/}]
yopp
ну или можно поменять column и record type местами, тогда вообще можно будет искать без учёта типа записи {'idx.a': /\Aname/, 'idx.v': /\Agoogle/}
yopp
Ну да. Это я понимаю. Просто тут пишут что мол используйте compact чтобы место освободить. Хотя в другом месте документации написано что не во всех случаях диск освобождается. Ладно спасибо за ответ.
https://docs.mongodb.com/manual/faq/storage/#how-do-i-reclaim-disk-space-in-wiredtiger
Увы, да. Отдать свободное место назад файловой системе не самая тривиальная задача и wt в этом плане очень консервативен
yopp
если у вас есть 400 гигабайт свободного места и достаточно времени, вы можете сделать копию коллекции
yopp
если у вас репликасет, то сделать rolling inital sync
yopp
так как коллекции будут созданы по новой, это место высвободится
Алексей
если у вас есть 400 гигабайт свободного места и достаточно времени, вы можете сделать копию коллекции
Да нет. Скоро на s3 перейдём. GridFS сейчас используется как временный вариант.
yopp
Кстати, всегда интересно почему s3?
yopp
Есть же более оптимальные по цене альтернативы: wasabi ($7/tb/m, free bw) или backblaze
Алексей
Я имел в виду s3 совместимое api. А не сам сервис Amazon. У нас развернут свой кластер Ceph. Он поддерживает S3 API.
 Alexander
Кстати, всегда интересно почему s3?
Стабильность, проверенная годами. На моей памяти только один раз лежал.
Dmitry
nefertisu
Вопрос, а как можно убрать нижнее подчёркивание перед айди что бы было не _id, а id , потому что когда я вручную (nodejs + mongoose) указываю id: {type:Types.ObjectId} мне всё равно в результате выходит с нижним подчёркиванием
yopp
Вопрос, а как можно убрать нижнее подчёркивание перед айди что бы было не _id, а id , потому что когда я вручную (nodejs + mongoose) указываю id: {type:Types.ObjectId} мне всё равно в результате выходит с нижним подчёркиванием
К сожалению, никак. _id обязательное уникальное поле, без которого невозможно создать документ
yopp
В монгусе вероятно есть возможность сделать алиас
nefertisu
К сожалению, никак. _id обязательное уникальное поле, без которого невозможно создать документ
то есть мне всегда придётся оперировать с _?
yopp
Да, это аналог primary key в табличных хранилищах
Roman
Всем привет. Подскажите а есть какой то оптимальный метод по наполнению данными МонгоДБ?
nefertisu
А как в mongoose сделать массив вложенных схем. Например я хочу сделать что в какой-то сущости хранится массив объектов с определённой схемой, условно Project, когда я делаю projects : [Project] мне бьёт эррор, хотя в оф доке делают именно так
nefertisu
yopp
А как в mongoose сделать массив вложенных схем. Например я хочу сделать что в какой-то сущости хранится массив объектов с определённой схемой, условно Project, когда я делаю projects : [Project] мне бьёт эррор, хотя в оф доке делают именно так
Если я правильно помню, в монгусе это Nested Schemas. ЕслиProject это схема, то используя нотацию [Project] в виде значения атрибута родительской схемы, можно создавать вложенные документы.
А какая ошибка?
nefertisu
 nefertisu
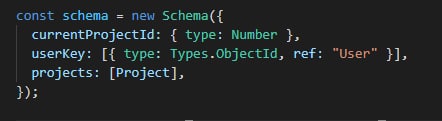 nefertisu
Project соответственно это схема
yopp
А что в ошибке?
nefertisu
nefertisu
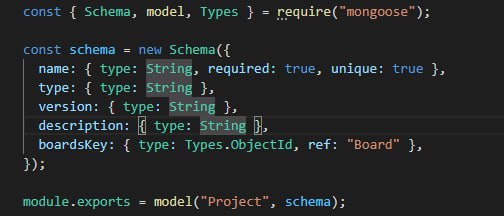 nefertisu
импорчу просто через рекваер
 Вадим
Привет. Подскажите, пожалуйста, такой момент.
Есть магазин, в котором есть базовая схема Product, содержащая общие для всех типов товаров поля, как то: название, цена и тд.
Есть типы товаров, обладающих разными характеристиками.
Получается, нужно описывать отдельную дочернюю схему для каждого типа товаров.
И при crud-операциях с товарами мне придется обращаться к конкретным дочерним моделям? Или это можно как-то реализовать, оперируя только родительской схемой Product?
Daniil
импорчу просто через рекваер
вы импортируете модель, а не схему, собственно в тексте ошибки об этом и говорится
nefertisu
вы импортируете модель, а не схему, собственно в тексте ошибки об этом и говорится
Тогда мне отдельно из файла модели экспортировать схему и объявить её внутри?
Daniil
Тогда мне отдельно из файла модели экспортировать схему и объявить её внутри?
по идее у модели есть свойство .schema
Daniil
попробуйте указать [Project.schema]
nefertisu
да, попробовал
nefertisu
сработало
nefertisu
спасибо!)
yopp
Привет. Подскажите, пожалуйста, такой момент.
Есть магазин, в котором есть базовая схема Product, содержащая общие для всех типов товаров поля, как то: название, цена и тд.
Есть типы товаров, обладающих разными характеристиками.
Получается, нужно описывать отдельную дочернюю схему для каждого типа товаров.
И при crud-операциях с товарами мне придется обращаться к конкретным дочерним моделям? Или это можно как-то реализовать, оперируя только родительской схемой Product?
Самый простой вариант это реализовать Attribute-Value паттерн.
Создаёте коллекцию описывающую необходимые вам атрибуты. В документ с продуктом добавляете массив поддокументов формата
[{a: attr_objectid, v: <значение атрибута>} ....]
 Josh
yopp
В монгусе это будет attrs: [AttributeValue];
Atttribute {name: ..., type: ..., .... }
AttributeValue: {a: refs Attribute, v: ...}
Product: attrs: [AttributeValue]
Josh
для ddd, чтобы не тянуть всю дату на клиент на каждый чих в половине случаев
Вадим
yopp
Паттерны в отрыве от проблемы невозможно рассматривать. Сходу тут одна проблема превращается в три: храним события, вычисляем из событий конечное состояние, храним слепок состояния.
Josh
Паттерны в отрыве от проблемы невозможно рассматривать. Сходу тут одна проблема превращается в три: храним события, вычисляем из событий конечное состояние, храним слепок состояния.
ну проблемы поддержки рано или поздно приходят без доменной логики, потом переписать на нее будет еще дороже
Josh
а любая доменная в итоге влечет к какому-нибудь схожему подходу
Josh
https://www.youtube.com/watch?v=rolfJR9ERxo что-то из посвежее сходу не нахожу
yopp
Вы никогда не угадает какие у вас проблемы будут потом :)