Кто-нибудь может подсказать, возможно ли написать запрос по значению поля объекта в мапе?
{
"a" : {
"1" : {
"b" : 111
},
"2" : {
"b" : 112
},
"3" : {
"b" : 113
}
}
}
Найти все документы, у которых в поле "a" среди значений поля "b" есть значение 112?
$elemMatch не работает, так как тут не List<Object>, а Map<String,Object>
Пробовал всякого рода find({"a.*.b":112}), но не работает
Нашел решение через aggregate. Работает.
 Antonio


 Valentin
Здравствуйте. Подключил БД (Mongo DB Atlas) к проекту (тг бот). Когда запускаю сервер со своего ноута всё работает хорошо, но при запуске проекта через Heroku бот не отправляет сообщения, в которых берутся или отправляются данные в базу. На Mongo Atlas я разрешил вход всем всем IP адресам
неоднозначно, но .env файл есть по типу process.env.(VARIABLE)?
Valentin
а ну и там еще нужно переменные в хероку забиндить
 ᅠEmil 🇦🇿
неоднозначно, но .env файл есть по типу process.env.(VARIABLE)?
env нету, только js, json, .gitignore и Procfile
Valentin
env нету, только js, json, .gitignore и Procfile
попробуй добавить env в бэкенд и в heroku переменную эту
https://developer.mongodb.com/how-to/use-atlas-on-heroku/
ᅠEmil 🇦🇿
Почитаю, спасибо
Maksym
Доброго. Нужно экспертное мнение/совет. Создаю систему на php фреймверке с использование 2х DB. Первая БД PostgreSQL а вторая mongoDB. Монго будет использоваться для "мусорных" данных. Назначения данных - большое количество однотипных данных по типу ip адресов с доменными именами + разные другие поля в зависимости от предпочтений пользователя которые будут именоваться как Листы. Есть несколько идей по этой реализации:
1) Для каждого пользователя создавать свою базу в монго именуя ее как id пользователя. Для каждого "Листа" - будет создаваться отдельная таблица(коллекция).
2) Для всех пользователей будет создана одна база но для каждого по отдельности будет создана коллекция по id пользователя в которую будут записываться "листы" вперемешку с разными идентификаторами.
3) Для всех пользователей будет создана одна база и одна коллекция куда будут записываться "Листы" с разными идентификаторами и полями - при этом дополнительные поля будут вписываться в отдельное поле как json.
Какой из выше перечисленных вариантов предпочтительней, какие есть +/- ?
Нужно учитывать что каждый пользователь может загрузить от 1 000 до 20 000 записей. Система рассчитана на аудиторию от 100 до 2000 человек.
Я склоняюсь ко 1 и 2 варианту но меня уверяют что 3 вариант оптимальный и на скорость работы системы не повлияет
Viktar
Первый вариант по стоимости владения будет самым дорогим. Второй тоже дорогой. Стандартная практика, не плодить много баз.
Я не сильно понимаю вашу задачу и данные с которыми вы работаете, поэтому совет дать не смогу.
Maksym
 Lev
Я ведь правильно понимаю, что предопределенные идшники, определяемые приложением - это нормальная распространенная практика для монги?
 Nick
Я ведь правильно понимаю, что предопределенные идшники, определяемые приложением - это нормальная распространенная практика для монги?
это зависит только от вашего приклада, все бд позволяют явно указывать id
Maksym
Самый простой это вариант 3. Для динамических атрибутов наиболее эффективно использовать Value-Attribute паттерн
https://t.me/mongodb_ru/87488
Спасибо за ответ. Погуглю по поводу паттерна
Lev
А монге внутри вообще очень важно, прилетел ли id от клиента или нет?
 yopp
А монге внутри вообще очень важно, прилетел ли id от клиента или нет?
А зачем вам назначать id самостоятельно?
Lev
А зачем вам назначать id самостоятельно?
Чтобы не обращаться к базе за идшником. И иметь возможность оперировать идшниками, проставлять их в соседние сущности.
Lev
Ну и был расчет на мастер-мастер базу, но пока еще не внедрили.
yopp
Вы хотите OID на клиенте генерировать?
yopp
В монге нет primary-primary репликации
Lev
Я нашел, что один из явовских клиентов при попытке записи сразу нескольких сущностей проверяет, являются ли они все новыми. Если они все новые (ид нет), тогда batch. Иначе - по одной. А мне иногда писать тысячи сущностей
Nick
Lev
Вы хотите OID на клиенте генерировать?
Имеется ввиду на сервере. Людям в браузер я такое не доверю, конечно же.
Lev
В монге нет primary-primary репликации
Да, я знаю. Я планировал потом заменить базу, но пока есть технические нюансы.
yopp
Если вы не передаёте _id в создаваемом документе, он автоматически назначается сервером. Если вы передаёте, то используется тот, который передали.
yopp
Вы можете в документ подставлять сгенерированный на вашим приложением oid
Nick
Ну... мне вот уже писать много сущностей.
т.е. вы уже явно выявили что есть проблема именно в этом месте и она действительно критичная, тогда наверное не преждевременная
yopp
Шансы коллизий минимальные, разница нет
Lev
Про ид я спросил, потому что клиент не умеет делать updateBatch. Что меня ну очень удивило.
И я подумал, а может это я дурак, и не принято проставлять id заранее. Хотя вроде бы помню, что это нормальная практика.
Nick
Про ид я спросил, потому что клиент не умеет делать updateBatch. Что меня ну очень удивило.
И я подумал, а может это я дурак, и не принято проставлять id заранее. Хотя вроде бы помню, что это нормальная практика.
вопрос сбоку, зачем вам батчи? есть проблемы с передачей по сети или нет возможности использовать асинхрон?
Lev
вопрос сбоку, зачем вам батчи? есть проблемы с передачей по сети или нет возможности использовать асинхрон?
1000 последовательных запросов?
Иногда мне надо сохранить тысячи данных.
Nick
если они последовательны, то это не батч
Lev
Ну... паралелльно я не могу - заканчиваются коннекшены
Lev
Я бы рад батчем, но внезапно довольно распространенный клиент явы, поставляемый с фреймворком это не умеет
Viktar
Батчи обычно используется для етл.
Lev
Что такое etl?
Nick
вот мы и пришли к тому, что надо разбираться как готовить асинхронный джава драйвер монги
Nick
Что такое etl?
extract-transform-load - всякие инструменты, позволяющие описать конвеер обработки данных как правило из различных источников данных для преобразования, обогащения и загрузки куда еще
Lev
extract-transform-load - всякие инструменты, позволяющие описать конвеер обработки данных как правило из различных источников данных для преобразования, обогащения и загрузки куда еще
Нет, мне нужно просто обновить кучу сущностей, это не etl.
 Константин
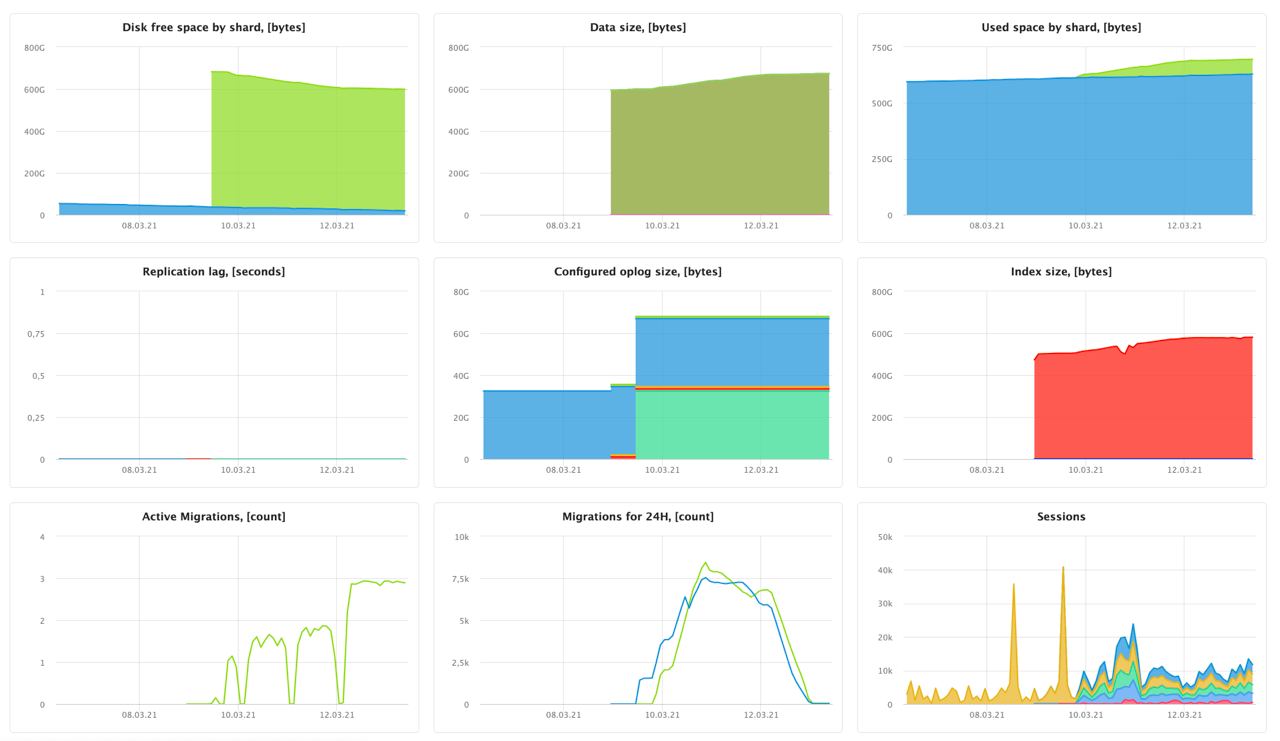
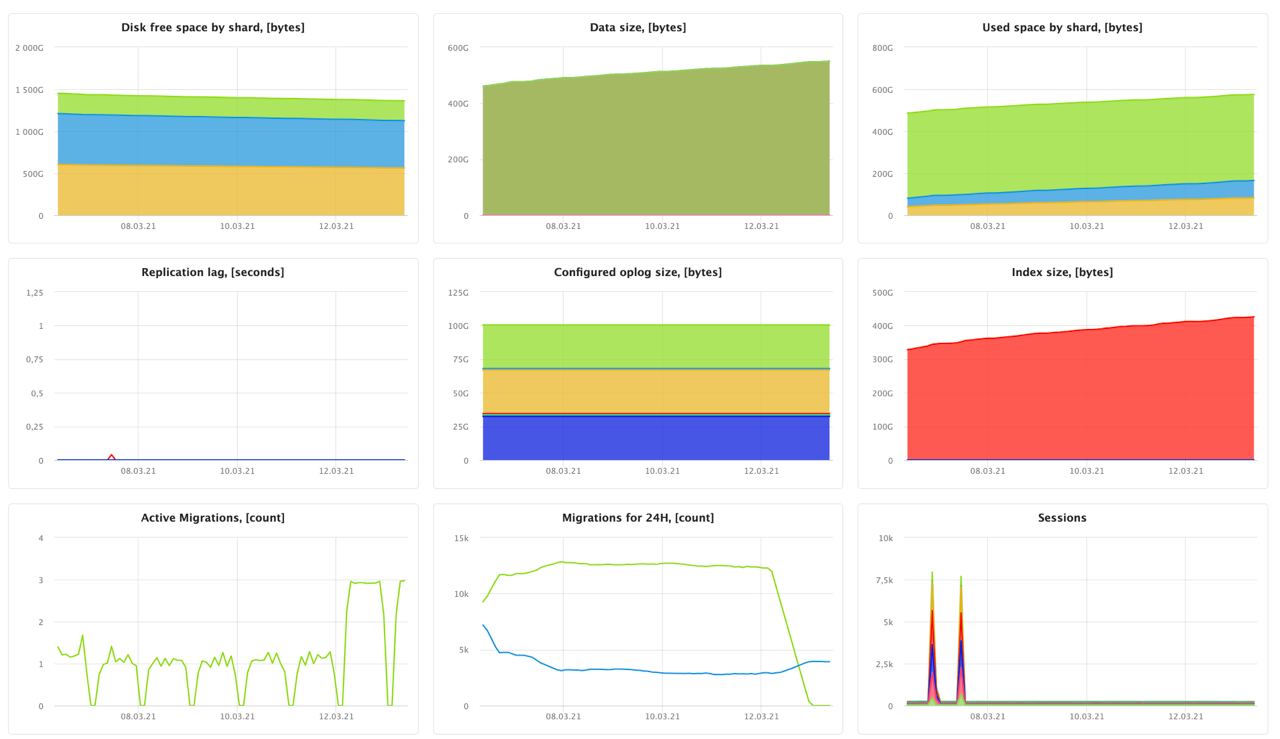
Парни, всем привет. Кто работал с яндекс.облаком и их менеджмент монгой? Мы сейчас настроили шардирование и оно у них работает никак. Сама поддержка и архитекторы не понимаю что происходит и не могут ничего пояснить.
Константин
 Константин
Он в какой-то момент просто перестал балансировать
Константин
У нас есть ещё собранный стенд с бэкапом данных, на котором нет нагрузки вообще, там тоже странно всё.
Константин
 Константин
он не переносит чанки, а копирует на другие шарды
yopp
А что в sh.status()? Судя по этим графикам есть активные миграции
Максим
А монге внутри вообще очень важно, прилетел ли id от клиента или нет?
Можно же добавить свой id и не трогать монговский _id.
Lev
Можно же добавить свой id и не трогать монговский _id.
Два id? Так или иначе, я описал подробности ниже сообщения, на которое вы ответили. Явовский реактивный клиент не умеет bulk update
Константин
А что в sh.status()? Судя по этим графикам есть активные миграции
есть, но их 20 за сутки
yopp
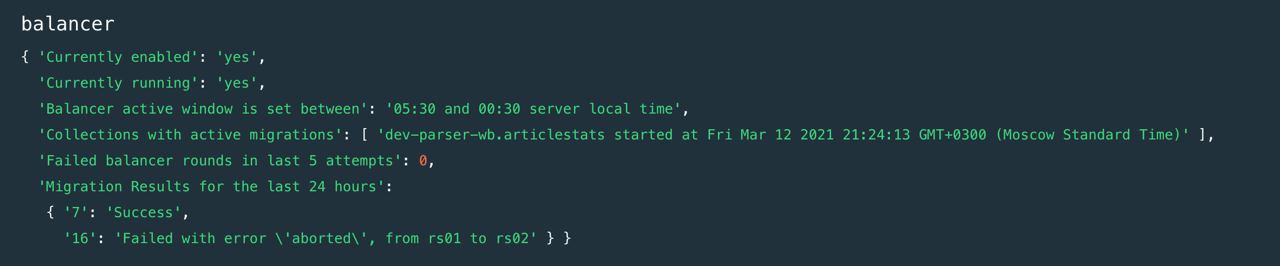
Смотрите в sh.status и логи нод доноров и реципиентов
yopp
Если в статусе есть failed миграции, причину можно попробовать найти в логах
Константин
Если в статусе есть failed миграции, причину можно попробовать найти в логах
причина просто aborted
yopp
 yopp
Каждая стадия миграции отражается в логе, там должно быть больше подробностей на каком этапе и по какой причине это произошло
Константин
Похоже что таймаут
yopp

 Google
 Google
 Google
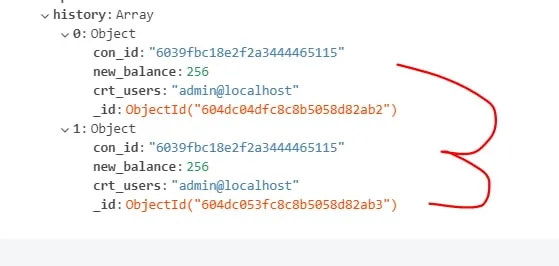
есть кто опытный по по Mongodb ? можете помочь
Google
yopp
 Google
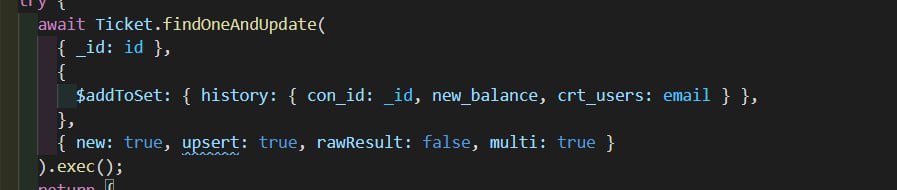
тоже не помогает
yopp
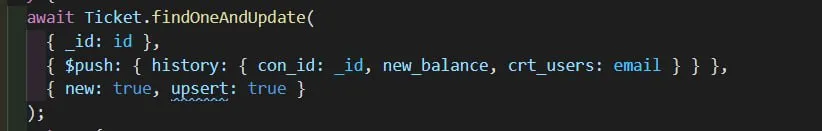
а, у вас там ещё откуда-то history._id возникает
yopp
либо вам необходимо отказаться от _id, либо использовать https://docs.mongodb.com/manual/tutorial/update-documents-with-aggregation-pipeline/ и вручную проверять есть ли такой элемент в массиве и добавлять по необходимости
yopp
тогда всё верно, они у вас отличаются
yopp
у первого заканчивается на 2, у второго на 3
Google
как сделать чтобы не было дубликат
yopp
У вас нет дубликата
yopp
У вас два разных элемента массива
yopp
_id это тоже данные
yopp
либо найдите откуда возникает _id, если он вам не нужен
yopp
либо вручную через update pipeline
Google
но тогда как могу выташить последний запись из history ,? скажем через ид
yopp
у элементов массива есть индекс