Всем привет.
Нужна помощь.
есть елемент
{ field1:value,
field2:value
feeld3: [{ subField: value,
subField2:[ value1, value2,...valueN]
}
надо вывести field1, field2, а с field3 объект содержащий максимальное значение в массиве subField2. Максимум среди всех объектов в поле field3. Если таких объектов несколько, то любой
Можно восользоваться $map, $size, $arrayToObject, $max. https://docs.mongodb.com/manual/reference/operator/aggregation/size/ https://docs.mongodb.com/manual/reference/operator/aggregation/max/ https://docs.mongodb.com/manual/reference/operator/aggregation/arrayToObject/ https://docs.mongodb.com/manual/reference/operator/aggregation/map/
через $map и $size прогоняем feeld3 и создаем массив массивов. Где первый элемент это исходный массив, а второй элемент его размер. Потом создаем из него объект через $arrayToObject где ключом будет размер массива, а значением массив.
+ также создаем еще одно поле, где будет массив размеров массивов. В этом массиве берем $max и подставляем его значение в получившийся объект раннее.
Громоздко но сработать должно
 Dmitry


 Viktar
Звучит архи сложно)) проще наверное вынести эту логику из монги.
 yopp
Сохраняете в аккумулятор самое большое из найденых значений
yopp
Сравнивая текущее значение с значением в аккумуляторе
Viktar
Сравнивая текущее значение с значением в аккумуляторе
вроде получилось
aggregate([
{'$geoNear': {
'near': {'type': "Point", 'coordinates': one['loc_mdb']},
'distanceField': "distance",
'maxDistance': 1603,
'query': {},
'includeLocs': "loc",
'spherical': True
}
},
{'$limit': 50},
{'$project': {'_id': 0, 'id': '$_id', 'knownResidents': 1, "street": 1, "streetSuffix": 1, "houseNumber": 1,
"zip": 1, "zip4": 1, "residentsCount": 1, 'distance': 1, 'loc': 1,
'res': {'$reduce':
{'input': "$knownResidents",
'initialValue':1,
'in': {
'$cond': [{'$gte': ["$$this.years", "$$value.years"]}, "$$this", "$$value"]}}
}
}}
])
питоновский код
Viktar
Спасибо
 Bogdan
Подскажите пожалуйста, как применить regex для ObjectId? Гугл до дыр затер, все примеры на других полях, что по аналогии не работает с ObjectId
yopp
yopp
То что вы видите в виде hex символов это репрезентация значения, а не само значение. Вероятно сработают escape последовательности, типа \xDA
Bogdan
Понял, спасибо большое
Bogdan
То что вы видите в виде hex символов это репрезентация значения, а не само значение. Вероятно сработают escape последовательности, типа \xDA
А то, что с оператором $or тоже не работает, причина в этом же?
Т.е если я указываю в $or _id и еще одно поле, то не работает
yopp
Вам необходимо явно передавать значение для оператора в типе ObjectId
Bogdan
Я так и делаю, тут уже без регулярок, точное значение передаю для ObjectId и другого поля
yopp
Я так и делаю, тут уже без регулярок, точное значение передаю для ObjectId и другого поля
Очень часто передают строку, вместо ObjectId типа. Проверьте что у вас без $or работает прямое совпадение по _id
 Dezmunt
Вопрос, хочу чекать изменения через watch. Вот повесил я обработчик, но допустим я хочу его удалить, как это сделать? (mongoose)
Dezmunt
Вопрос, хочу чекать изменения через watch. Вот повесил я обработчик, но допустим я хочу его удалить, как это сделать? (mongoose)
Ничего не нашел конкретно в Гугле, видел есть плагин для монгуса, и там а инстансе был метод destroy, но охото без плагинов
Евгений
 Евгений
 Levon
Добрый день
Подскажите пожалуйста как можно сделать сортировку по двум полям ? В документации нет того, что мне нужно.
Есть коллекция продуктов. Нужно сделать сортировку по цене и по количеству. Но нужно товары сначало сортировать по цене, а потом чтобы товары которые не в наличии, шли после тех которые в наличии.
Есть идеи ?
 Vladislav
Добрый день
Подскажите пожалуйста как можно сделать сортировку по двум полям ? В документации нет того, что мне нужно.
Есть коллекция продуктов. Нужно сделать сортировку по цене и по количеству. Но нужно товары сначало сортировать по цене, а потом чтобы товары которые не в наличии, шли после тех которые в наличии.
Есть идеи ?
https://stackoverflow.com/questions/12517167/sorting-on-multiple-fields-mongo-db
Dezmunt
как запустить несколько реплик в фоне? А то получается я на стандарном порту примари запустил, надо еще две секондари
Viktar
для каждой реплики прописываете свой конфиг и запускаете
Dezmunt
А, ну ок
 Pavel
ребята, у меня есть коллекция с пользователями, я хочу оттуда извлечь 2 поля, подскажите как сделать. P.S схемы с этими пользорвателями нету
Pavel
в голоу лезет вариант с "ref", но для него нужна схема
Pavel
без схемы реально сделать?
 Joe
в голоу лезет вариант с "ref", но для него нужна схема
Причем тут реф. Если нужно из 1 документа в коллекции нужно только 2 поля выдернуть, нужно просто проекцию сделать и указать названия полей.
Возможно вопрос неверно задан
Pavel
а можно полчить доступ к коллекции без схемы?
Joe
Только не понятно что имеется и что нужно получить в итоге
Pavel
Только не понятно что имеется и что нужно получить в итоге
я хочу получить доступ к коллекции, чтобы извлечь оттуда 2 поля
Pavel
 Pavel
понятно в чем вопрос?
WolderVsrat
Кажется, что стандартным getCollection это без проблем достается
Тут так понимаю имеет место быть mongoose , конкретно для него не смогу подсказать
Vladislav
Pavel
спасибо
Pavel
Кажется, что стандартным getCollection это без проблем достается
Тут так понимаю имеет место быть mongoose , конкретно для него не смогу подсказать
db.getCollection('<collection>') вот так получаем доступ к коллекции, а как обьект db?
Евгений
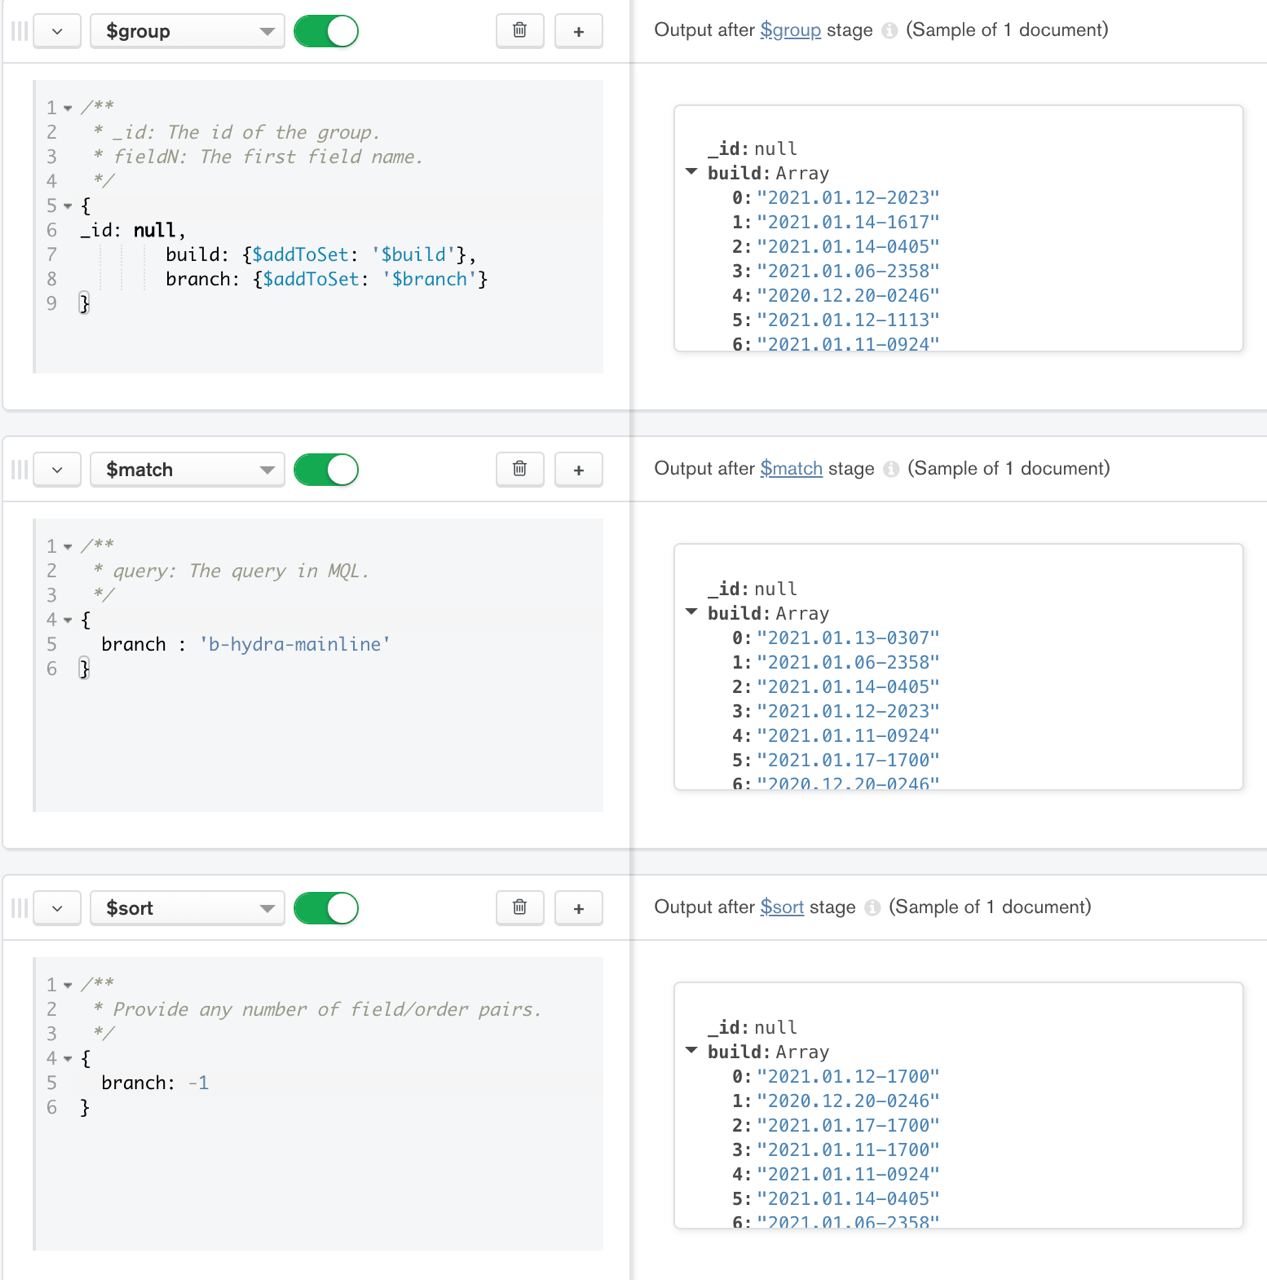
а кто-то может подсказать как правильно протолкнуть дальше по пайплайну коллекцию $addToSet и раскрутить чтобы посчитать сумму?
 Nikita
привет. кто-н знает, как решить проблему медленной выгрузки данных из mongodb?
есть коллекция, в ней десятки миллионов документов. мы запрашиваем 10 тысяч документов db.endpoints_results.find().limit(10000) и это занимает 40 секунд
Bogdan
Евгений
смотря как это раскручивает фронт, если это в таблицу, то выборка делается по 50-100 доков и таблица на фронте адаптируется, либо сужать поиск и количество полей
Anonymous
Хорошо, спасибо
Bogdan
nodejs
let cursor = db.endpoints_results.find().limit(10000)
cursor.on("data", async function (data) {
// событие на каждый новый документ
});
cursor.on("end", async function () {
// событие по окончании выборки
});
Bogdan
А в чем ошибка? Не обновляет?
Bogdan
Попробуйте на идентичных данных в песочнице
İskender
Вопрос к тем, кто хранит bcrypt hash в монго. Можно ли искать по этому хэшу? Знаю, что для сравнения хэша нужно использовать bcrypt.compare(plainTextPassword, hash), т.е. лучше искать документ по другому ключу и сравнивать хэш. А может ли этот хэш быть единственным фильтром для поиска?
 Melonges
Есть смысл десктопную версию монги качать или в браузерной есть все тоже самое?
 StaniFe
можно сделать set через foreach и $slice. Погугли, там куча примеров
Melonges
Как лучше подключать mongo? Через монгус или так https://metanit.com/web/nodejs/6.1.php
StaniFe
Это просто медленный вариант исполнения задачи. Про slice ничего особо не скажу, так как не углублялся в этот вопрос.
yopp
inventory.0.isActive
https://docs.mongodb.com/manual/core/document/#dot-notation
 AI
Народ, прошу совета
Работаю над архитектурой приложения сейчас
Есть посты, у поста есть поле с тегами
И есть сущности, каждой сущности присвоен свой тег
Так вот вопрос, теги у поста лучше сделать массивом или строкой? Как монга будет быстрее поиск делать? по массиву через $in или по вхождению строки, как то паттерном ?
Roman Khonichev
через массив
 Ilya
В рамках транзакции произвожу вставку большой пачки документов в одну определенную коллекцию, скажем, около двух-трех тысяч. Транзакция успешно завершается. Однако сразу после транзакции я запрашиваю все вставленные документы методов find, и мне ничего не возвращается. Почему я при запросе "свежевставленных" документов, которые вставились в процессе транзакции, в ответ получаю пусто? Запрос этот делаю сразу после того, как завершается транзакция.
Все это происходит на Replica Set из 3-х нод. Параметры транзакции: readConcern - snapshot, writeConcern - majority, readPreference - primary.
В чем проблема, хоть убей не пойму. Прям магия какая-то.
Отмечу еще пару любопытных моментов. Когда я запускаю транзакцию, отслеживаю состояние через Robo 3T. И там все документы сразу появляются без проблем после транзакции. Кроме того, если после транзакции не сразу запрашивать find, а через setTimeout в 1 секунду, то все документы вернутся.
Такое впечатление, будто монговские транзакции не очень то и ACID. О какой durability может идти речь, если после успешного коммита я не могу сразу получить вставленные документы?
 Артем
Чтение происходит с праймари? Просто запись не сразу по репликам распространяется
Ilya
Чтение происходит с праймари? Просто запись не сразу по репликам распространяется
Насколько я понимаю, readPreference - primary стоит по умолчанию. А сам я readPreference специально не указывал ни в подключении к базе, ни в самом запросе.
Ilya
Не понятно, вы в робо 3т видите документы, а из кода нет?
Ага, и это как раз происходит, видимо, из-за того, что документы "появляются" и "становятся видимыми" для обычных запросов спустя некотрое количество мс после коммита транзакции. Поэтому когда я обновляю робо 3т, то там они уже успевают появится.
Вопрос тут в acid принципах, Durability же вроде должно гарантировать, что если коммит произошел, то изменения уже железно находятся в базе.
Ilya
Возможно, дело в том, что как раз в рамках транзакции большое кол-во документов вставляются. Но тогда вопрос, как мне быть, и какие у меня гарантии тогда?
Andrey
А спустя время в робо видны документы?
Ilya
А спустя время в робо видны документы?
Да, спустя время в робо документы появляются. Да и для запроса с бэкенда они тоже появляются. Причем время это весьма маленькое, думаю, в районе 500 мс после коммита на вскидку.
Ilya
Проблема то была как раз в том, что СРАЗУ после коммита мне нужно обратиться к вставленным транзакционно документам. А из-за вот такого казуса не могу это сделать.
Andrey
то есть через 0.5 секунду и вставки нескольких тысяч документов - документы становятся доступны...тогда что не так
Ilya
Не совсем так. 0.5 секунд происходит спустя после коммита. В чем же тогда смысл транзакции, если после коммита состояние базы не консистентно?
Ilya
У меня на самом деле есть один вариант - сразу после транзакции рекурсивно вызывать метод find по вставленным докам, пока он не вернет наконец не пустой ответ, таким образом "дожидаться", и потом уже идти дальше по коду
Ilya
но это как то совсем костыльно
WolderVsrat
По идее с majority и snapshot данные и правда должны быть доступны после коммита, по крайней мере документация это описывает. Все же похоже, что не совсем нормальное поведение. (Это правда не совсем к durability, а к consistency, но это так, отступление)
Хотя я в транзакциях несколько тысяч доков обычно не фигачил, может особенность растечки данных по репликам
WolderVsrat
Можно начать с глупых причин
Чисто теоретически, может быть такое, что запрос на чтение выполняется раньше окончания или даже начала транзакции (то есть надо в коде попробовать поиграться)
А давая задержку на выполнение, как раз появляется шанс, что чтение будет уже после коммита
Но это так, догадки на кофейной гуще
Ilya
Можно начать с глупых причин
Чисто теоретически, может быть такое, что запрос на чтение выполняется раньше окончания или даже начала транзакции (то есть надо в коде попробовать поиграться)
А давая задержку на выполнение, как раз появляется шанс, что чтение будет уже после коммита
Но это так, догадки на кофейной гуще
Это я проверил первым делом, но там точно все нормально, код выполняется синхронно, последовательно.
Буквально так:
const result = await transaction( ... )
const docs = await find( ... )
yopp
Народ, прошу совета
Работаю над архитектурой приложения сейчас
Есть посты, у поста есть поле с тегами
И есть сущности, каждой сущности присвоен свой тег
Так вот вопрос, теги у поста лучше сделать массивом или строкой? Как монга будет быстрее поиск делать? по массиву через $in или по вхождению строки, как то паттерном ?
Массив. Его можно проиндексировать и выбирать документы вне зависимости от проложения тега в массиве. По строке эффективный поиск возможет только по префиксу или криво через текстовый индекс
yopp
Посмотрите что в explain. Возможно ваш запрос не покрывается создаными индексами
yopp
Для find readConern не указывал, так что там наверное по умолчанию.
В таком случае вам нужен linearizable или majority