 Александр


 Vladislav
Привет всем. Есть две коллекции A и B, мне нужно их сджойнить. а потом отфильтровать данные по полям в коллекциях в A и B (поля индексированы). допустим, я строю пайплайн: $match(по полям из коллекции A)->$lookup->$unwind->$match(по полям из коллекции B).
Vladislav
И я так понимаю, что в последнем $match индексы использоваться не будут?
Vladislav
это решается только версией $lookup с let/pipeline ?
 yopp
$lookup по B сразу с $match условием
yopp
а зачем $unwind?
yopp
yopp
Александр
yopp
есть функция:
func add(x):
startTransaction()
find(id = 1)
newCount := calc()
update(total = count) // например
update(items.add(count + 1))
commitTransaction()
return newCount+1
есть документ, например {id:1, total: 3, items:[1,2,3]}
соответственно: два параллельный запуска fb(4)
читают документ, получают одинаковый
считают например items, получают 3
потом оба обновляют
и оба возвращают 3
если две транзакции меняют один документ, то применится только одна
 Alexander
вы хотите искать по полному совпадению?
Для начала хотел бы помнять, что означает данный синтаксис, не смог нагуглить ничего ((
yopp
Для начала хотел бы помнять, что означает данный синтаксис, не смог нагуглить ничего ((
$search это pipeline strage который доступен только в облачной версии монги. он использует поисковый движок lucene
https://docs.atlas.mongodb.com/reference/atlas-search/query-syntax/#std-label-query-syntax-ref
Alexander
$search это pipeline strage который доступен только в облачной версии монги. он использует поисковый движок lucene
https://docs.atlas.mongodb.com/reference/atlas-search/query-syntax/#std-label-query-syntax-ref
Спасибо большое, тут как раз это и нужно. А я все перерыл не могу понять почему в манах нигде нет
Alexander
Что нужно что б работал поиск по полю?
yopp
Если у вас монга в Atlas, то https://docs.atlas.mongodb.com/reference/atlas-search/tutorial/
Alexander
Если у вас монга в Atlas, то https://docs.atlas.mongodb.com/reference/atlas-search/tutorial/
Спасибо вам, добрый человек, дай вам Бог здоровья.
Пойду разбираться.
Vladislav
а зачем $unwind?
чтобы удобно $match сделать по коллекции B, так как после lookup стадии там массив появится из одного элемента) а связь у меня один-к-одному
 Anatoly
 Anatoly
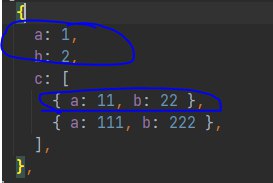
Коллеги, подскажите способ поменять местами выделенные свойства при агрегации
yopp
чтобы удобно $match сделать по коллекции B, так как после lookup стадии там массив появится из одного элемента) а связь у меня один-к-одному
$unwind дорогая операция, если нужно просто из массива размером в один элемент сделать поле, то эффективнее использовать $reduce
CrusaderX
А где можно почитать/узнать, какие операции "дорогие"?
Vladislav
yopp
А где можно почитать/узнать, какие операции "дорогие"?
для агрегаций, всё что увеличивает размер пайплайна — дорого
yopp
как и в любой другой базе, подзапросы дорого
CrusaderX
Понял, благодарю
yopp
можно начать отсюда: https://docs.mongodb.com/manual/core/aggregation-pipeline-optimization/
 Sardor
Всем привет! Подскажите, пожалуйста, как посчитать количество документов в коллекции с одинаковым полем?
Например, есть 100 документов и у всех есть поле type, которое может быть двух значений. Мне нужно знать, сколько документов первого типа и сколько второго
 Sergey
Всем привет! Подскажите, пожалуйста, как посчитать количество документов в коллекции с одинаковым полем?
Например, есть 100 документов и у всех есть поле type, которое может быть двух значений. Мне нужно знать, сколько документов первого типа и сколько второго
Посмотри в сторону аггрегации и group с count
Anatoly
 Dezmunt
Ребят, на JS map-ом перебираю и правлю массив значений, потом перезаписываю поле, и пытаюсь сохранить, но данные не сохраняются, почему так?
Dezmunt
Типа это все курсор итд?
Sardor
Посмотри в сторону аггрегации и group с count
Написал такое (драйвер для ноды):
db.lodgers
.aggregate(
{ "$group": { "_id": "$dorm", "count": { "$sum": 1 } } }
).toArray()
— не работает(
Sardor
model.countDocuments({type: 1})
дело в том, что типов может быть не два, а много. Тогда по этому варианту придется делать n запросов
Sergey
Написал такое (драйвер для ноды):
db.lodgers
.aggregate(
{ "$group": { "_id": "$dorm", "count": { "$sum": 1 } } }
).toArray()
— не работает(
Группируйте только по типу, и там можно посчитать сколько именно нашлось, если напишите в личку, завтра смогу помочь
Sardor
Группируйте только по типу, и там можно посчитать сколько именно нашлось, если напишите в личку, завтра смогу помочь
Запутал я, прошу прощения. Тип приводил как пример. Мне нужна группировка по полю "dorm"
Sergey
Sardor
Не меняет сути)
тогда не совсем понял, о чем Вы)
написал такое, просто выводит все документы:
app.db.lodgers
.aggregate(
{ "$group": { "_id": "$dorm" } }
).toArray()
в личку отпишусь сейчас лучше)
Anatoly
тогда не совсем понял, о чем Вы)
написал такое, просто выводит все документы:
app.db.lodgers
.aggregate(
{ "$group": { "_id": "$dorm" } }
).toArray()
в личку отпишусь сейчас лучше)
rкак то так можно model.aggregate( [
{
$facet: {
"type1Count": [
{
$match: {
type: 1
}
},
{
$count: "type1Count"
}
],
"type2Count": [
{
$match: {
type: 2
}
},
{
$count: "type2Count"
}
],
}}])
Sardor
Нашел решение:
https://stackoverflow.com/a/33418582/9545396
Sardor
@KiryakovSergey, @meltice, спасибо!
 Alexander
если две транзакции меняют один документ, то применится только одна
Это понятно. Тут вопрос даже не в сомом изменении, а в чтении после старта транзакций
Sardor
Вопросик насчет двойной сортировки (если так правильно ее называть)
Мне нужно получить место в рейтинге, основанное на поле curPoints, и если несколько документов с одинаковыми curPoints, то еще отсортированном по lastName
Не могу понять, как поступить с $gt, или вообще не в ту сторону копаю.
model.find({
curPoints: { $gt: lodger.curPoints },
dorm: lodger.dorm
}).sort({ curPoints: -1, lastName: 1 }).count()
При $gt тут обрезаются все документы, у которых curPoints равен значению в текущем документе, и сортировка по lastName не учитывается.
При $gte учитываются все документы с таким же значением curPoints, но в конце .count() считает их всех и получается, что текущий документ в самом конце, и опять нет сортировки по lastName
Как в отсортированном списке по curPoints с $gte я могу посчитать документы до места, в котором должен быть текущий документ, учитывая сортировку по lastName?
Jasur
Всем привет. Я сделал CRUD с помощью express mongodb. Теперь хочу его в где-то в интернет поставить. Чтобы через ссылку можно было достучаться. Как это делать ? Я сам фронтенд разработчик. Пробую бэкенд
 Yaroslav
Всем привет, не могу вникнуть в проблему, у меня есть watcher cursor на коллекцию, и мы наблюдаем очень большое ops, пытаюсь глубже вникнуть тут https://docs.mongodb.com/manual/changeStreams/#changestreams, и у меня правильное ли понимание, сто когда монга открывает changestream, то в цикле обрабатывает события по коллекции?
Yaroslav
Вообще как правильно настроить его? Может это не самое лучшие решение чтобы его использовать?
Yaroslav
Задача у меня простая, некий Observable паттерн реализован, жду новую запись в коллекции и потом запускаю обработку данных
 Paul
привет
у меня перестала коннектиться монга, хотя до этого всегда норм работала
Error: querySrv ETIMEOUT _mongodb._tcp.cluster.bvzti.mongodb.net
кто-то сталкивался с такой проблемой?
Andrii
всем привет, один сервер накрылся с монгой и надо было переехать на другой сервер, поставил монгу, переключили приложение, но нагрузка скаканула в 5 раз на новом сервере, конфиг взял с предыдущего сервера
по логам вижу, что долго выполняются запросы
2021-02-18T09:09:25.078+0000 I COMMAND [conn535] command db.slots command: find { find: "slots", filter: { user_id: 3729583, item_id: { $gte: 18000, $lte: 18999 } }, projection: { _id: 1, item_id: 1 }, sort: { _id: 1 }, limit: 1, singleBatch: true } planSummary: IXSCAN { _id: 1 } keysExamined:102717 docsExamined:102717 cursorExhausted:1 numYields:829 nreturned:1 reslen:141 locks:{ Global: { acquireCount: { r: 1660 } }, Database: { acquireCount: { r: 830 } }, Collection: { acquireCount: { r: 830 } } } protocol:op_query 3363ms
2021-02-18T09:09:25.129+0000 I COMMAND [conn102] command db.items command: distinct { distinct: "items", key: "item_id", query: { user_id: 3660363 } } planSummary: COLLSCAN keysExamined:0 docsExamined:731121 numYields:5772 reslen:1434 locks:{ Global: { acquireCount: { r: 11546 } }, Database: { acquireCount: { r: 5773 } }, Collection: { acquireCount: { r: 5773 } } } protocol:op_query 8666ms
2021-02-18T09:09:25.138+0000 I COMMAND [conn531] command db.friendship_requests command: count { count: "friendship_requests", query: { user_id: 3861262 } } planSummary: COLLSCAN keysExamined:0 docsExamined:354775 numYields:2796 reslen:44 locks:{ Global: { acquireCount: { r: 5594 } }, Database: { acquireCount: { r: 2797 } }, Collection: { acquireCount: { r: 2797 } } } protocol:op_query 3706ms
2021-02-18T09:09:25.168+0000 I COMMAND [conn519] command db.slots command: find { find: "slots", filter: { user_id: 3215251, item_id: { $gte: 18000, $lte: 18999 } }, projection: { _id: 1, item_id: 1 }, sort: { _id: 1 }, limit: 1, singleBatch: true } planSummary: IXSCAN { _id: 1 } keysExamined:93599 docsExamined:93599 cursorExhausted:1 numYields:760 nreturned:1 reslen:141 locks:{ Global: { acquireCount: { r: 1522 } }, Database: { acquireCount: { r: 761 } }, Collection: { acquireCount: { r: 761 } } } protocol:op_query 3431ms
2021-02-18T09:09:25.310+0000 I COMMAND [conn101] command db.items command: count { count: "items", query: { user_id: 3856850 } } planSummary: COLLSCAN keysExamined:0 docsExamined:731121 numYields:5758 reslen:44 locks:{ Global: { acquireCount: { r: 11518 } }, Database: { acquireCount: { r: 5759 } }, Collection: { acquireCount: { r: 5759 } } } protocol:op_query 7637ms
2021-02-18T09:09:25.334+0000 I COMMAND [conn521] command db.slots command: find { find: "slots", filter: { user_id: 89343, item_id: { $gte: 18000, $lte: 18999 } }, projection: { _id: 1, item_id: 1 }, sort: { _id: 1 }, limit: 1, singleBatch: true } planSummary: IXSCAN { _id: 1 } keysExamined:103436 docsExamined:103436 cursorExhausted:1 numYields:836 nreturned:1 reslen:141 locks:{ Global: { acquireCount: { r: 1674 } }, Database: { acquireCount: { r: 837 } }, Collection: { acquireCount: { r: 837 } } } protocol:op_query 3439ms
хотя индексы вроде как есть
> db.slots.getIndexes()
[
{
"v" : 2,
"key" : {
"_id" : 1
},
"name" : "_id_",
"ns" : "db.slots"
}
]
подскажите куда копать или что можно сделать?
 Дмитрий
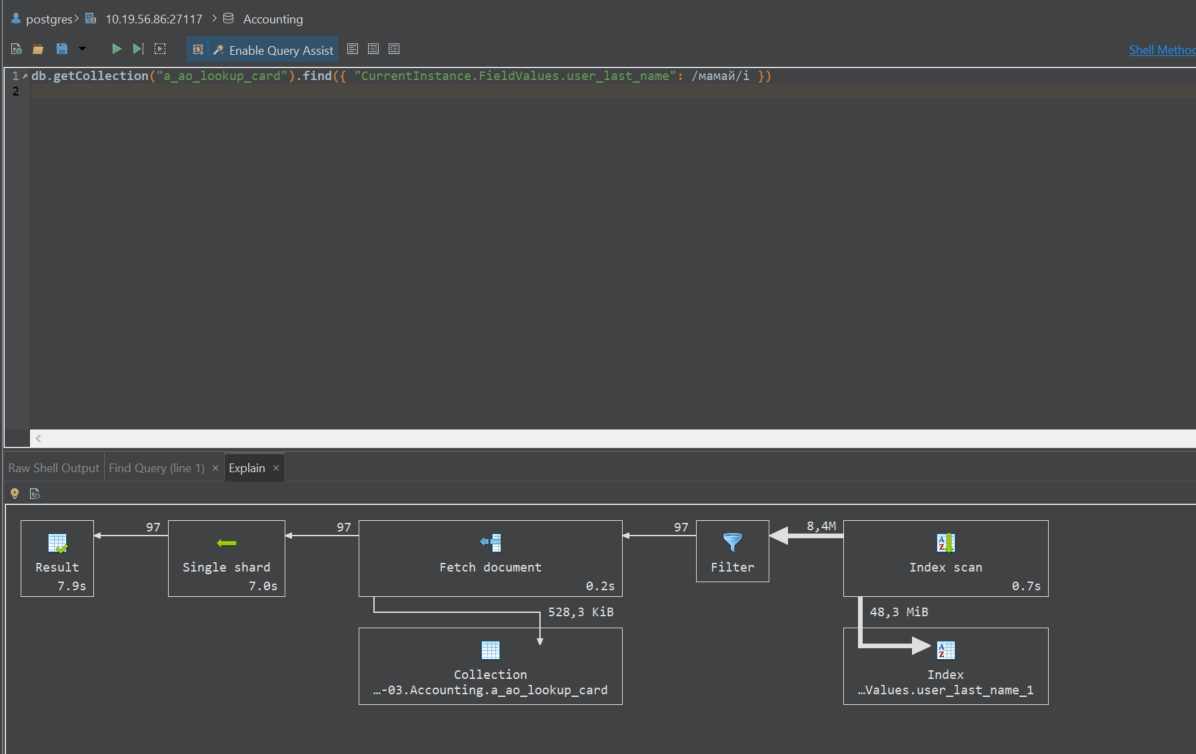
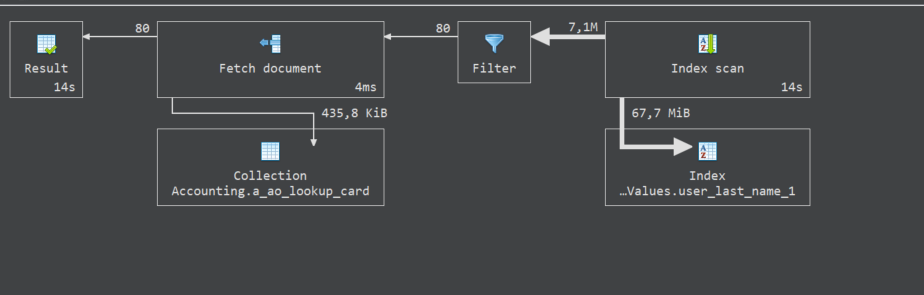
Коллеги, подскажите в чём может быть проблема, вижу следующее поведение на шардокластере и репликасете соответственно
Дмитрий
 Дмитрий
 Дмитрий
в чём может быть причина отдачи с шарды за 7 секунд? и почему фактическое время выполнения запроса расходится с эстимэйт довольно прилично, с репликасетом запрос выполняется 1,5 минуты вместо 14 секунд, а на шарде 35 вместо 8
Дмитрий
guys?
Дмитрий
и я вот слегка не понимаю, как запрос информации из коллекции может выполняться так долго
Дмитрий
{
"shard": "rs-shard-03",
"type": "op",
"host": "mongo-shard-03:27121",
"desc": "conn65148",
"connectionId": 65148,
"client_s": "--:36780",
"active": "true",
"currentOpTime": "2021-02-18T12:40:49.293+0000",
"effectiveUsers": [
{
"user": "--",
"db": "--"
}
],
"runBy": [
{
"user": "__system",
"db": "local"
}
],
"opid": "rs-shard-03:185508017",
"secs_running": 54,
"microsecs_running": 54647203,
"op": "getmore",
"ns": "Accounting.a_ao_lookup_linked_phone_number",
"command": {
"getMore": "8206869637141187447",
"collection": "a_ao_lookup_linked_phone_number",
"$clusterTime": {
"clusterTime": "6930582537060220930",
"signature": {
"hash": "Y7V9Mr6aOLU9JjJ3nSg/FCck3SI=",
"keyId": "6920500530829590536"
}
},
"$audit": {
"$impersonatedUsers": [
{
"user": "postgres",
"db": "admin"
}
],
"$impersonatedRoles": [
{
"role": "root",
"db": "admin"
}
]
},
"$configServerState": {
"opTime": {
"ts": "6930582537060220930",
"t": 24
}
},
"$db": "Accounting"
},
"planSummary": "IXSCAN { _id: 1 }",
"cursor": {
"cursorId": "8206869637141187447",
"createdDate": "2021-02-18T12:37:24.356Z",
"lastAccessDate": "2021-02-18T12:39:30.530Z",
"nDocsReturned": 8974,
"nBatchesReturned": 2,
"noCursorTimeout": false,
"tailable": false,
"awaitData": false,
"originatingCommand": {
"find": "a_ao_lookup_linked_phone_number",
"hint": {
"_id": 1
},
"runtimeConstants": {
"localNow": "2021-02-18T12:36:25.215Z",
"clusterTime": "6930581884225191937"
},
"shardVersion": [
"0",
"000000000000000000000000"
],
"$clusterTime": {
"clusterTime": "6930581884225191937",
"signature": {
"hash": "HAKVNDmz9KNCbhlyjiSjxxVE6Hk=",
"keyId": "6920500530829590536"
}
},
"$audit": {
"$impersonatedUsers": [
{
"user": "postgres",
"db": "admin"
}
],
"$impersonatedRoles": [
{
"role": "root",
"db": "admin"
}
]
},
"$configServerState": {
"opTime": {
"ts": "6930581867045322824",
"t": 24
}
},
"$db": "Accounting"
},
"operationUsingCursorId": 185508017
},
"numYields": 1897,
"locks": {
"ReplicationStateTransition": "w",
"Global": "r",
"Database": "r",
"Collection": "r"
},
"waitingForLock": "false",
"lockStats": {
"ReplicationStateTransition": {
"acquireCount": {
"w": 1898
}
},
"Global": {
"acquireCount": {
"r": 1898
}
},
"Database": {
"acquireCount": {
"r": 1898
}
},
"Collection": {
"acquireCount": {
"r": 1898
}
},
"Mutex": {
"acquireCount": {
"r": 1
}
}
},
"waitingForFlowControl": false,
"flowControlStats": {}
}
yopp
Судя по большим интервалам между createdDate и lastAccessDate у курсора, есть какая-то проблема с сетью
yopp
Сбросьте пожалуйста вывод explain("executionStats") для этого запроса в виде файла
yopp
привет
у меня перестала коннектиться монга, хотя до этого всегда норм работала
Error: querySrv ETIMEOUT _mongodb._tcp.cluster.bvzti.mongodb.net
кто-то сталкивался с такой проблемой?
Проверьте что IP с которого вы пытаетесь подключиться есть в белом списке Атласа
Paul
Проверьте что IP с которого вы пытаетесь подключиться есть в белом списке Атласа
Спасибо за ответ, но я открывал доступ с любого IP, это не помогло
Помогла смена с dns на стандартную строку подключения
yopp
Вероятно у вас где-то агрессивно кешируются dns ответы. Сравните что возвращае dig на любом публичном dns сервере (1.1.1.1 или 8.8.8.8) и сравните с тем, что возвращает ваш локальный резолвер.
Если проблема в кешировании, то и при явном перечисление нод могут быть проблемы, если адреса поменяются
yopp
dig @1.1.1.1 srv <fqdn>
Дмитрий
yopp
Дмитрий
Здесь у вас запрос по _id. Насколько я понял, задержки у вас наблюдаются с другим запросом
так, к сожалению не могу сейчас смоделировать этот запрос. могу привести пример из этих
Дмитрий
Дмитрий
Дмитрий
Дмитрий
@dd_bb меня что смущает, это отличие эстимэйта от реального выполнения в ~150 раз
 🐺
подскажите че делать если удалил sample таблицу в collections ? как восстановить
Artem
только по памяти
Artem
ну а вообще бэкап должен быть
Sardor
Вопросик насчет двойной сортировки (если так правильно ее называть)
Мне нужно получить место в рейтинге, основанное на поле curPoints, и если несколько документов с одинаковыми curPoints, то еще отсортированном по lastName
Не могу понять, как поступить с $gt, или вообще не в ту сторону копаю.
model.find({
curPoints: { $gt: lodger.curPoints },
dorm: lodger.dorm
}).sort({ curPoints: -1, lastName: 1 }).count()
При $gt тут обрезаются все документы, у которых curPoints равен значению в текущем документе, и сортировка по lastName не учитывается.
При $gte учитываются все документы с таким же значением curPoints, но в конце .count() считает их всех и получается, что текущий документ в самом конце, и опять нет сортировки по lastName
Как в отсортированном списке по curPoints с $gte я могу посчитать документы до места, в котором должен быть текущий документ, учитывая сортировку по lastName?
Я все по тому же вопросу. Возможно написать такой запрос, чтобы он отсортировал по curPoints, и после этого взять $lte по lastName, но применить $lte только к документам, у которых curPoints равно значению curPoints текущего документа?
 Roman
Есть запрос на получение всех записей, после которых стоит limit, куда передается значение из квериПараметра, а что нужно передать в параметр, чтобы он мне выдал все записи?
 Nick
Nick
Нет надо было передать Infinity
о как, не знал что можно такое передать. А вы с обычным драйвером работает или еще какие-то обертки?