Можно как-то моннге сказать что-бы свой _id документа присваевала моему полю id
Использую mongose
сорян за глупый вопрос.
Да, возможно через хуки, но зачем это?
 ✙ Nikita


 Sergey
Да, возможно через хуки, но зачем это?
В свагере я передаю response DTO классы. А в них нет этих полей.
И получается какой-то брет, свагер показывает что я возвращаю данные без ID но там есть _id который нужно использовать везде
✙ Nikita
В свагере я передаю response DTO классы. А в них нет этих полей.
И получается какой-то брет, свагер показывает что я возвращаю данные без ID но там есть _id который нужно использовать везде
Не понял, почему ориганльную _id нельзя указать в сваггере
✙ Nikita
Просто сам факт что у тебя будут два одинаковых поля кажется мне глупым
 Artem
VersionError: No matching document found for id "5ffb59a437f6c6347e8a2cd6" version 6 modifiedPaths "participantsWithoutBets" Что означает ошибка? Чет ничего не понял.
Документы вида { _id, participantsWithoutBets: [Number}}
✙ Nikita
VersionError: No matching document found for id "5ffb59a437f6c6347e8a2cd6" version 6 modifiedPaths "participantsWithoutBets" Что означает ошибка? Чет ничего не понял.
Документы вида { _id, participantsWithoutBets: [Number}}
вроде значит что ты пытаешся сохранить документ старой версии, когда новый уже в базе
✙ Nikita
это в контексте чего?
✙ Nikita
орм или просто запрос в монге?
Artem
вроде значит что ты пытаешся сохранить документ старой версии, когда новый уже в базе
У меня там массив, который сначала наполнен, а потом постепенно опустошается, разумеется, он может возвращаться в старые состояния.
✙ Nikita
у меня такое было когда над одним документов одновременно работало несколько функций, что нежелатльно было
Artem
у меня такое было когда над одним документов одновременно работало несколько функций, что нежелатльно было
У меня одна функция работает
Artem
он судя по всему ругается на то что я пытаюсь сохранить массив в том состоянии, в каком он был одно сохранение назад
 Dmitry
все привет
делаю аггрегацию по полям, чтобы посчитать уникальные поля
некоторые поля текстовые и достаточно большие, поэтому монга крашится из-за лимита в 16 мегабайт на 1 документ
есть ли какая-то функция, которая позволит взять хеш от значения поля и добавить его в сет?
Dmitry
документацию пересмотрел, нашел только toObjectId, но она не срабатывает на полях меньше 24-х символов
Dmitry
можно это, конечно, обойти, но, может, есть какая-то мд5 функция?
Dmitry
попробую через $function решить
 Denis
все привет
делаю аггрегацию по полям, чтобы посчитать уникальные поля
некоторые поля текстовые и достаточно большие, поэтому монга крашится из-за лимита в 16 мегабайт на 1 документ
есть ли какая-то функция, которая позволит взять хеш от значения поля и добавить его в сет?
А почему бы для таких полей не хранить отдельно md5 строку, и делать group по ней
Denis
У меня там массив, который сначала наполнен, а потом постепенно опустошается, разумеется, он может возвращаться в старые состояния.
Используй атомарные операторы типа $ push pull addToSet, а не читай док в код и редактируй через код
Artem
Artem
Удобнее сейв
Artem
Сейв небезопасен для конкурентной работы, результат этого удобства ты уже словил
У меня все на сейвах
Artem
На будущее учту, а это переписывать нет желания
Denis
У меня все на сейвах
Делай мьютекс на методы/эндпоинты. Чтобы не было конкурентных апдейтов
Или переписать на атомарные монго операторы, или мьютекс, других решений здесь нет
 Антон
Кто то может помочь с кодом для телеграмм бота?
Artem
На голом апи пишешь?
 Josh
приборы
 Josh
https://www.anekdot.ru/id/303521/
Anonymous
курс биткоина знает кто нибудь?
Антон
Кто поможет или подскажет
Josh
да
WolderVsrat
Кто то может помочь с кодом для телеграмм бота?
Если верить твоему никнейму, то такого вопроса не должно было возникнуть
Ещё и чате про бд
Или это мультиакк/купленный аккаунт?
Антон
Если верить твоему никнейму, то такого вопроса не должно было возникнуть
Ещё и чате про бд
Или это мультиакк/купленный аккаунт?
Куплен акк. И я учусь потихоньку
WolderVsrat
"куплен акк"
Почему я не удивлен)))
Какая-то массовая аномалия)
WolderVsrat
@js_noobs_ru
@js_ru
Можешь там спросить, уточнив, с чем именно трудности в написании своего бота )
WolderVsrat
И объясните мне, в чем прикол "покупки акков" в ТГ?)
Я может чего не понимаю конечно...
Может кто шарит просто)
Dmitry
А почему бы для таких полей не хранить отдельно md5 строку, и делать group по ней
да, это вариант, но он мне сейчас не нужен: легче извернуться в агрегации, чем бежать по всей коллекции существующей
WolderVsrat
Так, а может кто в курсе, можно ли сгенерить в агрегэйте список дат с группировочкой для дальнейшей цепочки?
То есть например кидаю ему начальную (2021-01-09 0.0) и конечную (2021-01-11 23.59) дату и прошу сгруппировать по дням, в итоге три строки на выходе 9,10 и 11 ое
Я тут на вертике привык к timeseries, а тут чот идей и нет
Только если нагенерить на бэке и отдать массив дат с нужной агрегацией в монгу, но звучит как будто костыль)
WolderVsrat
Хотя похоже закрыт вопрос странным решением
Вкинул сгенеренный в коде массив в $set, дальше уже можно юзать
Это ломает мой sqlный мозг
 Nick
все привет
делаю аггрегацию по полям, чтобы посчитать уникальные поля
некоторые поля текстовые и достаточно большие, поэтому монга крашится из-за лимита в 16 мегабайт на 1 документ
есть ли какая-то функция, которая позволит взять хеш от значения поля и добавить его в сет?
как вы делаете подсчет что вылезаете за 16мб?
Artem
Сейв небезопасен для конкурентной работы, результат этого удобства ты уже словил
так че делать с этим вашим VersionError ?(
у меня был массив [] -> [1,2] -> [2] -> [] => VersionError
Denis
так че делать с этим вашим VersionError ?(
у меня был массив [] -> [1,2] -> [2] -> [] => VersionError
Брат, почитай вчерашний тредик. Я написал тебе решение
 Александр
А почему бы для таких полей не хранить отдельно md5 строку, и делать group по ней
md5 лучше хранить в поле типа UUID
Dmitry
как вы делаете подсчет что вылезаете за 16мб?
Там все из-за одного текстового поля, который есть во всех документах
Dmitry
И по этому полю пошла агрегация в том числе
Dmitry
Можно было и обойтись, зато теперь ясно, как использовать function
Nick
Там все из-за одного текстового поля, который есть во всех документах
вы эти доки собираете чтоли?
Dmitry
нужно было проверить процент уникальных значений по всем полям во всех документах
 Danil
Всем привет. Подскажите, пожалуйста, как можно изменить вложенный массив? Нужно поменять статус на true http://joxi.ru/LmGO5KDCldGJPm
http://joxi.ru/EA40XGvTpqYpKA на 63 строке данные меняются на true но на 64 save не сохраняет/обновляет данные в базе
A
Всем привет!
Хочу посоветоваться, подходил ли mongodb в качестве новой бд для существующего проекта.
Проект:
Конфигуратор шкафов, который позволяет выбрать габариты и совместимые материал, тип дверей, полок, крепления, ручки и т.д.
Например у разных типов дверей, могут быть разные типе петлей, для каких-то нужны всего две петли, для других три.
Сейчас этот проект реализован на реляционной БД, поддерживать такой проект стало очень сложным.
Т.к. постоянно появляются новые коплектующие, со своими зависимостями, и спецификой, и все это внедрять в структуру БД очень сложно.
С документоориентированными бд знаком только теоритически, и мне кажется наша задача хорошо ложится на такой тип баз данных.
Как считаете, насколько это может упростить разработку и поддержку, или же стоит продолжать на реляционном БД и ли не стоит тратить время на изменение бд ?
Какие могут быть сложности ? и на что стоит обратить внимание ?
Были ли у вас похожие проекты ?
 Anton
Всем привет!
Хочу посоветоваться, подходил ли mongodb в качестве новой бд для существующего проекта.
Проект:
Конфигуратор шкафов, который позволяет выбрать габариты и совместимые материал, тип дверей, полок, крепления, ручки и т.д.
Например у разных типов дверей, могут быть разные типе петлей, для каких-то нужны всего две петли, для других три.
Сейчас этот проект реализован на реляционной БД, поддерживать такой проект стало очень сложным.
Т.к. постоянно появляются новые коплектующие, со своими зависимостями, и спецификой, и все это внедрять в структуру БД очень сложно.
С документоориентированными бд знаком только теоритически, и мне кажется наша задача хорошо ложится на такой тип баз данных.
Как считаете, насколько это может упростить разработку и поддержку, или же стоит продолжать на реляционном БД и ли не стоит тратить время на изменение бд ?
Какие могут быть сложности ? и на что стоит обратить внимание ?
Были ли у вас похожие проекты ?
Конечно стоит, сложность не двигатель прогресса, а с mongodb даже быстрее будет, запросы можно в 99% случаев подобрать
A
Конечно стоит, сложность не двигатель прогресса, а с mongodb даже быстрее будет, запросы можно в 99% случаев подобрать
спасибо!
предположим у меня в коллекции будут такие данные:
{
id: 1,
name: "test 1",
dimensions: { width: 10, height: 15, .. }
}
...
сложно ли будет сделать выборку по всем документам коллекции, и получить список всех уникальных размеров, например параметра width ?
Anton
спасибо!
предположим у меня в коллекции будут такие данные:
{
id: 1,
name: "test 1",
dimensions: { width: 10, height: 15, .. }
}
...
сложно ли будет сделать выборку по всем документам коллекции, и получить список всех уникальных размеров, например параметра width ?
Да по идее не сложно
Я бы поставил индекс на “dimensions.width” и сделал бы distinct
 MDWIT
 Nick
MDWIT
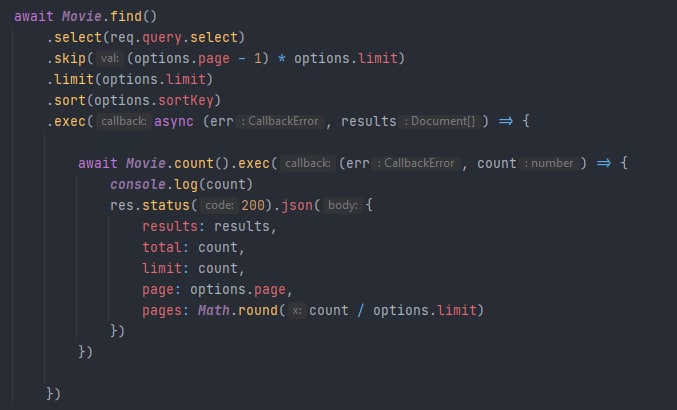
Условие для поиска потеряли то, что в селект в первом запросе передается
хм, я думал можно и без условий)
В селект передаю 'data person'
MDWIT
{
select: 'data persons',
limit: '10',
sortKey: 'data.rating',
sort: 'asc',
page: '2'
}
Вот все параметры по которым происходит фильтрация
MDWIT
а хотя да, проблема то была когда я find прописывал 🙈
MDWIT
так он мне все поля выводит
Nick
Вам нужен фильтр из req.query.select
Nick
Он должен быть и в каунте
✙ Nikita
а что имеется ввиду сделать более оптимизированно? удаление убыстрить?)