Почему?
У нас только кластерные решения разрешены. Сейчас файлы в Ceph лежат, но с ним проблем много, я думаю не перетащить ли в монгу и их.
 Александр


 Dmytro
Всем привет
Подскажите плз, нормальная ли практика хранить в mongodb - Buffer?
Например, у меня должны быть 2 .bin файла привязаны к записи, размер у них маленький < 64kb, стоит ли хранить их в формате Buffer в БД или все таки нет?
 Дара
Hello world!
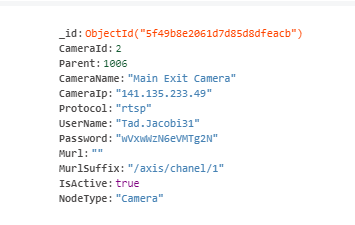
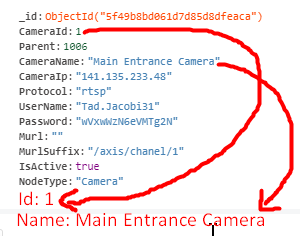
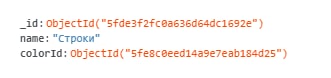
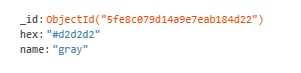
У меня есть такой документ. В коллекции есть 922 документов. На первой картинке настоящая структура документа и мне надо добавить два дополнительных поля. Грубо говоря мне надо скопировать CameraId => Id, CameraName => Name.
Можете подсказать как такой запрос написать на добавления?
Дара
 Дара
 Alexander
db.my_super_lamer_collection.find().forEach(d => {
db.my_super_lamer_collection.updateOne({
_id: d._id,
}, {
$set: {
Id: d.CameraId,
Name: d.CameraName,
}
})
})
Дара
Dr
У нас только кластерные решения разрешены. Сейчас файлы в Ceph лежат, но с ним проблем много, я думаю не перетащить ли в монгу и их.
Мы перетаскивали в Редис видеофрагменты трансляций, которые надо было хранить пару часов. Прирост от отказа хранения этих трансляций в виде файлов на ceph был колоссальный.
Александр
Мы перетаскивали в Редис видеофрагменты трансляций, которые надо было хранить пару часов. Прирост от отказа хранения этих трансляций в виде файлов на ceph был колоссальный.
да ещё бы) Но тут дело даже не в скорости, если получится вместо 3 СУБД юзать одну, будет всем проще жить
 Никита
 Никита
 Никита
 Никита
 Никита
 ✙ Nikita
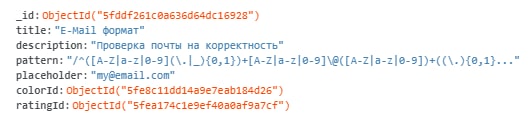
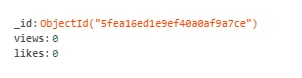
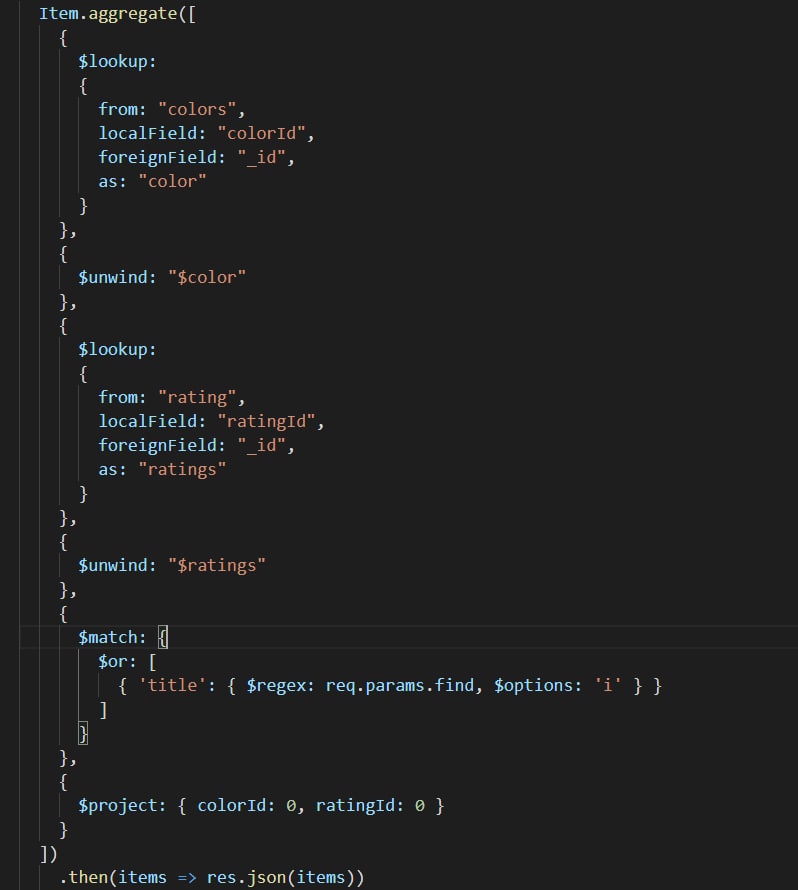
можно же прямо в само регулярное выражение записать likes ,views
Максим
+
 Egor
 Egor
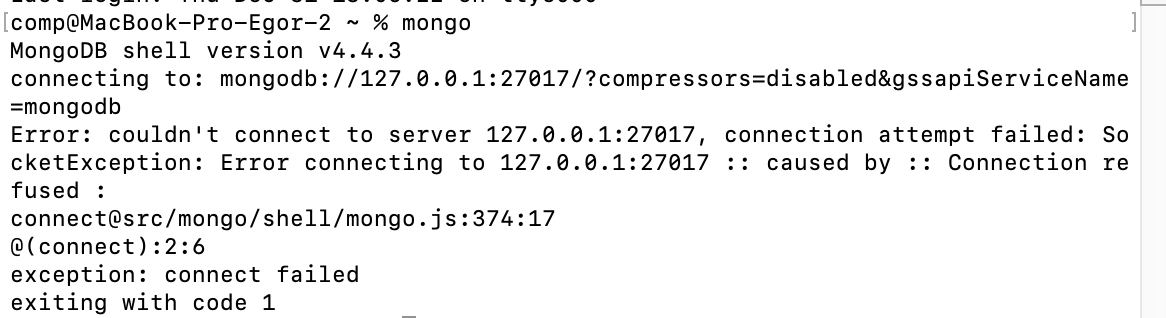
вроде починилось, нужно было перезагрузиться после смены владельца))
 Маrаt
Гениально
Маrаt
Сколько людей повелось уже?
 Joe
 Abdullah
friends can i use populate in mongodb compass?if yes how i do this?
Abdullah
друзья, могу ли я использовать заполнение в mongodb компасе? если да, как мне это сделать?
 AstraSerg
Happy new year!
ᅠ ᅠ ᅠ ᅠ
Всех с Новым Годом!
AstraSerg
Ура!
Максим
С Новым Годом!
Irisha
С Новым годом всех🌟🌟🌟🍾🍾
 Konstantin
С Новым счастьем
El
 охангаран
 Физик-ядерщик
С новым годом мужики
Физик-ядерщик
Такой вопрос
Физик-ядерщик
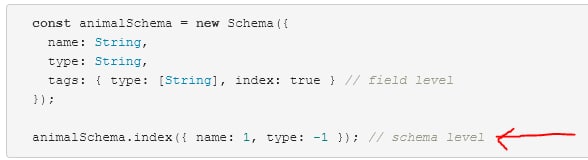
Если я хочу создать индексы через Mongoose, я должен прописывать их в схеме? Как вообще правильно создавать индексы в Mongoose?
Физик-ядерщик
 Физик-ядерщик
Так?
 Roman
Daniil
 Rustambek
Daniil
Но в целом прямо в описании схеме можно указать index
Физик-ядерщик
Лучше так не создавать индексы
Спасибо за ответ, каким образом тогда лучше создавать индексы?
 Artem
Какие условия сохранения через .save() ?
Artem
const model = await Model.findOne({})
model.x = 1
console.log(model) // {x: 1, _id: a}
await model.save()
console.log(await Model.findOne({})) // {_id : a}
Почему так происходит?
Artem
 Andrey
Народ, мне тут нужно сделать простенький дашборд на основе данных из коллекции. MongoDB Charts хорошо подойдут для такой цели? Их ведь можно завести локально? Удобная штука?
Маrаt
Когда деплою приложение в новое место, как лучше создавать индексы? Руками, или есть какие то другие методы?
Физик-ядерщик
Когда деплою приложение в новое место, как лучше создавать индексы? Руками, или есть какие то другие методы?
Во, мне тоже это интересно. У меня выше почти такой же вопрос был)
Маrаt
Можно еще придумать алгоритм чтобы таски не пересекались и несколько консюмеров юзать
Но тогда нужно правильный шардинг сделать, чтобы конкурирующие транзакции на разных консюмеров не попали.
Дмитрий
Доброго времени суток, я еще новичок в MongoDB и сейчас разбираюсь с агрегацией, ко мне приходит массив вида [ { count: 1, id: "5ff01dec80bd7a26fcb180f4" }, { count: 2, id: "5ff01dec80bd7a26fcb180f5" } ], мне нужно вставить поле count в каждый из документов где совпадает _id и потом count умножить на cost и все это просуммировать. Как выбить документы из массива id я разобрался, а вот как вставить count не могу понять. Не подскажет кто?
northern storm
Доброго времени суток, я еще новичок в MongoDB и сейчас разбираюсь с агрегацией, ко мне приходит массив вида [ { count: 1, id: "5ff01dec80bd7a26fcb180f4" }, { count: 2, id: "5ff01dec80bd7a26fcb180f5" } ], мне нужно вставить поле count в каждый из документов где совпадает _id и потом count умножить на cost и все это просуммировать. Как выбить документы из массива id я разобрался, а вот как вставить count не могу понять. Не подскажет кто?
update({id: id }, {«$set»{count : value }})
Если ты в базе хочешь заменить.
Дмитрий
update({id: id }, {«$set»{count : value }})
Если ты в базе хочешь заменить.
В базе такого поля нету, я хочу при агрегации добавить это поле, взяв значение из массива
 Nick
Когда деплою приложение в новое место, как лучше создавать индексы? Руками, или есть какие то другие методы?
По-хорошему нужно прогонять отдельно скрипты инициализации бд, где будет создание нужных коллекций и индексов. Но если у вас пет проджект без требований сопровождения то неважно как
Nick
В базе такого поля нету, я хочу при агрегации добавить это поле, взяв значение из массива
Агрегация про чтение, если нужно обновить, то начиная с 4.2 пайплайн агрегации можно указать в update и обновить данные
Dmytro
Всем привет
Подскажите плз, нормальная ли практика хранить в mongodb - Buffer?
Например, у меня должны быть 2 .bin файла привязаны к записи, размер у них маленький < 64kb, стоит ли хранить их в формате Buffer в БД или все таки нет?
Nick
Всем привет
Подскажите плз, нормальная ли практика хранить в mongodb - Buffer?
Например, у меня должны быть 2 .bin файла привязаны к записи, размер у них маленький < 64kb, стоит ли хранить их в формате Buffer в БД или все таки нет?
Если есть потребность в хранении для работы с данными в таком формате, то это нормально. Ничего не мешает периодически их выгружать во внешний холодный сторадж для длительного хранения, если нет необходимости постоянного доступа
 Ismat
У меня вопрос по перформансу,
Ситуация: у меня есть user и к каждому юзеру привязан список NPC, эти NPC уникальны для каждого юзера
Может быть несколько сотен НПС у каждого юзера.
Вопрос: хранить данные этих НПС внутри документа с юзером или хранить отдельными документами ? Инфо по НПС нужны в половине запросов
Ismat
Вариант что юзера отдельно, а весь array нпс относяший к юзеру в отдельном документе NpcList тоже есть
 Roman
Привет ребята, а на nosql надо делать нормализацию ?
Маrаt
Привет ребята, а на nosql надо делать нормализацию ?
обычно наоборот, денормализованно всё хранят
Roman
обычно наоборот, денормализованно всё хранят
Так из-за этого скорось поиска страдает разве нет ? И много других вещей
Маrаt
Так из-за этого скорось поиска страдает разве нет ? И много других вещей
При денормализации все в одном месте хранится, джоинов нету, так что наоборот все убыстряется.
 yopp
Не совсем
yopp
Нормализация делает запись дешевле, но мы платим за пересечение между несколькими источниками данных при чтении.
Денормализация делает запись очень дорогой, но при этом чтение становится дешевле, так как ничего не надо объединять
yopp
Это две крайности
yopp
Документные хранилища позволяют использовать не только две крайности, но и оптимизировать данные смешивая оба подхода
 Vladimir
Нормализация делает запись дешевле, но мы платим за пересечение между несколькими источниками данных при чтении.
Денормализация делает запись очень дорогой, но при этом чтение становится дешевле, так как ничего не надо объединять
А разве записать в N источников не дороже, чем последовательно записать в один?
Не очень понял, почему нормализация делает запись дешевле?
Roman
А разве записать в N источников не дороже, чем последовательно записать в один?
Не очень понял, почему нормализация делает запись дешевле?
тоже не понял, если у нас поиск он будет быстрее по ключам они же индексированы нет разве?
Viktar
А разве записать в N источников не дороже, чем последовательно записать в один?
Не очень понял, почему нормализация делает запись дешевле?
Количество данных которое вы записываете - меньше.
Andrey
Дороже - это еще больше записанных данных
Roman
НУ мне кажется нормализация делает все дешевле и лучше, только кода больше
Roman
И сложность
yopp
А разве записать в N источников не дороже, чем последовательно записать в один?
Не очень понял, почему нормализация делает запись дешевле?
При нормальных формах вы пишите в один источник и мало. При денормализации в несколько и много
 Alexander
При нормальных формах вы пишите в один источник и мало. При денормализации в несколько и много
угу, нормальных форм несколько , а слово денормализация одно
 Владимир
А разве записать в N источников не дороже, чем последовательно записать в один?
Не очень понял, почему нормализация делает запись дешевле?
Например, у вас миллиард юзеров, и у некоторых есть адреса. При добавлении нового адреса вам надо сделать более быстрый инсерт в некрупную таблицу, без необходимости лочить большую
 Madi
Всем привет!
Сегодня случай странный был. Шардед кластер монги, после года исправной работы вдруг перестал подключаться через раутер, версия 4.2.2, просто таймаутится подключение.
Сами сервера с шардами работают, конфиг сервера тоже, к ним можно подключится, с сетью проблем нет.
Обновил версию раутера и конфиг сервера до 4.2.11 и все заработало
Точно такое же было ровно год назад, обновление исправило проблему.
Кто знает, это запланировано так что-ли?