 yopp


Второй момент что производительность древовидных индексов не константная и будет O(log n)
 Viktar
Я в mongoDB новичок, а сколько индексов должно быть?
Размер в кило, мегабайтах. У вас есть индексы в гигабайт, а есть в 4 килобайта
 Дара
Размер в кило, мегабайтах. У вас есть индексы в гигабайт, а есть в 4 килобайта
Ясно. Стандарт это килобайт или мегабайты
Viktar
 Viktor
Если есть как-то-то поле которое уникально идентифицирует документ, то по нему сделать уникальный индекс и пропускать duplicate key исключение
Да, есть такое поле. Индекс я могу настроить только подключаясь к монге например через студию или можно из кода ?
Дара
Viktor
Используйте bulk операции. Вставлять и апдейтить сразу пачку
Парсинг каждого документа в разных потоках происходит
Viktor
Второй момент что производительность древовидных индексов не константная и будет O(log n)
Ну это точно приятней чем линейно
yopp
 Viktar
Парсинг каждого документа в разных потоках происходит
Ничего страшного. Это реально написать. У меня на проекте есть самописный многопоточный обработчик на питоне. Думаю и вы сможете, что то похожее найти, написать
yopp
Viktor
Спасибо. Пойду гуглить )))
Viktar
Ясно. Стандарт это килобайт или мегабайты
В вашем случае, последние два индекса должны быть не меньше 800 МБ
 Pan
 Pan
 Pan
 Pan
 Дара
 Bogdan
yopp
yopp
По этому и такой размер
yopp
yopp
Если у вас не 4.4, то придётся подождать
yopp
Потом уже удалить
Pan
Alexey
Добрый день!
Есть такая структура документа:
{
"_id": {
"$oid": "5f19ff0ac695314d3b39a579"
},
"workers": {
"5f589dc04e2da1d14cb713db": {
"is_test": false,
},
"5f73196021c61fb9934283c9": {
"is_test": true,
},
"5f3bcb74abb7654d6aff8753": {
"is_test": false,
},
},
}
нужно в каждый workers добавить новое поле is_test со значением false.
Чтоб на выходе стало так:
{
"_id": {
"$oid": "5f19ff0ac695314d3b39a579"
},
"workers": {
"5f589dc04e2da1d14cb713db": {
"is_test": false,
"is_blocked": false,
},
"5f73196021c61fb9934283c9": {
"is_test": true,
"is_blocked": false,
},
"5f3bcb74abb7654d6aff8753": {
"is_test": false,
"is_blocked": false,
},
},
}
перерыл всю доку. Как с массивом вложенных документов понял как сделать. Но тут mapping. по сути это object у которого каждый филд это oid и его значение документ.
как бы это в один запрос сделать? ибо этих workers там много.
Kenan
Добрый день!
Есть такая структура документа:
{
"_id": {
"$oid": "5f19ff0ac695314d3b39a579"
},
"workers": {
"5f589dc04e2da1d14cb713db": {
"is_test": false,
},
"5f73196021c61fb9934283c9": {
"is_test": true,
},
"5f3bcb74abb7654d6aff8753": {
"is_test": false,
},
},
}
нужно в каждый workers добавить новое поле is_test со значением false.
Чтоб на выходе стало так:
{
"_id": {
"$oid": "5f19ff0ac695314d3b39a579"
},
"workers": {
"5f589dc04e2da1d14cb713db": {
"is_test": false,
"is_blocked": false,
},
"5f73196021c61fb9934283c9": {
"is_test": true,
"is_blocked": false,
},
"5f3bcb74abb7654d6aff8753": {
"is_test": false,
"is_blocked": false,
},
},
}
перерыл всю доку. Как с массивом вложенных документов понял как сделать. Но тут mapping. по сути это object у которого каждый филд это oid и его значение документ.
как бы это в один запрос сделать? ибо этих workers там много.
думаю стоило бы workers сделать массивом из ObjectID, а вот уже данные состояния вынести в коллекцию юзера, но как я понял - сейчас менять структуру нельзя :)
Alexey
думаю стоило бы workers сделать массивом из ObjectID, а вот уже данные состояния вынести в коллекцию юзера, но как я понял - сейчас менять структуру нельзя :)
именно так. Что досталось, с тем и приходится работать) Я б тож сам так делать не стал
.
 Igor
Всем привет, кто может помочь написать два запроса, звучат так:
1) код неисправности «Туго поворачивается пробка крана плиты» и коды заявки c ней, выполненных позднее января 2016
2) количество дней, затраченное на выполнение заявок с номерами меньше 12
Скрипт самой базы могу в лс кинуть
yopp
Добрый день!
Есть такая структура документа:
{
"_id": {
"$oid": "5f19ff0ac695314d3b39a579"
},
"workers": {
"5f589dc04e2da1d14cb713db": {
"is_test": false,
},
"5f73196021c61fb9934283c9": {
"is_test": true,
},
"5f3bcb74abb7654d6aff8753": {
"is_test": false,
},
},
}
нужно в каждый workers добавить новое поле is_test со значением false.
Чтоб на выходе стало так:
{
"_id": {
"$oid": "5f19ff0ac695314d3b39a579"
},
"workers": {
"5f589dc04e2da1d14cb713db": {
"is_test": false,
"is_blocked": false,
},
"5f73196021c61fb9934283c9": {
"is_test": true,
"is_blocked": false,
},
"5f3bcb74abb7654d6aff8753": {
"is_test": false,
"is_blocked": false,
},
},
}
перерыл всю доку. Как с массивом вложенных документов понял как сделать. Но тут mapping. по сути это object у которого каждый филд это oid и его значение документ.
как бы это в один запрос сделать? ибо этих workers там много.
https://docs.mongodb.com/manual/tutorial/update-documents-with-aggregation-pipeline/
+
https://docs.mongodb.com/manual/reference/operator/aggregation/objectToArray/
+
https://docs.mongodb.com/manual/reference/operator/aggregation/map/
+
https://docs.mongodb.com/manual/reference/operator/aggregation/arrayToObject/
Anonymous
Всем привет, не могу добавить в массив вложенный (если не в profile, то все гуд
update_one({'user_id': invited}, {'$push': {'profile': {'referals': referal}}})
Дара
Доброе утро всем!
Какой оператор используется чтобы конвертировать вот этот документ
"_id":"ObjectId(""5f55a43aaa4db6d912489998"")",
"TargetRatios":{
"_id":"ObjectId(""5f571e3db956b1285449c4ec"")",
"recordType":"NodeMetaData",
"NodeId":1006,
"WeekBeginOn":"Monday",
"EntryZoneIDs":[
1,
9
],
"ExitZoneIDs":[
2,
10
],
"TargetRatio":1.75
}
в этот:
"_id":"ObjectId(""5f571e3db956b1285449c4ec"")",
"recordType":"NodeMetaData",
"NodeId":1006,
"WeekBeginOn":"Monday",
"EntryZoneIDs":[
1,
9
],
"ExitZoneIDs":[
2,
10
],
"TargetRatio":1.75
 Vladimir
Доброго дня.
Уже недельку ищу решение проблемы медленного курсора, и чего то не возьму в толк. Есть у меня коллекция на 500к элементов, хочу из нее вытащить 25-40к записей, и отдать их на клиента.
Стенд - репликасет (1 master 2 replica) 4.4.2 в докере на одном хосте.
Запрос банален
testmodel.find({
"resourceType": "virtualMachine"
})
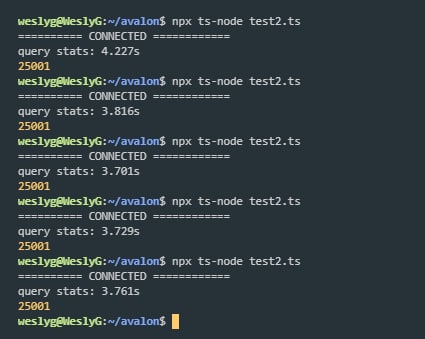
Пробовал монгусом, и стандартным mongodb в nodejs разница на уровне погрешности. Результат запроса удручающий, 3-5 секунд.
Понимаю, что все тупит, именно из за сетевых задержек, т.к разворачивая в docker-compose на локальной машине точно такой же конфиг время работы = 250ms стабильно.
Попробовал tcpdump пить трафик с хостов на себя и смотреть ответы, вижу что ответы летят пачками по 10-12 записей (движения курсора?)
Вопрос.
Разве это не нормально, хотеть вытащить из базы 25к элементов? Я много хочу? Монга так не работает?
У меня явное ощущение, что я чего то в розетку не включил, и оно просто не работает.
Пробовал строить индексы по этому полю, реиндексить, и тд. эффекта 0.
Пытался крутить batchSize до 100 в нативном клиенте эффекта не заметил (tcpdump показывает все те же 10-12 записей)
Крутил коннекшен пул, тоже без результата.
Документы мелкие, 5 полей, тестом рандомом наполнил, выглядят вот так.
{
"_id" : ObjectId("5fe256cff6accd21a13e9155"),
"team" : "7LWNfcrf",
"resourceName" : "mk5CU5BdmfHtuUA8KRU22CfrMzIkRSJ09yPl",
"resourceType" : "virtualMachine",
"storeSize" : 3599942,
"reportId" : "c510f214-79de-4e12-b725-2af120a50003",
"__v" : 0
}
Находил пару вопросов по перформансу cursor в интернете, но также без ответов и рекомендаций.
https://dba.stackexchange.com/questions/193708/aggregation-vs-cursor-for-reshaping-mongodb-documents
https://forums.meteor.com/t/iterating-over-mongo-cursor-too-slow-server-side/19531/10
https://stackoverflow.com/questions/31357025/mongodb-cursor-iteration-performance-issue
Офицальные гайды по оптимизации запросов молчат на эту тему.
Может кто сталкивался, подскажет куда копать. Или я может чего не так делаю?
Vladimir
А какой итоговый размер джсона, который вы получаете через 3-5 секунд?
5.5 мб на клиента улетает (25к записей)
Vladimir
Покажите пожалуйста explain({executionStats:1}) для вашего запроса
Вот
executionStats: {
executionSuccess: true,
nReturned: 25001,
executionTimeMillis: 37,
totalKeysExamined: 0,
totalDocsExamined: 75003,
executionStages: {
stage: 'COLLSCAN',
filter: [Object],
nReturned: 25001,
executionTimeMillisEstimate: 3,
works: 75005,
advanced: 25001,
needTime: 50003,
needYield: 0,
saveState: 75,
restoreState: 75,
isEOF: 1,
direction: 'forward',
docsExamined: 75003
},
allPlansExecution: []
},
Дара
Вот
executionStats: {
executionSuccess: true,
nReturned: 25001,
executionTimeMillis: 37,
totalKeysExamined: 0,
totalDocsExamined: 75003,
executionStages: {
stage: 'COLLSCAN',
filter: [Object],
nReturned: 25001,
executionTimeMillisEstimate: 3,
works: 75005,
advanced: 25001,
needTime: 50003,
needYield: 0,
saveState: 75,
restoreState: 75,
isEOF: 1,
direction: 'forward',
docsExamined: 75003
},
allPlansExecution: []
},
Если я не ошибаюсь то тут nReturned = totalDocsExamined должен быть. если не равно, то означает что индекс построин не правильно или же его вообще нету.
Vladimir
Если я не ошибаюсь то тут nReturned = totalDocsExamined должен быть. если не равно, то означает что индекс построин не правильно или же его вообще нету.
 Vladimir
Если я не ошибаюсь то тут nReturned = totalDocsExamined должен быть. если не равно, то означает что индекс построин не правильно или же его вообще нету.
Вот теперь explain
executionStats: {
executionSuccess: true,
nReturned: 25001,
executionTimeMillis: 30,
totalKeysExamined: 25001,
totalDocsExamined: 25001,
executionStages: {
stage: 'FETCH',
nReturned: 25001,
executionTimeMillisEstimate: 5,
works: 25002,
advanced: 25001,
needTime: 0,
needYield: 0,
saveState: 25,
restoreState: 25,
isEOF: 1,
docsExamined: 25001,
alreadyHasObj: 0,
inputStage: [Object]
},
allPlansExecution: []
},
Дара
понял)
Дара
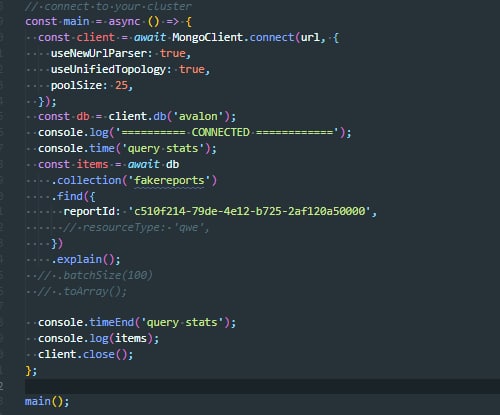
Можете код показать как вы селектите данные?
Vladimir
 yopp
Вот
executionStats: {
executionSuccess: true,
nReturned: 25001,
executionTimeMillis: 37,
totalKeysExamined: 0,
totalDocsExamined: 75003,
executionStages: {
stage: 'COLLSCAN',
filter: [Object],
nReturned: 25001,
executionTimeMillisEstimate: 3,
works: 75005,
advanced: 25001,
needTime: 50003,
needYield: 0,
saveState: 75,
restoreState: 75,
isEOF: 1,
direction: 'forward',
docsExamined: 75003
},
allPlansExecution: []
},
Вы говорите что у вас коллекция на 500 тысяч документов, но в статистике планировщика: docsExamined: 75003
yopp
У вас точно одинаковые объёмы данных на всех стендах?
Vladimir
У вас точно одинаковые объёмы данных на всех стендах?
Да, сносил на тесте, но как я говорил, это тоже не влияет на запрос.
Вот Explain с 500+ к
executionStats: {
executionSuccess: true,
nReturned: 25001,
executionTimeMillis: 30,
totalKeysExamined: 25001,
totalDocsExamined: 25001,
executionStages: {
stage: 'FETCH',
nReturned: 25001,
executionTimeMillisEstimate: 3,
works: 25002,
advanced: 25001,
needTime: 0,
needYield: 0,
saveState: 25,
restoreState: 25,
isEOF: 1,
docsExamined: 25001,
alreadyHasObj: 0,
inputStage: [Object]
},
allPlansExecution: []
},
yopp
Так, хорошо, теперь видно что монга достаёт из хранилища 25 тысяч документов за 30 мс.
Это на локальном или на удалённом кластере?
Vladimir
Так, хорошо, теперь видно что монга достаёт из хранилища 25 тысяч документов за 30 мс.
Это на локальном или на удалённом кластере?
На удаленном.
Локально стабильно 250-300мс find весь курсор пробегает.
yopp
Вы запускаете скрипт на удалённом сервере или скрипт исполняется локально, но подключается к удалённому серверу?
Vladimir
Вы запускаете скрипт на удалённом сервере или скрипт исполняется локально, но подключается к удалённому серверу?
локально, но подключается к удаленному.
Собственно как и работает приложение. Сервер с приложением отдельно, сервер с базой отдельно.
Все в рамках одной внутренней сети, никакого хождения через внешние интернеты, никаких облаков.
yopp
локально, но подключается к удаленному.
Собственно как и работает приложение. Сервер с приложением отдельно, сервер с базой отдельно.
Все в рамках одной внутренней сети, никакого хождения через внешние интернеты, никаких облаков.
Если есть возможность, выполните этот скрипт на сервер с монгой. Если такой возможности нет, то сделайте time mongodump --query=… с вашим запросом
Vladimir
Если есть возможность, выполните этот скрипт на сервер с монгой. Если такой возможности нет, то сделайте time mongodump --query=… с вашим запросом
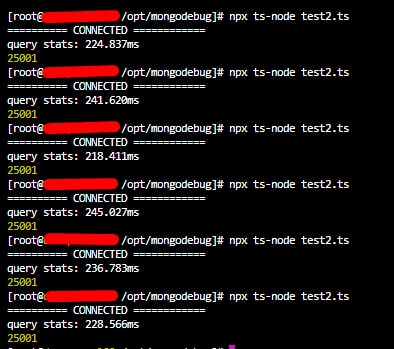 Vladimir
думал что сеть кривая, пробовал взять на атласе, бесплатную монгу, результаты те же.
yopp
думал что сеть кривая, пробовал взять на атласе, бесплатную монгу, результаты те же.
А попробуйте пожалуйста сделать на вашем сервере дамп с —query, найти в нём .bson файл и после этого скачать этот файл по scp/sftp и замерить время
Vladimir
А попробуйте пожалуйста сделать на вашем сервере дамп с —query, найти в нём .bson файл и после этого скачать этот файл по scp/sftp и замерить время
А как сделать дамп с query? (пока не силен, знаю только mongodump но он вроде для бекапов)
yopp
А как сделать дамп с query? (пока не силен, знаю только mongodump но он вроде для бекапов)
https://docs.mongodb.com/database-tools/mongodump/#cmdoption-mongodump-query
Vladimir
https://docs.mongodb.com/database-tools/mongodump/#cmdoption-mongodump-query
4.8 мб файл получился.
Scp говорит вот что в verbose режиме.
Transferred: sent 4484, received 4956336 bytes, in 3.2 seconds
Линуксовый тайм тоже самое.
real 0m3.699s
user 0m0.095s
sys 0m0.083s
Похоже на то, что 5мб по сети, действительно летает за 3 секунды....
Vladimir
https://docs.mongodb.com/database-tools/mongodump/#cmdoption-mongodump-query
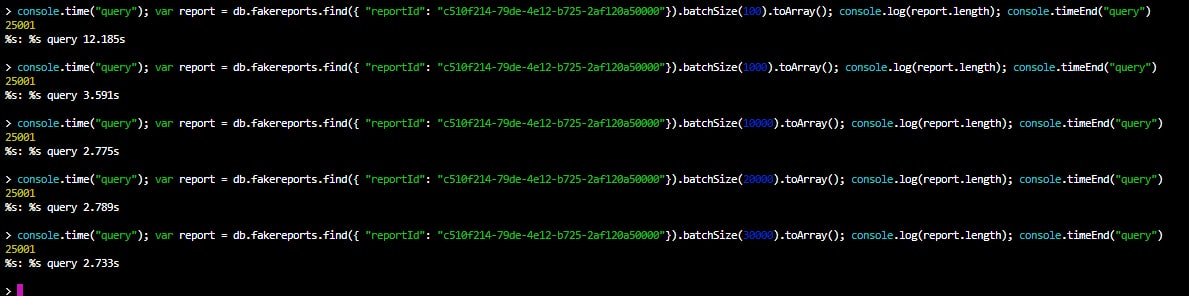 yopp
скорее всего ваше сетевое соединение ограничено этой полосой
Максим
Vladimir
Все так.
[ 3] local 192.168.1.1 port 59762 connected with 10.0.0.88 port 5001
[ ID] Interval Transfer Bandwidth
[ 3] 0.0000-10.0468 sec 19.1 MBytes 16.0 Mbits/sec
Vladimir
 Vladimir
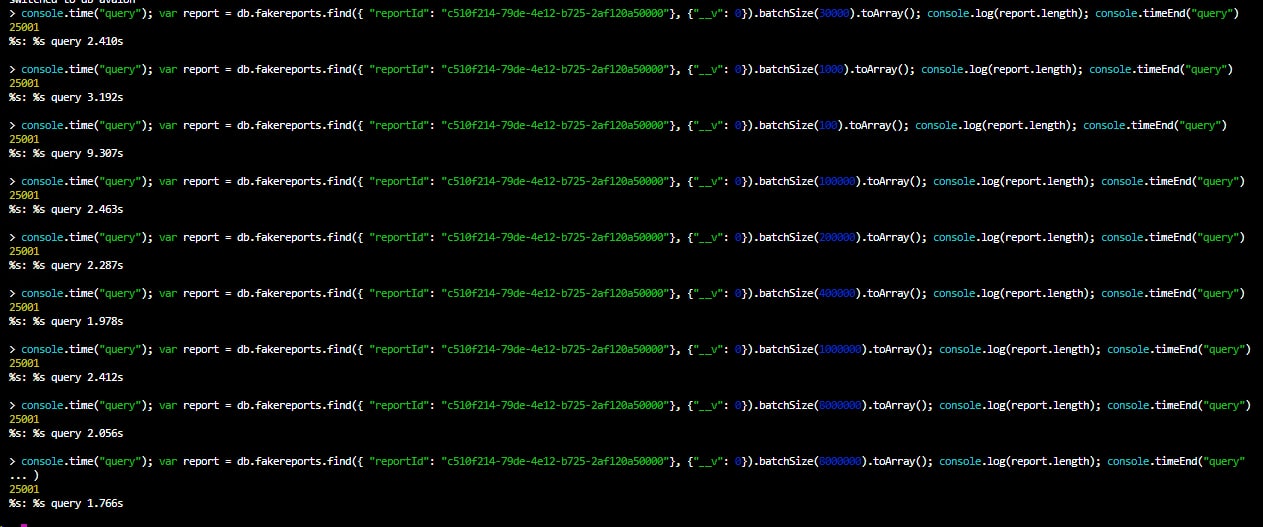
А в js коде, по прежнему 3 секунды.
Видимо правда, все дело в пачке, надо ток разобраться, как прокинуть ее в драйвер
 Denis
А как можно написать запрос типа такого?
На ум приходит только такое решение, нужно для нескольких полей сохранять флаги о наличии этого поля, хотел как то сделать одним запросом чтобы избежать гонок
db.coll.updateOne({
some: ‘one’
}, {
$set: {
email: ‘abc’
hasEmail: { // after update, true/false
$email: {
$ne: null
}
}
}
})
Vladimir
Я выставил batchSIze в 80к, и с сетевкой в пару гигабит, это 200ms)
Теперь все на своих местах, и работает как положено!
Спасибо вам огромное!!
@titiaiev @dd_bb @daara9
Дара
Я выставил batchSIze в 80к, и с сетевкой в пару гигабит, это 200ms)
Теперь все на своих местах, и работает как положено!
Спасибо вам огромное!!
@titiaiev @dd_bb @daara9
Выходит проблема была в пропускной способности канала?
yopp
yopp
Наблюдаемые вами эффекты слабо связаны с тем как работает монга и скорее всего связаны с пропускной способностью сети между узлами
yopp
У большого BatchSize есть обратный эффект. Так как вашему клиенту будет приезжать огромный кусок ответа, который будет необходимо буфферизировать, то вы создадите новое бутылочное горлышко в месте обработки ответа, в первую очередь на уровне драйвера
yopp
Особенно если драйвер для вас сразу десериализует ответ
yopp
Второй момент: бенчмарки по одной точке дают очень очень плохие данные. Для понимания реальной картины, лучше использовать сотни итераций, посчитать min/max/avg/mid/stdev
yopp
Это позволит вам увидеть насколько много шума в измерениях
yopp
Плюс высокий stdev будет говорить о нестабильности условий вашего бенчмарка, что будет ставить под сомнение его результат
Vladimir
Как я понимаю, это баланс сеть или (оперативка + cpu)
И раз это дает такой эффект на сеть для меня, то в угоду перформанса, можно покрутить этот баланс в сторону оперативки.
Теперь хотя бы понятно куда в случае чего копать,
Это обычно имеет эффект при большом числе очень маленьких документов
Вот именно это мой случай.
Но впредь буду смотреть на сетевое соединение, прежде чем ругать базу)