 Yura


Если без init sync то только, как это называется, через физический бэкап. Останавливаете source ноду и делаете копирование дататопа на новый хост, потом rs.add() на сорсе и все
Yura
Еще учитывайте что при таком способе, для снятия консистентной копии нужно остановить или монгу на праймари, или запись в вашем сервисе, на все время бэкапа и рестора. А 4Тб данных копируются не быстро. Если такой длительный downtime невозможен для вас, то тогда только через репликацию
 Сергей
Добрый день! Ситуация такая: кластер из 3 нод (1 мастер и 2 слейва). Необходимо отключить 1 слейв. Подскажите, пожалуйста, если отключу 1 слейв, кластер продолжит работать, я правильно понимаю? Когда запущу выключенный слейв, он автоматически подключится к кластеру или надо будет что-то набирать в консоли?
Yura
Добрый день! Ситуация такая: кластер из 3 нод (1 мастер и 2 слейва). Необходимо отключить 1 слейв. Подскажите, пожалуйста, если отключу 1 слейв, кластер продолжит работать, я правильно понимаю? Когда запущу выключенный слейв, он автоматически подключится к кластеру или надо будет что-то набирать в консоли?
Добрый день, как вы собираетесь отключать слейв, через остановку сервиса монги на нем или через rs.remove() ?
Сергей
Добрый день, как вы собираетесь отключать слейв, через остановку сервиса монги на нем или через rs.remove() ?
Добрый день! Через остановку сервиса
Yura
Добрый день! Через остановку сервиса
Тогда кластер продолжит работать и после запуска подключится автоматически. Единственное: проверьте величину вашего oplog (количество часов которое он покрывает), если остановка слейва будет длительной и выйдет за рамки оплога - получите статус recovering после его запуска.
Сергей
Тогда кластер продолжит работать и после запуска подключится автоматически. Единственное: проверьте величину вашего oplog (количество часов которое он покрывает), если остановка слейва будет длительной и выйдет за рамки оплога - получите статус recovering после его запуска.
Понял, спасибо вам большое. Предполагается максимум на пару минут
 М.А
Всем привет,
Подскажите есть ли тип интекса TEXT для понотекстового поиска в Atlas ?
Просто доки все время говорят (non-Atlas) а вроде другое говорит что можно ставить там
 Nick
М.А
Привет,
Я попробовал Атлас Серч, он почему то медленно работает (
У меня есть строковое поле ActionId у которого атомарные значения , типа "acb123"
Я хотел сделать поиск по частичном совпадению, типа если в поиск вбить b12 то он найдёт совпадение
Я пробовал fuzzy, wildcard, nGram токенизацию - не работают быстро как хотелось
Если я просто делаю сканирование режексом ActionId: /b12/i - работает на такой же скорости как и атлас серч индекс
Может кто сталкивался с таким, как быть, подскажите плз
М.А
Правда документов для тестирования думаю чуть мало в коллекции, там где то 600 - 800 тысяч
Но и с таким количеством прямой поиск без индексов работает примерно так же как и через атлас серч
М.А
Что такое быстро? И зачем быстрее?
Поиск с Атлас Серчом иногда идет более 20ти секунд
А этот поиск через апи запрос, поиск по БД
Там максимум 3 секунды думаю допустимо, ну то есть пользователю будет дальше уже неудобно ждать
Nick
Поиск с Атлас Серчом иногда идет более 20ти секунд
А этот поиск через апи запрос, поиск по БД
Там максимум 3 секунды думаю допустимо, ну то есть пользователю будет дальше уже неудобно ждать
показывайте как делаете выборку и сколько документов подпадает под выборку?
М.А
показывайте как делаете выборку и сколько документов подпадает под выборку?
Окей, спасибо
Соберу все детали / метрики скину подробней скоро
М.А
Окей, вот обычный поиск с реджексом
Возвращает 2647 документов
db.getCollection("LocalConnectorLogCollection").aggregate([
{ $match: { KeyValue: /248/i } },
])
Время выполнения: 11.9 секунд
А вот через атлас серч. Столько же документов возвращает
Время выполнения 12 секунд
db.getCollection("LocalConnectorLogCollection").aggregate([
{
$search: {
index: "connectorlog_keyvalue_si",
wildcard: {
query: "*248*",
path: "KeyValue",
allowAnalyzedField: true
}
}
},
])
Конфиг вот такой
{
"mappings": {
"dynamic": false,
"fields": {
"KeyValue": {
"analyzer": "keywordLowercase",
"searchAnalyzer": "keywordLowercase",
"type": "string"
}
}
},
"analyzers": [
{
"charFilters": [],
"name": "keywordLowercase",
"tokenFilters": [
{
"type": "lowercase"
}
],
"tokenizer": {
"type": "keyword"
}
}
]
}
М.А
Есть какие идеи 🥲 ?
М.А
Я пробовал ещё nGramm токенизацию, он вроде быстрый но работает не очень
Типа, 1398 находит совпадения а по 139 нет, хотя я и указывал minToken как 3,
Либо я не очень понял как это работает и для каких случаев
 Алексей
Добрый день! Подскажите, кто знает, пожалуйста: mongosh клиент добавляет в вывод prompt, —quiet не помогает. Как убрать? например, делаю echo 'show tables' | mongosh —quiet logs, он выдает: logs> db1\ndb2\n... \n logs> 🤦♂️
Nick
Добрый день! Подскажите, кто знает, пожалуйста: mongosh клиент добавляет в вывод prompt, —quiet не помогает. Как убрать? например, делаю echo 'show tables' | mongosh —quiet logs, он выдает: logs> db1\ndb2\n... \n logs> 🤦♂️
либо через --eval передать js код строкой, либо через `--file`файл с js кодом.
https://www.mongodb.com/docs/mongodb-shell/reference/options/#std-option-mongosh.--eval
Алексей
либо через --eval передать js код строкой, либо через `--file`файл с js кодом.
https://www.mongodb.com/docs/mongodb-shell/reference/options/#std-option-mongosh.--eval
—eval не подходит, —file норм.. show tables там нет но мне и не нужно. Спасибо!
 CyberOps
Всем привет, кто нибудь настраивал в mongo OIDC ?? Кто бы мог подсказать пару моментов
 Fops
 Fops
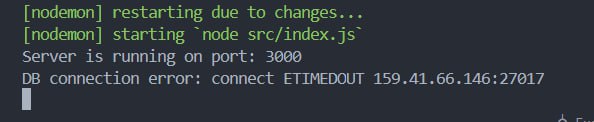
Подключается 1 раз из 10 примерно, в остальные разы истекает время
 Usmon
 Sanity = nil
Здравствуйте, пытаюсь анализировать запросы с помощью db.collection.find().explain(), в доке пишут что план не кешируется, но почему-то если я запускаю первый раз explain на определенную квери, даёт 9.985 executionTimeMillisEstimate, если запускаю ещё раз, даёт уже 0.048. Неужто кеширует не квери план а результат запроса?
Sanity = nil
прогретый запрос
Да планирование одинаковое время у запросов, а выполнение намного быстрее, сразу понял что какое-то кеширвание играет роль. А как тогда анализировать запрос, нету возможности отключить какие-либо кеширования с эксплейном?
 Anton K.
Здравствуйте, пытаюсь анализировать запросы с помощью db.collection.find().explain(), в доке пишут что план не кешируется, но почему-то если я запускаю первый раз explain на определенную квери, даёт 9.985 executionTimeMillisEstimate, если запускаю ещё раз, даёт уже 0.048. Неужто кеширует не квери план а результат запроса?
глянь лучше как по доке это делается
и все встанет на свои места
 yopp
Здравствуйте, пытаюсь анализировать запросы с помощью db.collection.find().explain(), в доке пишут что план не кешируется, но почему-то если я запускаю первый раз explain на определенную квери, даёт 9.985 executionTimeMillisEstimate, если запускаю ещё раз, даёт уже 0.048. Неужто кеширует не квери план а результат запроса?
Здравствуйте!
Тут участвуют разные механизмы:
1) выбор плана: по шейпу запроса выбираются планы-кандидаты. Для каждого кандидата планировщик делает «тестовые» запросы, результаты взвешиваются и выбирается победитель.
После чего победитель сохраняется в кэше планов и дальше при совпадении шейпа запроса план берётся из кэша, без повторного тестирования.
Посмотреть можно вот тут: https://www.mongodb.com/docs/manual/reference/method/js-plan-cache/
По этому первый запрос когда план еще не составлялся (монга только была запущена или кэш был сброшен), время выполнения запроса существенно больше из-за происходящего анализа кандидатов
2) При выполнении запроса есть несколько вариантов: данные попадающие под выборку находятся на диске, в файловом кэше ОС или в кэше монги. Соотвественно первый запрос в который попадают данные будет читаться с диска, попадать в дисковый кэш и или быть в кэше запросов внутри монги. Это самый долги по времени путь.
Как следствие если сделать запрос с теми же условиями повторно, данные уже будут в кэше монги и это самый быстрый путь
Когда кэш монги переполнится, начнётся процесс вытеснения закешированных данных (page eviction). Но кэш ОС независим от кэша монги, по этому данные могут остаться в нем. Разница между ними в том, что в кэше монги данные хранятся как есть, а вот при сбросе на диск они сжимаются выбранным алгоритмом. Как следствие в кэше ОС данные хранятся более компактно. Но чтение назад в кэш требует декомпрессии что условно медленнее чем чтение напрямую из кэша монги
3) explain использует для estimatedMillis результат оценки планировщика. Эта оценка не всегда точная, так как была получена в п.1 и может существенно отличаться по разным причинам. Есть ситуации когда после «прогрева» монги, сброс кеша планов может помочь планировщику выбрать более эффективную стратегию
Sanity = nil
Anton K.
Sanity = nil
а ты сравни свой код с тем что в доке
Тоже самое.
In mongosh, this command can also be run through the db.collection.explain() and cursor.explain() helper methods.
yopp
https://www.mongodb.com/docs/manual/reference/command/explain/
Спасибо за объяснение, примерно так и представлял, просто тут в доке пишут что не помещает выигравший план в кеш и не достает их оттуда.
Да, действительной. Значит я неправильно запомнил что в executionStats планы оцениваются по новой, спасибо!
Sanity = nil
.
https://www.mongodb.com/docs/manual/reference/method/cursor.explain/#mongodb-method-cursor.explain
Sanity = nil
Да, действительной. Значит я неправильно запомнил что в executionStats планы оцениваются по новой, спасибо!
Может ли быть проблема в том что используется DocumentDB с версией монго 5.0? Вообще какая-то ужасная вещь, даже шардинг не поддерживает, такое ощущение что там не только это выпилено/урезано.
yopp
.
Пожалуйста, не общайтесь в таком формате. Если вы знаете ответ, ответьте развернуто.
У нас профессиональное сообщество. Относитесь к участникам с уважением.
Здесь не принято посылать в «в Гугл» или «почитать документацию» без ссылки на релевантную статью или конкретных рекомендаций.
yopp
Может ли быть проблема в том что используется DocumentDB с версией монго 5.0? Вообще какая-то ужасная вещь, даже шардинг не поддерживает, такое ощущение что там не только это выпилено/урезано.
DocumentDB другая база данных, которая работает иначе чем MongoDb. У них общего только API запросов
Sanity = nil
DocumentDB другая база данных, которая работает иначе чем MongoDb. У них общего только API запросов
Ужас какой... Эх спасибо, попробую их доку читать.
yopp
.
Оба этих запроса приведут к одному и тому же результату, так как выполнят одну и ту же команду explain: https://www.mongodb.com/docs/manual/reference/command/explain/
В случае с find() в mongosh возвращается объект связанный с курсором, который «лениво» выполняется. Как следствие на нем можно вызвать метод explain(). Под капотом все одно и тоже, не зависимо откуда был вызван метод
yopp
Ужас какой... Эх спасибо, попробую их доку читать.
Если у вас есть возможность использовать монгу, а не documentdb, это самый оптимальный вариант. Так как внутри там все иначе устроено и очень многие вещи между монгой и documentdb в итоге, ожидаемо, не совпадают
Sanity = nil
Да к сожалению используется авс для всей инфраструктуры, да и данных уже очень много там, так что увы, слишком дорого стоит будет переезд.
Anton K.
Оба этих запроса приведут к одному и тому же результату, так как выполнят одну и ту же команду explain: https://www.mongodb.com/docs/manual/reference/command/explain/
В случае с find() в mongosh возвращается объект связанный с курсором, который «лениво» выполняется. Как следствие на нем можно вызвать метод explain(). Под капотом все одно и тоже, не зависимо откуда был вызван метод
да все так
хотя со стороны выглядело иначе, my bad
чтобы запрос не выполнялся надо вызывать explain с опцией "queryPlanner"
Sanity = nil
Здравствуйте, у монги есть альтернатива типа книга как Postgres Internals для постгреса?
Владимир Т
здравствуйте, подскажите какую ОС нынче модно юзать под mongodb? Есть mongodb 3.6, намечается ее переезд. CentOS я так понял уже не вариант, а RHEL8-9 просит лицензию.
 Нуриддин
Владимир Т
Кстати да, хотел спросить про oracle linux
Владимир Т
На него нормально поставится?
Нуриддин
Или rocky но там репы немного запарно добавлять, так как там сухая необходимость
Нуриддин
На него нормально поставится?
Ну у меня в опыте проблем почти не было, только там по дефолту файервал включён иногда забываешься открыть порты
Владимир Т
Или rocky но там репы немного запарно добавлять, так как там сухая необходимость
роки отзывы посмотрел, чтото не хвалят
Нуриддин
Прикольная
Владимир Т
Ну у меня в опыте проблем почти не было, только там по дефолту файервал включён иногда забываешься открыть порты
ну оракл линукс мне давно знаком, наверно всетаки на нем стоит остановиться?
Нуриддин
? Чего ?
Нуриддин
роки отзывы посмотрел, чтото не хвалят
Говорю же есть немного проблематичный опыт в настройках репы, и всё по дефолту как оракл
Нуриддин
Остальное вообще не видел каких-то отличий
Нуриддин
а что бы вы выбрали роки или оракл линукс?
Вообще разницы не вижу, ответь на вопрос сколько раз будешь её переустанавливать, если больше раза - пишешь ансибл просто с учётом особенностей и раскат автоматизируется)
Владимир Т
Владимир Т
какая разница, если запускать в докере?
Нет, на виртуалке. Хочу со старого сервера перекинуть бд на новый. При этом в новую версию монго и ос. Бд гдето 3.5 тб
Nick
Нет, на виртуалке. Хочу со старого сервера перекинуть бд на новый. При этом в новую версию монго и ос. Бд гдето 3.5 тб
тогда стоит остановиться на том что лучше знаете и что есть в https://www.mongodb.com/docs/manual/administration/production-notes/#recommended-platforms
там выше будет матрица совместимости по разным версиям
El
Кто-то смог поставить Mongo на локальном компе с Fedora 42 ?
Nick
Кто-то смог поставить Mongo на локальном компе с Fedora 42 ?
вот буквально предыдущее сообщение https://t.me/mongodb_ru/140476 про совместимость.
В любом случае для локали просто используйте докер и не мучайтесь
 Иван
#вопрос нужно поменять тип поля во всех документах с Object
startDate
Object
year
2023
month
8
day
1
на Date, использую mongodb.driver c# на стороне сервера(не клиента), как можно это сделать?
Nick
Иван
Там 60 млн документов, хочется ускорить
Nick
альтернатив такто нет. Есть только подварианты вида сделать апдейты на создание нового поля с нужным типом и когда все отработает переклчюиться на него
Иван
нашёл некоторый eval, не пойму на сколько она obsolete
Иван
но на стороне сервера?
Иван
тем самым невелируя походы по сети
Nick
апдейты все на стороне сервера выполняются)
Nick
альтернатив такто нет. Есть только подварианты вида сделать апдейты на создание нового поля с нужным типом и когда все отработает переклчюиться на него
@ipogonyshev вот как бы самый подходящий вариант
если надо прям то же самое поле, то потом доп апдейт на проставление значения из нового поля в старое. Такто да апдейтнуть поле на которое ссылаешься не тривиально