Подскажите пожалуйста, почему при выполнении команды db.serverStatus().globalLock:
{
totalTime: Long('342384277000'),
currentQueue: { total: 0, readers: 0, writers: 0 },
activeClients: { total: 16, readers: 0, writers: 16 }
}
Для writers потолок всегда 16, вне зависимости от количества ядер на ВМ, или это количество зависит от другого параметра? И можно ли его регулировать? Версия монги 7.0.12
С чего вы взяли что это потолок?
globalLock.activeClients.writers
The number of active client connections performing write operations.
 Nick


 Yura
А больше значения я и не видел
Yura
При чем это значение совпадает с qrw при выполнении mongostat
Yura
С чего вы взяли что это потолок?
globalLock.activeClients.writers
The number of active client connections performing write operations.
 yopp
Подскажите пожалуйста, почему при выполнении команды db.serverStatus().globalLock:
{
totalTime: Long('342384277000'),
currentQueue: { total: 0, readers: 0, writers: 0 },
activeClients: { total: 16, readers: 0, writers: 16 }
}
Для writers потолок всегда 16, вне зависимости от количества ядер на ВМ, или это количество зависит от другого параметра? И можно ли его регулировать? Версия монги 7.0.12
Здравствуйте! А какая у вас проблема и как она проявляется?
Yura
Здравствуйте! А какая у вас проблема и как она проявляется?
В общем 5 инстансов сервиса, на каждом запущено по одному потоку, в каждом потоке транзакция, каждая транзакция выполняет bulk+upsert на 1000 операций))
Т.е. 5 параллельных транзакций в параллель идут на праймари, при этом увеличивается значение writeConflicts постоянно. На секондари сразу же копится эта очередь из replWriteWorker`ов, на цпу растет показатель iowait, хотя диски здоровые и по показателям R\w и iops до потолка им ещё далеко. Так вот вопрос, может ли эта ситуация возникать из-за конфликта транзакций на фоне блокировок за объект в бд и секондари копит очередь из-за того что ждет (w: majority) когда эта блокировка разрешится на праймари? И второй вопрос почему эта очередь не может подняться больше 16?
Yura
Для справки: самые лучшие показатели по времени записи транзакций и отсутствию writeConflicts, а также отсутствию очереди были только тогда, когда запустили 1 инстанс с 5 потоками, где каждый поток содержал в себе транзакцию
Yura
А вообще всё изначально началось со статистика запросов:
"durationMillis":228
"waitForWriteConcernDurationMillis":227
где мы обнаружили что большую часть времени наши запросы ждут подтверждения от секондари
Nick
В общем 5 инстансов сервиса, на каждом запущено по одному потоку, в каждом потоке транзакция, каждая транзакция выполняет bulk+upsert на 1000 операций))
Т.е. 5 параллельных транзакций в параллель идут на праймари, при этом увеличивается значение writeConflicts постоянно. На секондари сразу же копится эта очередь из replWriteWorker`ов, на цпу растет показатель iowait, хотя диски здоровые и по показателям R\w и iops до потолка им ещё далеко. Так вот вопрос, может ли эта ситуация возникать из-за конфликта транзакций на фоне блокировок за объект в бд и секондари копит очередь из-за того что ждет (w: majority) когда эта блокировка разрешится на праймари? И второй вопрос почему эта очередь не может подняться больше 16?
прям транзакции? и вам надо либо чтобы все записалось либо ничего, и именно в пачках по 1к?
Nick
Да
а что за данные и суть сохрания в монгу? данные из кафки небось и надо коммит проставить после вставки?
Yura
Nick
всё верно
уберите транзакции, добавьте уникальный индекс для контроля вставки дублей и работайте на атомарных апсертах
Nick
в вашей картине с транзакциями всеравно гарантий нет
Yura
уберите транзакции, добавьте уникальный индекс для контроля вставки дублей и работайте на атомарных апсертах
Т.е. структуру с инстансами и потоками оставить те же, только bulk+upsert без транзакций?
yopp
В общем 5 инстансов сервиса, на каждом запущено по одному потоку, в каждом потоке транзакция, каждая транзакция выполняет bulk+upsert на 1000 операций))
Т.е. 5 параллельных транзакций в параллель идут на праймари, при этом увеличивается значение writeConflicts постоянно. На секондари сразу же копится эта очередь из replWriteWorker`ов, на цпу растет показатель iowait, хотя диски здоровые и по показателям R\w и iops до потолка им ещё далеко. Так вот вопрос, может ли эта ситуация возникать из-за конфликта транзакций на фоне блокировок за объект в бд и секондари копит очередь из-за того что ждет (w: majority) когда эта блокировка разрешится на праймари? И второй вопрос почему эта очередь не может подняться больше 16?
https://github.com/mongodb/mongo/blob/master/src/mongo/db/repl/README.md
здесь почти все ответы на ваши вопросы 🙂
по поводу 200мс, тут есть несколько факторов
1) физическое летенси между нодами: быстрее чем RTT не будет 🙂
2) j флаг и journalCommitInterval, по умолчанию это 200мс
https://github.com/mongodb/mongo/blob/master/src/mongo/db/repl/README.md#commit-point-propagation
Nick
Т.е. структуру с инстансами и потоками оставить те же, только bulk+upsert без транзакций?
да и надо будет накрутить только логику для дедупликации
yopp
если у вас идёт параллельный batch upsert и вы не можете гарантировать что каждый из батчей содержит уникальный набор документов — конфликты неизбежны
тут есть три опции:
* как выше сказали: не использовать транзакции
* уменьшить размер батча
* в пишущем клиенте формировать батчи таким образом, чтоб документы не пересекались
yopp
можно конечно с интервалом коммита поиграться, но это не решение проблемы, а симптоматическое лечение
Yura
если у вас идёт параллельный batch upsert и вы не можете гарантировать что каждый из батчей содержит уникальный набор документов — конфликты неизбежны
тут есть три опции:
* как выше сказали: не использовать транзакции
* уменьшить размер батча
* в пишущем клиенте формировать батчи таким образом, чтоб документы не пересекались
"как выше сказали: не использовать транзакции" - это попробуем
"уменьшить размер батча" - так делали, только увеличивалось время записи
"в пишущем клиенте формировать батчи таким образом, чтоб документы не пересекались" - над этим уже работаем чтобы инстансы писали в разные доки
Yura
Так рут коз получается всё же в конфликтах?
Yura
https://github.com/mongodb/mongo/blob/master/src/mongo/db/repl/README.md
здесь почти все ответы на ваши вопросы 🙂
по поводу 200мс, тут есть несколько факторов
1) физическое летенси между нодами: быстрее чем RTT не будет 🙂
2) j флаг и journalCommitInterval, по умолчанию это 200мс
https://github.com/mongodb/mongo/blob/master/src/mongo/db/repl/README.md#commit-point-propagation
200ms это я для примера сбросил, были и по 100 и по 5000
yopp
"как выше сказали: не использовать транзакции" - это попробуем
"уменьшить размер батча" - так делали, только увеличивалось время записи
"в пишущем клиенте формировать батчи таким образом, чтоб документы не пересекались" - над этим уже работаем чтобы инстансы писали в разные доки
я бы не сказал что тут есть какая-то проблема со стороны монги: всё работает как вы ей сказали 🙂
вы попросили «дай мне гарантию что 1000 операций либо применится, либо нет, гарантируя что слепок данных над которыми применяются операции не изменился и потом что эти операции никогда не откатятся»
т.е вы хотите самый высокий уровень гарантий целостности, это во всех хранилищах дорого и как следствие долго
и здесь вы сталкиваетесь с двумя эффектами:
1) upsert на 1к документов сам по себе повышает статистическую вероятностью что будет конфликт
2) таких вставок по 1к много и они параллельные
и в итоге такая вот картина
по опыту могу сказать что сделать консистентную синронизацию между разными хранилищами которая будет очень быстро работать — очень дорого 🙂
yopp
компромиссы тут неизбежны, по этому если от задержек на вставку нет каких-то реальных существенных проблем, проще всего смирится и подкрутить мониторинг чтоб он конкретно по этому вопросу вас не беспокоил
yopp
могу сразу сказать что дешево и быстро можно сделать только в одном случае: append only log. если вы можете поменять вашу структуру данных чтоб избежать upsert то вам и транзакции нужны не будут и batch insert хорошо оптимизирует вставки в последних версиях
Yura
Просто оно даже с ходу не понятно во что упираемся, увеличивали количество цпу и производительность ssd в 2 раза - ситуация не меняется вообще
Yura
Ну и конфигурация у нас просто RS, без шардирования
Yura
Кстати ещё момент, в документации написано что параметр totalTickets в db.serverStatus().wiredTiger.concurrentTransactions меняется динамически, но при увеличении конфигурации он у нас таким же и остался, пришлось крутить вручную
yopp
Кстати ещё момент, в документации написано что параметр totalTickets в db.serverStatus().wiredTiger.concurrentTransactions меняется динамически, но при увеличении конфигурации он у нас таким же и остался, пришлось крутить вручную
вы упираетесь в производительность координации распределенных транзакций
т.е проблема даже не в том сколько байт вы пишите, а в том какие гарантии записи вы хотите
вопрос тут насколько вам реально нужен majority, а он упирается в вопрос что случится с данными если случится роллбэк
если у вас данные переливаются в одну сторону и потом в монге они не меняются, то majority скорее всего и не нужен
Yura
А как быть с очередью из 16 ReplWriterWorker`ов на секондари? Что это вообще?)
yopp
А как быть с очередью из 16 ReplWriterWorker`ов на секондари? Что это вообще?)
https://github.com/mongodb/mongo/blob/0a68308f0d39a928ed551f285ba72ca560c38576/src/mongo/db/repl/oplog_applier.cpp#L178
это треды которые фактически пишут данные из оплога в хранилище
Yura
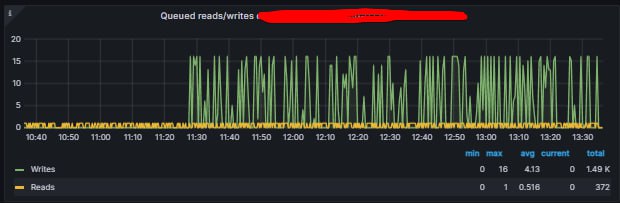
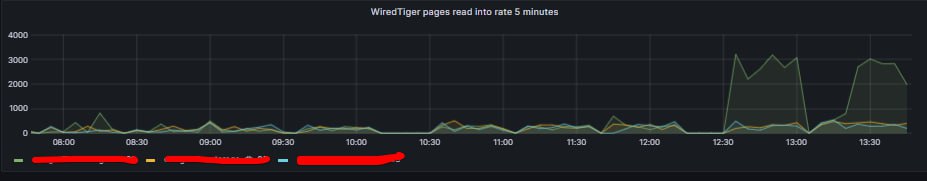
Логику работы сервиса пока не меняли, но вот ещё одно интересное наблюдение:
Очистили в коллекции часть данных и пока в ней было до ~40млн документов - всё обрабатывалось хорошо и быстро, видно было только что нагрузка на сервера медленно и постепенно растет с заполнением данными. А потом резко на 41млн+ начались проблемы, упала скорость обработки операций сильно и globalLock.activeClients.writers стали скакать с 5 до 40, и показатель PagesReadIntoCache на праймари поднялся с 200 до 3к, хотя со стороны сервиса не меняли ничего.
 Andrey
Логику работы сервиса пока не меняли, но вот ещё одно интересное наблюдение:
Очистили в коллекции часть данных и пока в ней было до ~40млн документов - всё обрабатывалось хорошо и быстро, видно было только что нагрузка на сервера медленно и постепенно растет с заполнением данными. А потом резко на 41млн+ начались проблемы, упала скорость обработки операций сильно и globalLock.activeClients.writers стали скакать с 5 до 40, и показатель PagesReadIntoCache на праймари поднялся с 200 до 3к, хотя со стороны сервиса не меняли ничего.
может быть вопрос в «индексах» на коллекции?
Y
может быть вопрос в «индексах» на коллекции?
Вполне может быть, ведь для того, чтобы индексы работали корректно, им надо набрать статистику и перестроиться
Y
А тут после резких движений вполне себе не успели набрать нужную статистику
Yura
может быть вопрос в «индексах» на коллекции?
Была такая мысль, но проблем с производительностью самих запросов не выявили, они даже в самые сложные времена выполняются по 100мс, с теми индексами которые нужны
Yura
А тут после резких движений вполне себе не успели набрать нужную статистику
Нагрузочные тесты выполняются часов по 6-7 и столько же времени заполняется коллекция, если бы проблемы были с индексами, мы бы получили их на старте
Y
Y
Что с ними какие-то проблемы, они корректно работают. Просто не успели еще набрать статистику. Или данные поменялись из-за чего сами индексы уже не актуальны стали
Yura
Что с ними какие-то проблемы, они корректно работают. Просто не успели еще набрать статистику. Или данные поменялись из-за чего сами индексы уже не актуальны стали
Что значит "не успели еще набрать статистику"? Речь о том что с течением времени и наполнением коллекции ситуация становится только хуже. Сколько времени нужно чтобы ее "набрать"?
Yura
что с дисками?
Диски находятся в Y.cloud, у них лимиты 7000iops или 105Мб\с. При этом с течением времени медленно увеличивался показатель iowait, но сейчас нагрузка на них 80Мб\с и 4к iops
Yura
 Yura
 Nick
Диски находятся в Y.cloud, у них лимиты 7000iops или 105Мб\с. При этом с течением времени медленно увеличивался показатель iowait, но сейчас нагрузка на них 80Мб\с и 4к iops
ну вот считай уже достигнут уровень деградации для системы и надо расширять либо диски либо память, а лучше и то и то. Какой суммарный размер индексов и сколько оперативы?
Yura
ну вот считай уже достигнут уровень деградации для системы и надо расширять либо диски либо память, а лучше и то и то. Какой суммарный размер индексов и сколько оперативы?
5.5Гб на 3 индекса с учетом _id, оперативы 8
Yura
Просто ожидания были такие, что WT, если еему будет нужно, возьмет себе из оперативы столько, сколько потребуется, но он что-то даже не собирается переступать дефолтный размер
yopp
Просто ожидания были такие, что WT, если еему будет нужно, возьмет себе из оперативы столько, сколько потребуется, но он что-то даже не собирается переступать дефолтный размер
под кеш wt выделяется 50% памяти
это связано с тем, что в кеше wt документы хранятся как есть и сжимаются только при сбросе на диск
на оставшиеся 50% памяти монга расчитывает как на запас по памяти для всего что не входит в кеш wt и на кеш фс который уже хранит сжатые данные
по этому ручку размера кеша крутить в 99% случаев очень вредно
Yura
под кеш wt выделяется 50% памяти
это связано с тем, что в кеше wt документы хранятся как есть и сжимаются только при сбросе на диск
на оставшиеся 50% памяти монга расчитывает как на запас по памяти для всего что не входит в кеш wt и на кеш фс который уже хранит сжатые данные
по этому ручку размера кеша крутить в 99% случаев очень вредно
Да, но разве он в момент когда, допустим, ему нужно выгрузить больше данных в память, он не может переступить этот порог в 50%?
yopp
по причине описанной выше это невыгодная стратегия
yopp
у вас сколько данных сейчас?
Yura
И индексов 7Гб)
yopp
а сколько планируется?
 Yura
это вот про эту часть
т.е. если я запускаю запрос без индекса который коллсканит мне всю коллекцию, то монга может съесть всю память и упасть от ООМ, а если ей просто нужно больше данных в свой кэш положить то не может?)
yopp
160млн на старте и по 80млн в год, история с хранением на 5 лет
3/52*(160+80*5) = 32гб данные
7/52*(160+80*5)= 76гб индексы
дешевле всего просто кинуть сверху ресурсов и посмотреть какой процент индексов реально используется
Yura
3/52*(160+80*5) = 32гб данные
7/52*(160+80*5)= 76гб индексы
дешевле всего просто кинуть сверху ресурсов и посмотреть какой процент индексов реально используется
Не уверен что совсем понял что нужно сделать
yopp
т.е. если я запускаю запрос без индекса который коллсканит мне всю коллекцию, то монга может съесть всю память и упасть от ООМ, а если ей просто нужно больше данных в свой кэш положить то не может?)
если у вас кроме монги нет других сервисов на этой ноде и вы не крутили ручки которые влияют на то как монга использует память, то oom у монги фактически не возможен
кеш wt под всё: индексы и данные
если у вас индексы + данные в память не вмещаются, то collscan приведёт к тому что у вас данные из кеша будут вытеснятся и новые читаться. это называется сache trashing, так как кеш как кеш не работает и все операции идут через фс
Yura
Что значит "какой процент индексов реально используется" ? Там только дефолтный _id, один индекс который сейчас используется при upsert и ещё один который не используется сейчас вообще, но будет использоваться потом в будущем
Yura
если у вас кроме монги нет других сервисов на этой ноде и вы не крутили ручки которые влияют на то как монга использует память, то oom у монги фактически не возможен
кеш wt под всё: индексы и данные
если у вас индексы + данные в память не вмещаются, то collscan приведёт к тому что у вас данные из кеша будут вытеснятся и новые читаться. это называется сache trashing, так как кеш как кеш не работает и все операции идут через фс
Ничего больше на сервере нет, но если запустить так называемый long-running реквест с коллсканом, то он пока все данные с диска в память не вычитает не успокоится и в итоге монга падает от ООМ
yopp
Yura
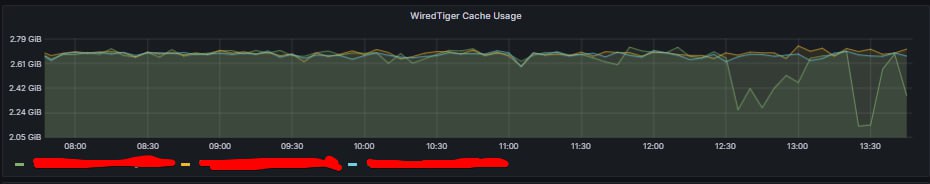
а вы меняли cacheSizeGB?
Нет, там сейчас значение по умолчанию, ~8Гб\2 - 1 = ~3.3Gb, из них он использует 2.8, как видно на графике
yopp
а что db.hostInfo().system.memLimitMB показывает?
Yura
Т.е. если я правильно понял, из-за того что в internal кэше хранятся данные в распакованном виде + индексы и мы делаем upsert, т.е. по факту сканим коллекцию и обновляем/добавляем в неё данные постоянно, то монга всегда будет стараться держать весь объем актуальных данных в нем
yopp
но в целом могу по вашим описаниям предложить следующее:
1) используйте дефолтные настройки, максимум что имеет смысл крутить:
storage:
directoryPerDB: true
wiredTiger:
engineConfig:
journalCompressor: zstd
directoryForIndexes: true
collectionConfig:
blockCompressor: zstd
даже zstdCompressionLevel нет смысла трогать, там после дефолтных 6 редко когда есть ощутимая экономия
в setParameter кроме enableFlowControl тоже крутить ничего не надо
2) размер индексов больше размера исходных данных в разжатом виде обычно симптом того, что индексы неэффективно спроектированы: _id не ObjectId, индексируемые поля указывают на {} а не на атомарные структуры или массив. это единственное что стоит оптимизировать
3) вычислительные ресурсы сейчас супердешевые. Вертикальное масштабирование самый простой и дешевый способ оптимизации 🙂
Сейчас в одну железку можно воткнуть где-то до 6TB памяти 1-2PB NVMe хранилища, до 240 ядер/480 тредов. это очень много ресурсов c 3Y TCO на уровне $10-12K/мес.
Мой локальный тестовый стол это Epyc 7551P 32c/64t / 256Gb DDR4 / 4 × 2Tb nvme и всё это обошлось мне в <$2k
Yura
но в целом могу по вашим описаниям предложить следующее:
1) используйте дефолтные настройки, максимум что имеет смысл крутить:
storage:
directoryPerDB: true
wiredTiger:
engineConfig:
journalCompressor: zstd
directoryForIndexes: true
collectionConfig:
blockCompressor: zstd
даже zstdCompressionLevel нет смысла трогать, там после дефолтных 6 редко когда есть ощутимая экономия
в setParameter кроме enableFlowControl тоже крутить ничего не надо
2) размер индексов больше размера исходных данных в разжатом виде обычно симптом того, что индексы неэффективно спроектированы: _id не ObjectId, индексируемые поля указывают на {} а не на атомарные структуры или массив. это единственное что стоит оптимизировать
3) вычислительные ресурсы сейчас супердешевые. Вертикальное масштабирование самый простой и дешевый способ оптимизации 🙂
Сейчас в одну железку можно воткнуть где-то до 6TB памяти 1-2PB NVMe хранилища, до 240 ядер/480 тредов. это очень много ресурсов c 3Y TCO на уровне $10-12K/мес.
Мой локальный тестовый стол это Epyc 7551P 32c/64t / 256Gb DDR4 / 4 × 2Tb nvme и всё это обошлось мне в <$2k
1) именно такой конфиг и стоит
2) там один compound индекс только используется для upsert, на 3 ключа. Размер данных в распакованном виде для одной коллекции равен 10Гб, а размер этого индекса 2.2Гб
3) получается если я всё правильно выше написал, то будем увеличивать, раз данные в кеш не помещаются и обращение чаще к диску пошло, это объясняет iowaits
Andrey
Нагрузочные тесты выполняются часов по 6-7 и столько же времени заполняется коллекция, если бы проблемы были с индексами, мы бы получили их на старте
Ну у меня была история, до 2 млрд. записей всё было - ок, потом можно сказать резко просело по производительности. Дело было в индексах.
Yura
Доброго дня. Такой вопрос (уже не по ситуации выше)): верно ли что на версии монги 4.4 writeConcern по умолчанию был 1, а начиная с 5.0 версии - majority? И из-за этого после обновления у нас увеличилось время обработки транзакций? (Их запускается всего несколько в параллель, внутри просто update), статистика по транзакциям такая:
"waitForWriteConcernDurationMillis":119
"durationMillis":119
Сам update с 6ms в среднем вырос до 30-40ms
Null
8.0.4 (Dec 9, '24) ◦ 7.0.16 (Dec 20, '24) ◦ 6.0.20 (Jan 15)
💀 В октябре 2024 завершилась поддержка ветки 5.0
• Документация
• Официальный курсы: MongoDB University
• 🧑🔧 Консультации и поддержка MongoDB от 2190€ в месяц: @dd_bb
• Песочница: play.db-ai.dev
Stable: 8.0.4 (Dec 9, '24)
Bugfix: 7.0.16 (Dec 20, '24) ◦ 6.0.20 (Jan 15)
Legacy: 5.0.31 (Jan '25, EOL Oct '24)
EOL: ☠️ 4.4.29 (Feb '24) ◦ 4.2.24 (Apr '23) • Legacy docs (2.2 – 4.0)