 Danil


 Nick
 Александр
Не знает ли кто, статьи на доступном для нуба языке, о том: что такое транзакции и как их юзать, при работе с монгой?
Александр
В документации толком не увидел или я слепой
Александр
Ну или там называется это как то по другому может
Nick
Не знает ли кто, статьи на доступном для нуба языке, о том: что такое транзакции и как их юзать, при работе с монгой?
https://www.mongodb.com/docs/manual/core/transactions/
Александр
https://www.mongodb.com/docs/manual/core/transactions/
Спасибо... Видимо я слепой тогда, думал что называется по другому
 S
Привет, возникла интересная проблема. У меня есть обычная коллекция Tokens и timeseries коллекция Prices. Я хочу для каждого Token вывести самую последнюю цену.
Для этого использую
Tokens.lookup({
"from": "Prices",
"localField": "name",
"foreignField": "token",
"as": "result"})
. В таком случае монго не использует индекс, созданный на Prices { token: 1 }. Оно использует его только, если сделать token - metafield в Prices. Кто-нибудь слышал почему так? Нигде в документации про это не написано
S
MongoDB 7.0.12 Community
Nick
Привет, возникла интересная проблема. У меня есть обычная коллекция Tokens и timeseries коллекция Prices. Я хочу для каждого Token вывести самую последнюю цену.
Для этого использую
Tokens.lookup({
"from": "Prices",
"localField": "name",
"foreignField": "token",
"as": "result"})
. В таком случае монго не использует индекс, созданный на Prices { token: 1 }. Оно использует его только, если сделать token - metafield в Prices. Кто-нибудь слышал почему так? Нигде в документации про это не написано
сколько документов в обеих коллекциях и сколько присутствуют в выборке, т.е. сколько бы их выдало перед лукапом в чистом виде?
S
и хорошо бы сразу эксплайн на https://pastila.nl/
Я заметил этот случай в БД, где 20 документов в Tokens и 500к документов в Prices. А сейчас просто тестирую на коллекциях по 5 документов в каждой и вижу такой же результат
Вот explain в моем случае, когда token не metafield, но есть индекс { token: 1, timestamp: 1}: https://pastila.nl/?002ed79e/a3271781e7f9dfa592d07b76b060b6c4#NYWLT3HyS+eMLV/YfoxAkA==
А вот explain, если token это metafield и есть автоматический индекс { token: 1, timestamp: 1}: https://pastila.nl/?001e5d7d/3384c5e039f6ee0dce6df21052502905#qjURpWfpDRsNvwRlyVF6GA==
Nick
Я заметил этот случай в БД, где 20 документов в Tokens и 500к документов в Prices. А сейчас просто тестирую на коллекциях по 5 документов в каждой и вижу такой же результат
Вот explain в моем случае, когда token не metafield, но есть индекс { token: 1, timestamp: 1}: https://pastila.nl/?002ed79e/a3271781e7f9dfa592d07b76b060b6c4#NYWLT3HyS+eMLV/YfoxAkA==
А вот explain, если token это metafield и есть автоматический индекс { token: 1, timestamp: 1}: https://pastila.nl/?001e5d7d/3384c5e039f6ee0dce6df21052502905#qjURpWfpDRsNvwRlyVF6GA==
На микроколлекциях смотреть использование индекса бесполезно. Наполняйте нормально, чтобы смотреть как планировщик будет действовать
Nick
Я заметил этот случай в БД, где 20 документов в Tokens и 500к документов в Prices. А сейчас просто тестирую на коллекциях по 5 документов в каждой и вижу такой же результат
Вот explain в моем случае, когда token не metafield, но есть индекс { token: 1, timestamp: 1}: https://pastila.nl/?002ed79e/a3271781e7f9dfa592d07b76b060b6c4#NYWLT3HyS+eMLV/YfoxAkA==
А вот explain, если token это metafield и есть автоматический индекс { token: 1, timestamp: 1}: https://pastila.nl/?001e5d7d/3384c5e039f6ee0dce6df21052502905#qjURpWfpDRsNvwRlyVF6GA==
Здесь видно только противоречие с первым сообщение, т.к с токеном не в метафилде в эксплейне видно использоаание индекса на лукапе
S
Nick
А блин, я перепутал ссылки )
Налейте данных как вы ожидаете при эксплуатации и так тестируйте. Использование индекса не всегда ускоряет запросы изза накладных расходов. А в случае микроколлекций колсканы по уже закешенным данным будут реально дешевле походов по индексами с доп чтениями памяти
 Александр
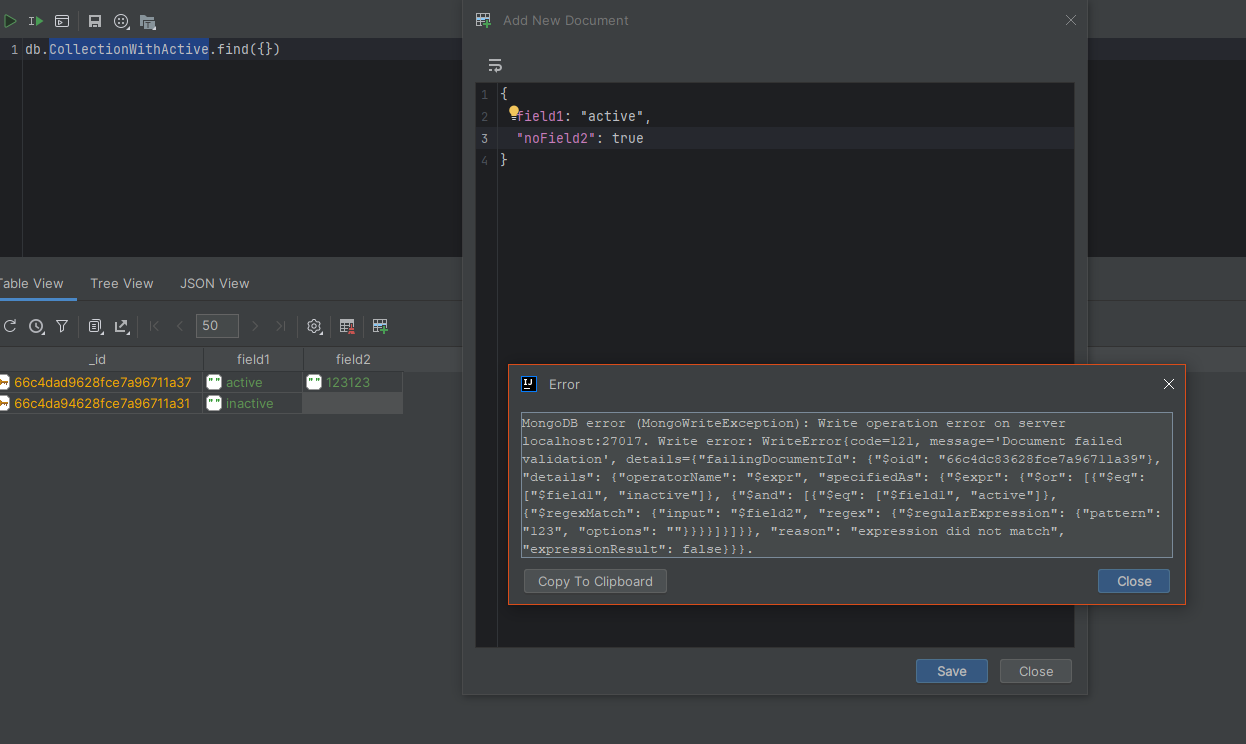
Всем привет. Подскажите, как создать валидацию для коллекции, что при field1 = "active" поле field2 должно иметь какое-то значение и в целом существовать?
 Vladyslav
NoSQL
Всем привет. Подскажите, как создать валидацию для коллекции, что при field1 = "active" поле field2 должно иметь какое-то значение и в целом существовать?
You can use query operator validation for collection. For example:
db.createCollection("CollectionWithActive", {
validator: {
"$expr": {
"$or": [
{
"$eq": [
"$field1",
"inactive"
]
},
{
"$and": [
{
"$eq": [
"$field1",
"active"
]
},
{
"$regexMatch": {
"input": "$field2",
"regex": "123"
}
}
]
}
]
}
}})
NoSQL
 Александр
не пробуйте, это часть бизнес логики и она должна быть в прикладе, а не в бд
Так хочется переложить это на базу. Придется в прикладе самим заботится об этом🥲
 Семен
А сколько бесплатных баз я могу создать с одного акка?
Nick
А сколько бесплатных баз я могу создать с одного акка?
M0 free clusters and M2/M5 shared clusters can have a maximum of 100 databases and 500 collections total.
Сергей
Всем привет) Ребят кто то разворачивал у себя 7.0 версию монги? Что в этом релизе нового в сравнении с 4 версией?
 Yaroslav
Всем привет) Ребят кто то разворачивал у себя 7.0 версию монги? Что в этом релизе нового в сравнении с 4 версией?
Привет, очень много поменялось
Сергей
Привет, очень много поменялось
А ротация логов решена? Сервис держит старые файлы логов после ротации. Удалить можно если сервис рестартануть. В 7 версии это как то решилось? Не знаете?
Yaroslav
Yaroslav
Можно в доке глянуть
Сергей
посмотрю)
Сергей
спс
Yaroslav
Там куча новых индексов, ttl коллекции появились, курсор стрим, транзакции
Сергей
1. Улучшенная агрегатная производительность: Введены оптимизации для повышения производительности агрегатных операций, что позволяет более эффективно обрабатывать большие объемы данных.
2. Развитие функций для работы с временем: Добавлены новые возможности для работы с временными данными, включая улучшенные индексы и функции агрегации, что упрощает анализ данных по времени.
3. Расширенные возможности шифрования: MongoDB 7.0 улучшает безопасность данных благодаря новым возможностям шифрования как на уровне сервера, так и на уровне клиента.
4. Поддержка многодокументных транзакций в шардированных кластерах: Улучшена поддержка транзакций в распределенных средах, что упрощает разработку приложений, требующих согласованности данных.
5. Инструменты для миграции и управления данными: В новой версии представлены инструменты для более простой миграции данных и управления ими, что облегчает работу с крупными базами данных.
6. Оптимизация индексов: Введены новые типы индексов и улучшения в существующих индексах, что помогает ускорить выполнение запросов.
7. Улучшения в области разработки: Расширены возможности для разработчиков через улучшенные API и новые драйверы, что упрощает интеграцию MongoDB в различные приложения.
Сергей
Ну вот такое нашлось
Oleg
Добрый день, хочу посоветоваться.
Есть товар, атрибуты которого заполняются на разном языке, в зависимости от региона, цена и скидка.
Как лучше, хранить каждую вариацию товара как отдельный документ? Или несколько документов на каждую вариацию свой?
Речь о хранении в моего?
На что можно нарваться, если все хранить в одном документе во избежания публикации данных.
Например при обновлении, нужно будет синхронно обновлять каждый документ.
Сотрудник 236
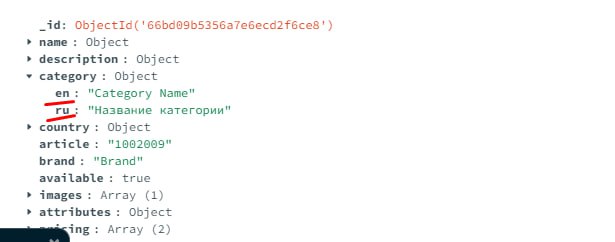
{"name": {"en": "apple", "ru": "яблоко"}, "price": {"rur": "100", "usd": "1"}}
Oleg
{"name": {"en": "apple", "ru": "яблоко"}, "price": {"rur": "100", "usd": "1"}}
так и сделал. все в одном документе. только это очень усложняет запросы
Сотрудник 236
Есть настройки юзера по языку, валюте и прочему, после получения данных из базы фильтруй по нужным полям.
 Alexander
так и сделал. все в одном документе. только это очень усложняет запросы
Плюс ограничение на размер документа
Сотрудник 236
И отправляй на фронт уже отфильтрованные
Oleg
не понятно как лучше. в отдельном документе вариации или в одном.
Сотрудник 236
как ты эти карточки товара будешь связывать?
Сотрудник 236
Если у меня язык немецкий, а валюта доллары, то на каждую комбинацию сделаешь по карточке?
Сотрудник 236
Посмотри на aliexpress
Oleg
как ты эти карточки товара будешь связывать?
весомый аргумент. Т-е все в одном документе хранить?
Сотрудник 236
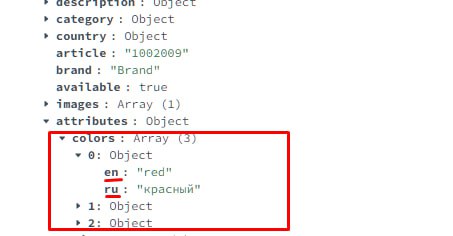
Я уже предложил вариант: поля объекта это именованные массивы, из которых на основе настроек пользователя выбирается нужное.
Oleg
Я уже предложил вариант: поля объекта это именованные массивы, из которых на основе настроек пользователя выбирается нужное.
 Сотрудник 236
Можешь создать справочники распространённых значений и брать значения оттуда.
Сотрудник 236
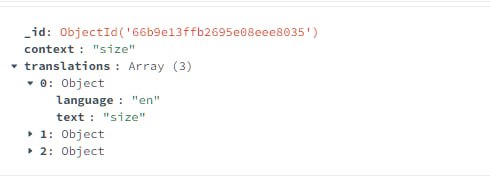
Например в отдельной коллекции. Документы виде {type: "color", values: [{name: {"en": "red", "ru": "красный"}, "rgb": "#ff0000"}, {names: {"en": "white", "ru": "белый"}, "rgb": "#ffffff"}]}
Сотрудник 236
Эти справочники НУЖНО закэшировать. Это снизит нагрузку на БД и повысит скорость ответа
Сотрудник 236
Так же надо будет предусмотреть механизм обновления кэша.
Oleg
Например в отдельной коллекции. Документы виде {type: "color", values: [{name: {"en": "red", "ru": "красный"}, "rgb": "#ff0000"}, {names: {"en": "white", "ru": "белый"}, "rgb": "#ffffff"}]}
 Сотрудник 236
{"name": {"en": "...", "ru": "..."}, "color": {"type": "color", "id": "123456"}}.
Сотрудник 236
ты можешь сделать более универсальную версию, где будет описан тип поля вроде {"type": "dict_value", "dict_name": "color", "value_id": "123456"} и {"type": "translations", values: {"en": "...", "ru": "..."}}
Сотрудник 236
Далее по 'type' ты выберешь нужный обработчик для получения конечного значения.
Сотрудник 236
Вплоть до того что будет назначаемый порядок полей, т.е. ещё будет "order" для выстраивания полей на форме.
Сотрудник 236
если у тебя трудности с этим, то при реализации будет совсем невозможно.
Oleg
не совсем увидел связь словаря с переводами и с документом - товар. Когда товар имеет несколько значений цветов. Цвета хранятся в словаря в другой колекции.
Сотрудник 236
Возьми уже готовый магазин
Oleg
Возьми уже готовый магазин
есть перевод в коллекции wordDict.
на разныз языках.
имеет id.
как этот id привязать к документу (товар) в качестве значения color: [1,2,3]?
Сотрудник 236
color: 1
Oleg
id -ник подставлять из коллекции Словарь?
может есть примеры куда подглянуть?
Сотрудник 236
Если у тебя с этим трудности - дальше будет ещё хуже.
Oleg
 Алексей
 Артем
А зачем если для этого придумали fluent/i18n?
Для чего вообще?
Речь про динамический перевод вероятно
Oleg
Нет, но ты же эти данные для чего-то юзаешь
мне на клиенте нужно взависимости от страны показать нужный перевод свойств товара
 Юлиан🦉
Создал на 2 строковых поля в документе уникальный индекс. В итоге больше одного документа в колекции одновременно не создаётся - ошибка(то есть по одному). одно поле задаётся руками, другое генерится
secrets.token_urlsafe(32)
в три попытки
Алексей
 Nick
Алексей
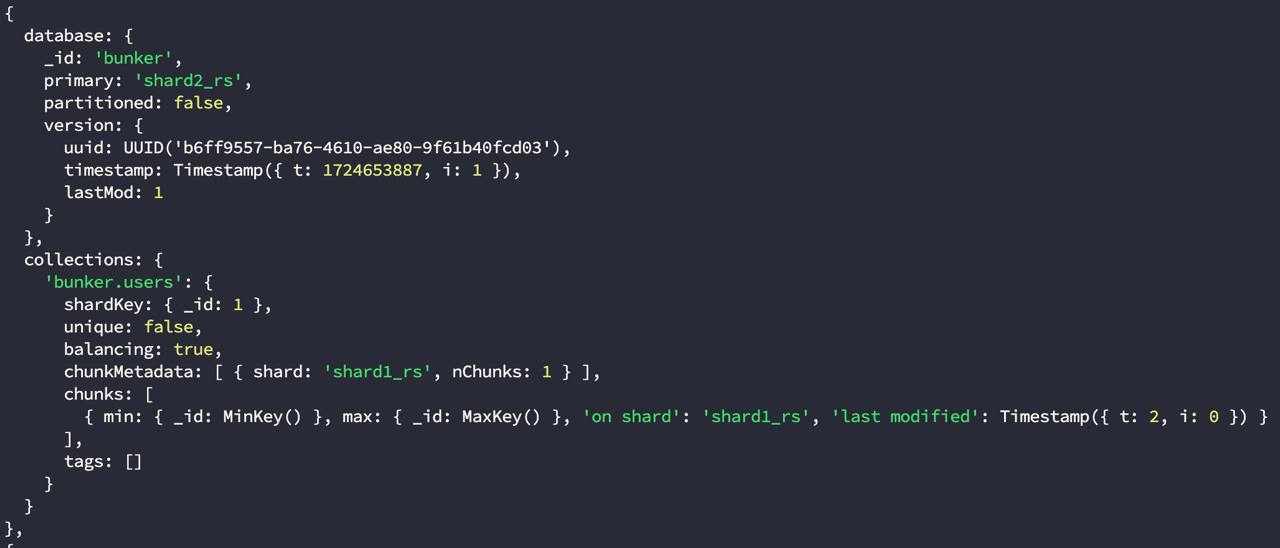
шардирование и партиционирование не одно и то же
Подскажи пожалуйста, в чем тогда проблема? Почему у меня загружен только 1 шард?
Алексей
Потому что я в первый раз этим занимаюсь)
Nick