 Егор


Я просто не пойму, почему меня с моего адреса не пускает. В iptables разрешение есть
 Tetra
Я просто не пойму, почему меня с моего адреса не пускает. В iptables разрешение есть
а уверены что адрес именно тот который указали (точно ли ipv4 например) и правила применились ли вообще? что говорит телнет на порт
Егор
а уверены что адрес именно тот который указали (точно ли ipv4 например) и правила применились ли вообще? что говорит телнет на порт
Да , адрес точно тот. Потом сбрасывал, заново ставил. Все работа до корректно , после того как фронт задеплоили то перестало почему что с дом ip подключать хотя настройки монги и iptables не менялись
 Артем
Никто случаем не знает как установить mongodb 6 на ubuntu?
Оригинальный apt репозиторий блокирует запрос с 403, а на зеркале Яндекса нет 6 версии монги
 Nick
Никто случаем не знает как установить mongodb 6 на ubuntu?
Оригинальный apt репозиторий блокирует запрос с 403, а на зеркале Яндекса нет 6 версии монги
Скачать tgz и поставить из него или впн настроить
гвоздодер
Артем
через докер просто поставь
Вынес на отдельный сервер в итоге
Докер не хотел из-за лишнего оверхеда и возможных проблем с ним (не особо шарю как правильно настраивать докер для базы)
гвоздодер
Вынес на отдельный сервер в итоге
Докер не хотел из-за лишнего оверхеда и возможных проблем с ним (не особо шарю как правильно настраивать докер для базы)
 Nick
Вынес на отдельный сервер в итоге
Докер не хотел из-за лишнего оверхеда и возможных проблем с ним (не особо шарю как правильно настраивать докер для базы)
такая большая нагрузка что от докера заметен оверхед?
Артем
такая большая нагрузка что от докера заметен оверхед?
Не знаю, пробовать просто не хочу)
Я делал тесты кликхауса в докере как-то раз и у меня что-то отвалилось в итоге из-за неправильных настроек, так что я лучше поставлю просто на виртуалку
Nick
Не знаю, пробовать просто не хочу)
Я делал тесты кликхауса в докере как-то раз и у меня что-то отвалилось в итоге из-за неправильных настроек, так что я лучше поставлю просто на виртуалку
для инфы, клик замечательно работает в докерах и в частности в кубе. Да вопрос только в корректной настройке кластера
гвоздодер
есть вопрос такой, я на локалке создал несколько баз данных, в них разные коллекции создал, как мне всё это добро перенести, не создавая заново все коллекции ?
 Vladyslav
 Kirilll
есть вопрос такой, я на локалке создал несколько баз данных, в них разные коллекции создал, как мне всё это добро перенести, не создавая заново все коллекции ?
monfodump
mongorestore
тебе должны помочь
Ya8
Здравствуйте. Вопрос такой. Дали задачу установить монгодб и создать пользователя с ограничением прав на одну бд. Я сделал так. Создал пользователя с правами роль руут для себя, чтоб потом админить и второго пользователя для них с ролью readWrite и dbAdmin. Правильно ли я сделал?
 Alex
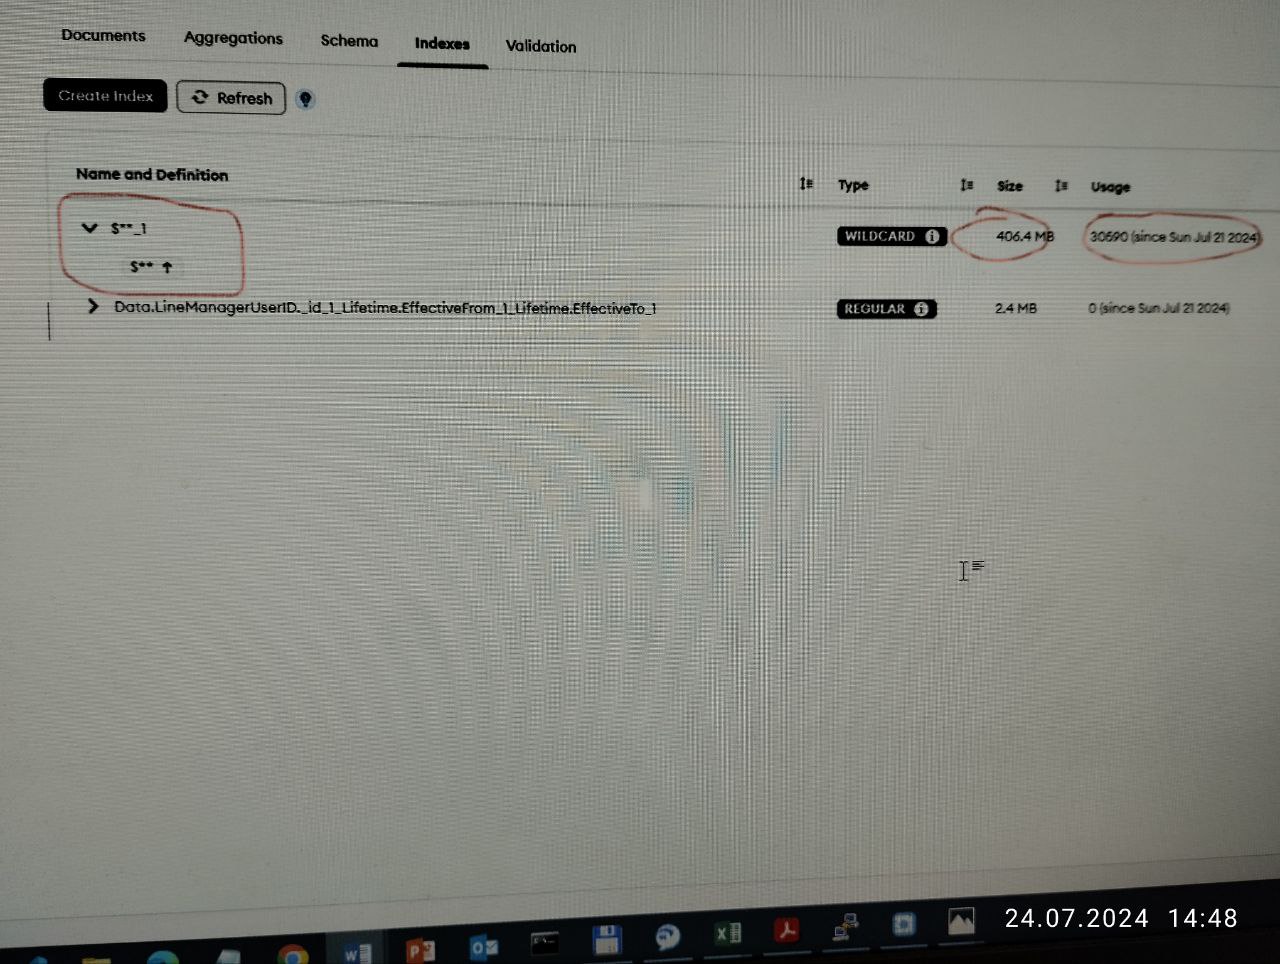
Всем добрый день!
Может быть кто-то сталкивался с таким индексом:
$**_1
Alex
 Alex
Для чего он используется?
 Александр
Для всего
Nick
Всем добрый день!
Может быть кто-то сталкивался с таким индексом:
$**_1
https://www.mongodb.com/docs/manual/core/indexes/index-types/index-wildcard/
Alex
https://www.mongodb.com/docs/manual/core/indexes/index-types/index-wildcard/
Спасибо большоеееее
 Yura
Всем привет. Кто-нибудь пробовал перевезти БД из Managed Service MongoDB в YC на обычные виртуалки в том же YC? Есть ли способ кроме moongodump\mongorestore? Смотрю в сторону mongosync, но там вроде написано что "Serverless clusters aren't supported"
Amit
Help me please
vital
а никто не сталкивался с тем что все шарды начинают жестко выжирать IOwait причем каких либо запросов в update find delete не видно и ошибок на репликасетах shardsrv нет куда можно попробовать копать?
Артем
При использовании mongodb replicaset нужно драйверам давать IP всех нод?
Сейчас подключаюсь по IP мастера, но как только он становится слейвом, то получаю ошибку No primary available for writes
Nick
Ужас, пойду конфиги менять
https://www.mongodb.com/docs/manual/reference/connection-string/#replica-set-option
 Anuar
ребят, где лучше всего бэкенд хостить ?
 Constantine
Либо амазон
web
ребят, где лучше всего бэкенд хостить ?
на убунте. я пробовал только spaceweb: https://sweb.ru/hosting/
web
https://sweb.ru/vds/
Alex 📱
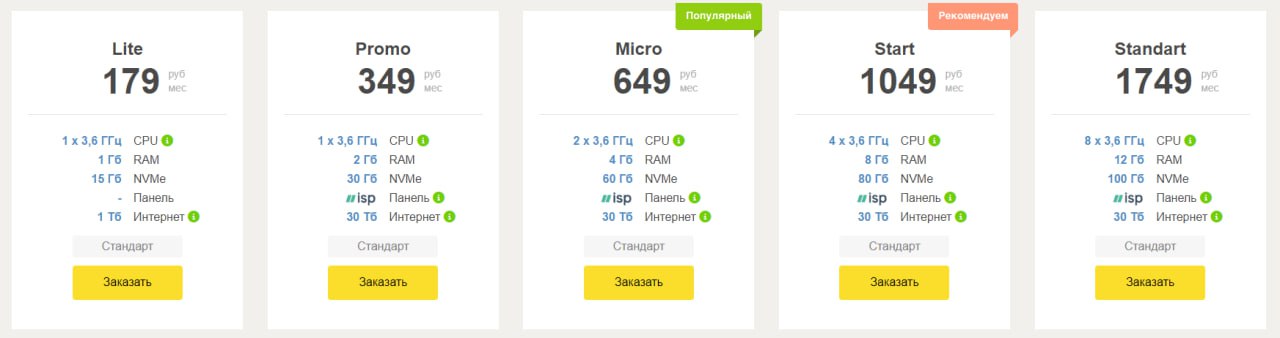
у vdsina пока самые адекватные цены
 Abdurazzoq
ребят, где лучше всего бэкенд хостить ?
https://my.adminvps.ru/aff.php?aff=27478
Тут очень адекватный цены
Abdurazzoq
 Andry
Подскажите пожалуйста - а как можно выдернуть из иерархической структуры толко последних чайлдов у которые уже чайлдов нет получается
Andry
что то я не пойму ак в GraphLookup это оформить
Andry
или нужен двусвязный список и с односвязанным такое не прокатит?
Andry
+ еще проблема db.getCollection("Location").aggregate([{ "$match" : { "WarehouseId" : "S097", "Enabled" : true, "LocationId" : "Z1" } },
{ "$sort" : { "ParentLocationId" : 1 } },
{ "$graphLookup" : { "from" : "Location",
"connectFromField" : "ParentLocationId",
"connectToField" : "LocationId",
"startWith" : "$LocationId",
"as" : "Location",
"restrictSearchWithMatch" : { "WarehouseId" : "S097" },
"depthField" : "Level" } },
{ "$unwind" : "$Location" }, { "$sort" : { "Location.Level" : -1 } },
{ "$project" : { "_id" : 0, "WarehouseId": "$Location.WarehouseId", "LocationType" : "$Location.LocationType", "LocationId" : "$Location.LocationId", "ParentLocationId" : "$Location.ParentLocationId", "Level" : "$Location.Level" }
}])
Andry
вот у меня почему то не срабаывает match
Andry
приходит добавлять restrictSearchWithMatch - почему тоже не пойму
 М.А
Ребята привет
вопрос плз, не смог найти точный ответ
Помогает ли индекс при извлечении уникальных значений
.distinct(field, ops)
И есть ли в доке про это инфа
 yopp
Всем привет!
Может, кто подскажет
У нас монго 5.0, кластер с одной шардой, растянутый на 2 цода.
Конфиг серверы - 6 штук, 3 в основном цоде и 3 в резервном, в резервном одна нода с votes = 0
Шарда с данными - 6 штук, 3 в основном цоде и 3 в резервном, в резервном одна нода с votes = 0
Бывает такое, что ненадолго тереяется сетевая связь между цодами, и получаем ошибки:
org.apache.kafka.streams.errors.StreamsException: Exception caught in process. taskId=0_4, processor=KSTREAM-SOURCE-0000000000, topic=production.elk.diagnostic-system, partition=4, offset=19465083, stacktrace=ru.lanit.torgi.commons.kafka.streams.errors.KafkaStreamException: org.springframework.dao.DataIntegrityViolationException: Write operation error on server mongo-config-3:27017. Write error: WriteError{code=202, message='Write results unavailable from failing to target a host in the shard rs0 :: caused by :: could not get updated shard list from config server :: caused by :: Couldn't get a connection within the time limit', details={}}.; nested exception is com.mongodb.MongoWriteException: Write operation error on server mongo-config-3:27017. Write error: WriteError{code=202, message='Write results unavailable from failing to target a host in the shard rs0 :: caused by :: could not get updated shard list from config server :: caused by :: Couldn't get a connection within the time limit', details={}}.
Никак не могу понять, почему такая ошибка возникает. Если теряем ноды в резервном цод, остается большинство голосующих нод, кластер по идее должен нормально рабоатть
Запоздало: скорее всего нужно у одной ноды ещё и priority: 0 выставить, так как в вашем случае количество нод-кандидатов чётное и при потере линка возникает ситуация когда обе стороны не знают где находится большинство, так как обе стороны могут выбрать себе новую primary ноду
yopp
Ребята привет
вопрос плз, не смог найти точный ответ
Помогает ли индекс при извлечении уникальных значений
.distinct(field, ops)
И есть ли в доке про это инфа
Да, помогает, так как монга может ограничится поиском по ключам индекса, а не по сканированию всей коллекции. С некоторыми оговорками, это частный случай covered query: https://www.mongodb.com/docs/manual/core/query-optimization/#covered-query
yopp
а никто не сталкивался с тем что все шарды начинают жестко выжирать IOwait причем каких либо запросов в update find delete не видно и ошибок на репликасетах shardsrv нет куда можно попробовать копать?
Такое часто бывает когда есть какой-то один запрос который выбирает большие объёмы данных. Помониторьте currentOp и попробуйте включить профайлер с низким порогом профилирования (1мс например).
yopp
Всем привет. Кто-нибудь пробовал перевезти БД из Managed Service MongoDB в YC на обычные виртуалки в том же YC? Есть ли способ кроме moongodump\mongorestore? Смотрю в сторону mongosync, но там вроде написано что "Serverless clusters aren't supported"
Serverless это отдельный продукт который есть только в атласе, его не продают партнерам, так что mongosync должен сработать
vital
Такое часто бывает когда есть какой-то один запрос который выбирает большие объёмы данных. Помониторьте currentOp и попробуйте включить профайлер с низким порогом профилирования (1мс например).
Не уверен что часто) за год или даже 2 работы шарда ни разу не происходило, ещё раз повторю что там надстройка гридфс и хранятся только файлы типо пдф и тд, и после рестарта мастеров репликасетов такой ситуации больше не повторялось(такое чувство что сам монгос начал либо чето переидексировать....)
vital
Артем
Я пытался найти внятные материалы по гридфс и чет создалось впечатление, что бесполезная вещь на фоне остальных технологий
vital
Потому что потому) dev было лень писать интеграцию)
yopp
Не уверен что часто) за год или даже 2 работы шарда ни разу не происходило, ещё раз повторю что там надстройка гридфс и хранятся только файлы типо пдф и тд, и после рестарта мастеров репликасетов такой ситуации больше не повторялось(такое чувство что сам монгос начал либо чето переидексировать....)
Самостоятельно mongos только обновляет карту чанков с конфиг серверов, в остальном только маршрутизирует запросы от клиентов
если проблема повторяется, есть смысл посмотреть на запросы клиентов, проблема скорее всего с их стороны
Косвенно о том что это могут быть длинные запросы говорит что помогает перезапуск праймари: это обрывает текущие запросы и требует переподключения всех клиентов
vital
Ну и типо как бекапить s3?)
Артем
Потому что потому) dev было лень писать интеграцию)
Понял принял)
Думал, что такой подход не работает на масштабах в 40 тб просто
vital
Бекапить s3 в монгос)
vital
Хранятся важные документы
yopp
А с реплик делаете бекапы?
vital
Можно потом добавить не репликасетов а отдельно в виде одной машины а конфиг кластер не много весит сам по себе
Артем
Реплики монги бекапим сами вм
А там случаем нельзя словить сломанное состояние?
Я к тому, получится ли с 100% шансом на успех восстановить такой бэкап
vital
Хотя хз не обкатывал решение
yopp
Можно потом добавить не репликасетов а отдельно в виде одной машины а конфиг кластер не много весит сам по себе
А вы выключаете балансировку / ставите writelock при снятии бекапов с виртуалок?
vital
Нет
yopp
Очень рекомендую попробовать отработать восстановление кластера, возможно что у вас соберется в неконсистентном состоянии из бэкапов.
Шарды сложно бэкапить. У вас чуть проще с gridfs и риски меньше, но в целом могут быть неприятные сюрпризы
vital
Надо попробовать
Артем
Может глупый вопрос, но монгу нельзя заставить лить все данные асинхронно на 1 отдельную реплику?
Причем в обход шардов, чтобы потом этот 1 - 3 instance бэкапить
vital
Ну в монгос добавляется весь репликасет
vital
А не отдельный инстанс ну по крайней мере у меня
yopp
Может глупый вопрос, но монгу нельзя заставить лить все данные асинхронно на 1 отдельную реплику?
Причем в обход шардов, чтобы потом этот 1 - 3 instance бэкапить
Между шардами нет кросс-репликации, по этому без write lock на шард надежно сделать бекап не получится
Из моей практики все сводится к тому что в каждом шарде есть hidden реплика. Когда нужно сделать бекап кластер блокируется на запись, как только hidden реплики догнали записи, они отключаются и лок снимается
Артем
Между шардами нет кросс-репликации, по этому без write lock на шард надежно сделать бекап не получится
Из моей практики все сводится к тому что в каждом шарде есть hidden реплика. Когда нужно сделать бекап кластер блокируется на запись, как только hidden реплики догнали записи, они отключаются и лок снимается
А этот процесс можно нормально автоматизировать или все нужно вручную писать?
yopp
Дальше уже с выключенных реплик снимается любым доступным способом бекап и они возвращаются в кластер
В штатном состоянии время лока буквально пара секунд, что чаще всего допустимо. Но RPO в таком сценарии не самый приятный. По этому обычно ещё есть delayed реплика на случай порчи данных и сам кластер ещё разнесен по разным дц
yopp
А этот процесс можно нормально автоматизировать или все нужно вручную писать?
Готовых инструментов для этой схемы нет, автоматизацию приходится делать самостоятельно. В моей практике под каждый кейс получается своя
yopp
В целом готовая схема есть только в Ops Manager, но это дорогое удовольствие, особенно если кластер большой
yopp
BPM без их-же движка все грустно и на больших объемах данных или при большом потоке изменений прямо совсем плохо
yopp
А их движок экономически нецелесообразно использовать, потому что ситуация как чуть выше была, где кластер развалился после обновления, с ним случаются и в реальности наработанный опыт эксплуатации есть только у самих перконовцев, по этому рано или поздно туда придется заносить денег