 Cyclone


Привет.
Модель вида
[{id: 123, subscriptions: ["aa", "bb"]},
{id: 124, subscriptions: ["cc", "dd"]}]
Надо найти все записи, у которых любой элемент subscriptions содержится в строке-параметре.
Сделал так:
db.subscriptions.aggregate( [
{ $unwind : "$subscriptions" },
{
$match: {
$expr: {
$regexMatch: {
input: "hellothere dear customers",
regex: "$subscriptions"
}
}
}
}
]
)
В java к удивлению нет метода Filters.regexMatch - написал вместо него new Document.
List<Bson> pipeline = Arrays.asList(
Aggregates.unwind("$subscriptions"),
Aggregates.match(
Filters.expr(
// почему нет Filters.regexMatch ?
new Document("$regexMatch",
new Document("input", inputString)
.append("regex", "$subscriptions")
)
)
)
);
subscriptionsCollection.aggregate(pipeline).into(..)
Можно как-то попроще?
Вроде, ещё $elemMatch подходит, но я не понимаю, как его использовать в данной ситуации.
 Y
 Nick
Y
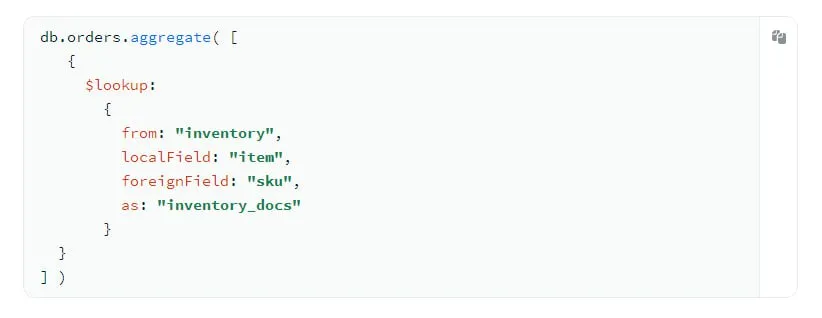
Отсортировать что именно? Само содержимое массива inventory_docs для каждого документа $sortArray. Доки по какомуто одному признаку из инвентори - вытащить прищнак и по нему обычным $sort. Возможно вам надо сначала развернуть эти массивы в плоские отдельные доки через $unwind и уже потом сортирнуть
Ну грубо говоря есть две коллекции, результат их соединения записывается в as, по итоге я ожидаю, что результат должен быть отсортирован
Y
Но кажется нашел ответ на свой вопрос здесь https://www.mongodb.com/community/forums/t/how-to-efficiently-lookup-joining-table-and-sort-by-that-data/204261 нужно пробовать
 🔊Sound
 🔊Sound
 Nick
🔊Sound
в монге такого функционала нет, так что это сокрее всего ваш код, смотрите в него
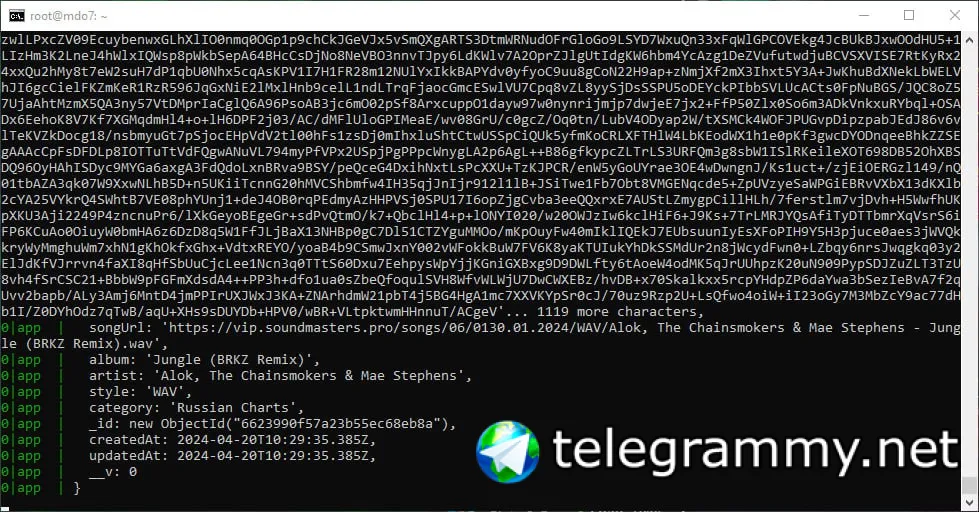
🤔Как нет? А это: db.songreleases.drop() - удаление материала из категорий
Рефреш: /api/songs/refresh/songs/01
Nick
🤔Как нет? А это: db.songreleases.drop() - удаление материала из категорий
Рефреш: /api/songs/refresh/songs/01
рефреш каким боком к монге относится?
🔊Sound
Тут наверное больше дело не в рефреше, а в том что команда drop удаляет материал на фронте и обрывает связь с базой метаданных, т.к при выгрузке не идёт сверка есть это или нет, оно штампует дубли.
🔊Sound
Может кто посмотреть из мастеров? Не бесплатно.
🔊Sound
рефреш каким боком к монге относится?
Может дело не в полном запуске базы mongo?
После перезагрузки дедик сервера я делал только: pm2 start app.js
Может идёт ещё какая то команда на базу метаданных?
Nick
Может дело не в полном запуске базы mongo?
После перезагрузки дедик сервера я делал только: pm2 start app.js
Может идёт ещё какая то команда на базу метаданных?
вот про это и разговор что надо в коде смотреть что делается, монга лишь делает что ей скажут из кода
🔊Sound
Может кто посмотреть из мастеров? Не бесплатно.
 Veaceslav
Всем привет, господа и дамы, прошу подсказать возможные решение такой вот проблемы...
Есть значит коллекция на 65к записей, выполняю выборку в которой есть $or с несколькими $gte и $lte по одному Number полю (хотя там по факту я храню timestamp), так вот я обнаружил очень странное (как минимум для меня) явление. Профайлер запроса говорит что от использует 70 документов для обработки и что интересно, если разница между $gte значением и $lte значением больше чем (3 часа) - время обработки запроса сразу взлетает с ~80ms до ~350ms.
Вот пример запроса:
{
"active": true,
"ap_userId": {
"$ne": "b1"
},
"companyId": "65fc813af50da7b6cec4b09d",
"ap_timestamp": {
"$gte": 1718524531236,
"$lte": 1718579977834
},
"$or": [
{
"ap_vehicle.ap_id": "a1",
"ap_timestamp": {
"$gte": 1718524531236,
"$lte": 1718524541383
}
},
{
"ap_vehicle.ap_id": "a2",
"ap_timestamp": {
"$gte": 1718524541383,
"$lte": 1718524557422
}
}
]
}
 Александр
Товарищи, подскажите как выполнить определенный код пайплайна (lookup например) только при условии что определенное поле текущего документа равно конкретному значению. Возможно ли вообще такое.
Александр
У меня есть коллекция событий, я хочу по типу события дополнить сам документ события при выполнении выборки. Если тип такой-то, то значит у этого события есть поле some_id, указывающее на другую коллекцию, из которой я хочу забрать еще пару полей.
Nick
Товарищи, подскажите как выполнить определенный код пайплайна (lookup например) только при условии что определенное поле текущего документа равно конкретному значению. Возможно ли вообще такое.
пайплайн собирается извне и как есть исполняется, пропускать какието стейджи в нем возможности нет
Александр
пайплайн собирается извне и как есть исполняется, пропускать какието стейджи в нем возможности нет
Хорошо, отдельным запросом достану доп. данные, спасибо :)
Виталий
Подскажите со следующим вопросом
Хочу сделать аномально большие таймауты для монгиДБ локально, для того, чтобы немного её поломать.
Идея заключается в том, что
- кидаю данные на мастер-ноду, которые выходят за максимальный размер оплога - успеваю её(ноду) выключить до того момента, как данные успеют отправиться к другим нодам.
- после чего пишу (другие) данные на оставшиеся ноды
- и вновь включаю первичную ноду
хочу потерять данные для { writeConcern: 1 } - и не потерять для { writeConcern: majority }
 yopp
Подскажите со следующим вопросом
Хочу сделать аномально большие таймауты для монгиДБ локально, для того, чтобы немного её поломать.
Идея заключается в том, что
- кидаю данные на мастер-ноду, которые выходят за максимальный размер оплога - успеваю её(ноду) выключить до того момента, как данные успеют отправиться к другим нодам.
- после чего пишу (другие) данные на оставшиеся ноды
- и вновь включаю первичную ноду
хочу потерять данные для { writeConcern: 1 } - и не потерять для { writeConcern: majority }
первый шаг противоречит условиям ack для majority, так как majority вернёт ack только когда данные будут на количестве нод которые составляют кворум.
т.е в вашем сценарии вы не получите ack по w: majority
на шаге 3 у бывшей прамари случится роллбэк, так как история текущего кластера не совпадает с историей ноды и данные откатятся до последней пересекающейся записи
yopp
смысл majority именно в том чтоб избежать ситуации как в шаге 3
yopp
для клиенто вв такой ситуации обычно достаточно сделать retry операции после того как они потеряют соединение с праймари и драйвер переподключится уже после выборов с новым cluster view
Y
 Y
{'$and': [{'_id': {'$gte': ObjectId('666642000000000000000000')}}, {'_id': {'$lte': ObjectId('666642000000000000000000')}}]}
Y
Иными словами, чтобы было проще
{'$and': [{'_id': {'$gte': 123}}, {'_id': {'$lte': 123}}]} где точно есть _id = 123 почему то не возвращает такие записи
Nick
Y
какой значени _id сейчас
Не понял вопроса. Это вымышленный пример, запись с таким id есть.
Просто если поменять правый конец на 124, то вернуться записи с id = 123, а если не менять ничего не возвращается, хотя там не строго больше меньше стоит
Y
я не понимаю, почему так
Nick
{'$and': [{'_id': {'$gte': ObjectId('666642000000000000000000')}}, {'_id': {'$lte': ObjectId('666642000000000000000000')}}]}
все корректно работает https://mongoplayground.net/p/nMRNQmM1eAR
Y
Очень странно, конечно.
У меня в моем случае не работает...
Nick
Очень странно, конечно.
У меня в моем случае не работает...
версия монги и где выполняете сам запрос?
Y
Образ монги 7.0.4
Использую вот эту библиотеку
https://motor.readthedocs.io/en/stable/api-asyncio/asyncio_motor_collection.html
Виталий
первый шаг противоречит условиям ack для majority, так как majority вернёт ack только когда данные будут на количестве нод которые составляют кворум.
т.е в вашем сценарии вы не получите ack по w: majority
на шаге 3 у бывшей прамари случится роллбэк, так как история текущего кластера не совпадает с историей ноды и данные откатятся до последней пересекающейся записи
Можно чуть уточнить про откат данных на бывшем мастери?
На сколько я понимаю синхронизация происходит из оплога - и если начиная с какого-то места записи начинают различаться - тогда берётся версия действий из текущего мастера?
Nick
Образ монги 7.0.4
Использую вот эту библиотеку
https://motor.readthedocs.io/en/stable/api-asyncio/asyncio_motor_collection.html
выполните запрос из монгошела стандартного
Y
выполните запрос из монгошела стандартного
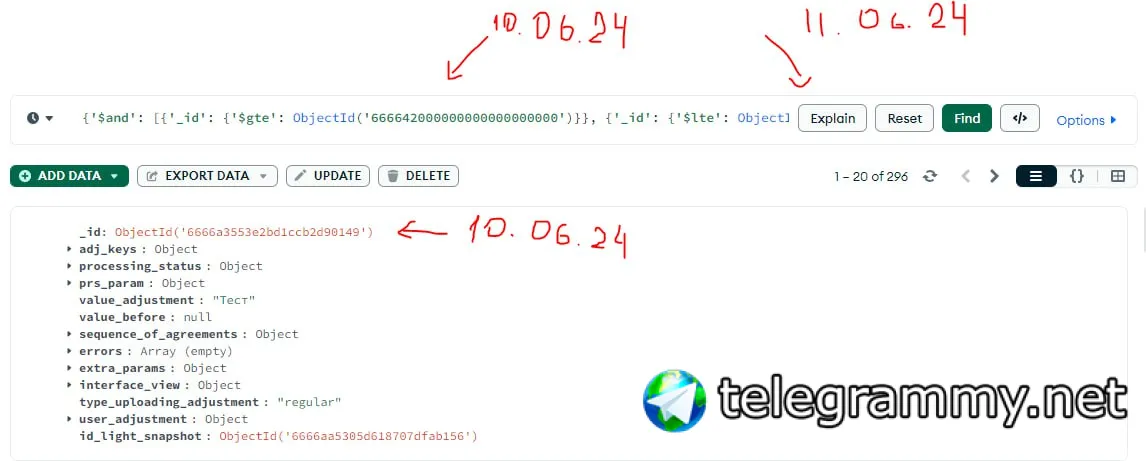 Y
выполните запрос из монгошела стандартного
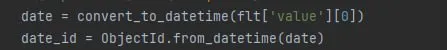 Y
не используйте даты в _id
Правильно понимаю, что это плохая практика ориентироваться на дату, которая хранится в _id, а лучше ее в момент создания документа писать отдельным атрибутом, чтобы вот потом такой неприятной истории не было?
Nick
Правильно понимаю, что это плохая практика ориентироваться на дату, которая хранится в _id, а лучше ее в момент создания документа писать отдельным атрибутом, чтобы вот потом такой неприятной истории не было?
не просто плохая, а ужасная и допустима только в крайних случаях отладки и поиска проблем как возможность примерно соориентироваться во времени когда док был создан чтобы потом сходить в логи и вокруг этого момента поискать проблемы. В остальных случаях которые относятся к бизнес логике работы с данными время из _id нельзя использовать, т.к. вы им не управляете и оно не имеет бизнес смысла как бы вы ни считали
Max
Коллеги, всем привет)
Подскажите, пожалуйста, как составить корректный запрос в базу, чтобы он выполнил сортировку по таким документа, где итоговое значение true?
"enable_in_navigations": {
"moscow": {
"pervomayskaya": true,
"kurskaya": false
}
}
Max
Коллеги, всем привет)
Подскажите, пожалуйста, как составить корректный запрос в базу, чтобы он выполнил сортировку по таким документа, где итоговое значение true?
"enable_in_navigations": {
"moscow": {
"pervomayskaya": true,
"kurskaya": false
}
}
Вот так не работает:
.find({
[`enable_in_navigations.${city}${district}`]: { $in: true }
});
Max
Вот так не работает:
.find({
[`enable_in_navigations.${city}${district}`]: { $in: true }
});
Я фронт, не бэк, если что)
Max
Вот так не работает:
.find({
[`enable_in_navigations.${city}${district}`]: { $in: true }
});
$in - вроде как для массивов, $is - такого не нашёл
Max
Буду очень благодарен за помощь)
Nick
Коллеги, всем привет)
Подскажите, пожалуйста, как составить корректный запрос в базу, чтобы он выполнил сортировку по таким документа, где итоговое значение true?
"enable_in_navigations": {
"moscow": {
"pervomayskaya": true,
"kurskaya": false
}
}
Какое итоговое значение, где сортировка, по какому полю?
 Сарапулов
Доброго всем дня. может кто то сталкивался с такой пробелмой.
Есть несколько кластеров. 2 ноды и арбитр (primary + secondary + arbitr)
Если отпадывает primary сервер(машина полностью была выключена), то оставшаяся нода очень медленно начинает работать. Приложение порой по таймауту отпадывает. настолько медленно начинает работать.
Nick
Доброго всем дня. может кто то сталкивался с такой пробелмой.
Есть несколько кластеров. 2 ноды и арбитр (primary + secondary + arbitr)
Если отпадывает primary сервер(машина полностью была выключена), то оставшаяся нода очень медленно начинает работать. Приложение порой по таймауту отпадывает. настолько медленно начинает работать.
сервера одинаковые на праймари и секондари? что мониторинг показывает по нагрузке в это время, во что упирается?
Сарапулов
P и S одинаковы по конфигурации. Абритр естественно меньше. мониторинг сильно не помогает. Нагрузки нет. Оставшиеся ноды при каждом запросе стучатся к отключившемуся серверу
Nick
P и S одинаковы по конфигурации. Абритр естественно меньше. мониторинг сильно не помогает. Нагрузки нет. Оставшиеся ноды при каждом запросе стучатся к отключившемуся серверу
что в логах монги в это время на секондари и арбитре?
Nick
Доброго всем дня. может кто то сталкивался с такой пробелмой.
Есть несколько кластеров. 2 ноды и арбитр (primary + secondary + arbitr)
Если отпадывает primary сервер(машина полностью была выключена), то оставшаяся нода очень медленно начинает работать. Приложение порой по таймауту отпадывает. настолько медленно начинает работать.
и очень медленно это сколько по времени, таймаут на сколько выставлен?
Сарапулов
600 секунд.
Сарапулов
что в логах монги в это время на секондари и арбитре?
Сейчас попробую повторить и напишу. нужно немного времени..
Nick
600 секунд.
в общем случае сразу после переключения на секондари начинают прогреватсья кеши, начиная жрать диски как не в себя, и запросы замедляются,, но условоно через какоето время поведение нормализуется после прогрева. Но 10 минут это както многовато и мониторинг должен показыват ьлибо пробелмы в сети либо перегруз по дискам либо в логах ошибки
yopp
600 секунд.
Скорее всего это из-за read/write concern majority. Так как арбитр не хранит данные, то в кластере нет кворума по данным, только по голосованию.
Варианта два: или поменять дефолтные консерны на w:1 или перейти на PSS топологию
yopp
Второе предпочтительнее
Сарапулов
мы ставили w:0 чтобы меньше ждать.....
Сарапулов
Скорее всего это из-за read/write concern majority. Так как арбитр не хранит данные, то в кластере нет кворума по данным, только по голосованию.
Варианта два: или поменять дефолтные консерны на w:1 или перейти на PSS топологию
Да когда проверял PSS оно работало при всех остальных равных конфигурациях без задержек. тормозов не наблюдалось, что странно. Забыл это упомянуть. Спасибо большое.
 👨💻
Привет. Подскажите, есть ли какие-то готовые инструменты, для того, чтобы нагрузочное тестирование на монго можно было провести, и проверить метрики потом ?
 Нуриддин
Привет. Подскажите, есть ли какие-то готовые инструменты, для того, чтобы нагрузочное тестирование на монго можно было провести, и проверить метрики потом ?
Mongolcust https://github.com/sabyadi/mongolocust
Нуриддин
Настраивается в 2х файлах все на пайтоне, поэтому разобраться не сложно
Amine
Is it always free mongodb atlas
Amine
Can I use unlimited bandiwtich
Nick
Is it always free mongodb atlas
https://www.mongodb.com/docs/atlas/reference/free-shared-limitations/
Amine
So I can use 500mb storage and use api for all times
Amine
To read and write
One limit is storage 500mb only
Nick
To read and write
One limit is storage 500mb only
read and write from/to? u also have Data Transfer Limits
Amine
Oh how much
Amine
I saw 10gb per week
Amine
Is that right ?
Nick
yeah
Amine
Cool
Amine
I just do small task scripts
Amine
I need to handle like 100k request per day