Привет, есть какие-то инструменты для восстановления mongodb? (или хотя бы данные достать)
База упала, сама не поднимается, repair заканчивается ошибкой (https://pastebin.com/WhiDLTXq)
Слышал, что можно доставать данные из .wt файлов, но какого-то удобного инструмента не нашел
upd: файл sizeStorer.wt помечает как corrupted
upd: mongodb 4.4
Бэкапы есть? Можно попробовать поднять базу на копии той папки, где монга хранит данные без реплики. Если получится, то mongodump, mongorestore...
 Pavel


 Нуриддин
У меня особо нет опыта в монгодб но как удалить кластер и проект ?
Зависит от того как ты в него заходишь, но через консоль всё просто и интернет отвечает на все вопросы
Alexey
https://t.me/mongo_db
 Ящик водки
А если без атласа? Сейчас есть индексер(еластик), но даже это за пределами доки
при чём тут атлас?
пиши алгоритм руками и совершенствуй
или что ты имел ввиду?
 Anatoly
локали чего? не понял
У нас параллельно обновили ядро на хостах с постгресом
Постгрес перестал находить старые записи в индексах с символами -/_ и др.
Ящик водки
У нас параллельно обновили ядро на хостах с постгресом
Постгрес перестал находить старые записи в индексах с символами -/_ и др.
потому что есть такое понятие как "токенизация" и ее алгоритмы могут меняться от выпуска к выпуску
Nguyễn Thị
 Nguyễn Thị
help me
Умид
Добрый день подскажите пожалуйста
Можно ли БД который прописан в mongoshell и хранится в приложении Mongodb связать с MongoAtlas с помощью URL не создавая определенную среду
 Ivan
Добрый день!
Подскажите, как сконвертировать строку в дату в версии 3.4 монги ( $toDate и $dateToString не работают)
Михаил
обновить
Ivan
А может есть какой-то легаси костыль для этой версии?)))
Михаил
https://www.cvedetails.com/vulnerability-list/vendor_id-12752/product_id-25450/Mongodb-Mongodb.html
 Nick
Добрый день!
Подскажите, как сконвертировать строку в дату в версии 3.4 монги ( $toDate и $dateToString не работают)
операция разовая? данных много надо проапдейтить?
Ivan
Разовая операция и 800000 документов
Nick
Разовая операция и 800000 документов
скриптом с конвертацией в самом скрипте, других вариантов нет на 3.4 нет
Ivan
скриптом с конвертацией в самом скрипте, других вариантов нет на 3.4 нет
А есть пример какой-нибудь, пожалуйста?
Nick
и пора бы обновиться, а то из доки уже давно сняли даже упоминание апгрейда с 3.Х на 4.0
Ivan
 максим
всем привет
ребят, кто занимается шардированием MongoDB, подскажите, пожалуйста, для 12k RPS как думаете сколько шардов может понадобиться
характеристики 1 шарда: 32 vCPU, 64 RAM, 200 NVMe
Nick
всем привет
ребят, кто занимается шардированием MongoDB, подскажите, пожалуйста, для 12k RPS как думаете сколько шардов может понадобиться
характеристики 1 шарда: 32 vCPU, 64 RAM, 200 NVMe
какой профиль по чтению/записи среди этих рпс?
 yopp
yopp
если у вас запросы более-менее селективные, 12к рпс это не страшно для современного железа
amd epyc это до 96 толстых ядер или 128 урезанных, до 6тб памяти в 12 каналах
10-15k иопсов можно вытащить из SLC nvme.
yopp
а шард это +конгфиг реплика +роутеры +очень сложные бэкапы
yopp
операционно переход на шарды оправдан когда из железа уже ничего не вытянуть
максим
повышение ресурсов не помогает
максим
мне нужно добиться отказоустойчивости за счет разбиения на шарды
в идеале у меня шарды на разных хостах
Nick
мне нужно добиться отказоустойчивости за счет разбиения на шарды
в идеале у меня шарды на разных хостах
отказоустойчивости от каких отказов?
максим
отвалится он может если хостинг забанит меня
yopp
мне нужно добиться отказоустойчивости за счет разбиения на шарды
в идеале у меня шарды на разных хостах
шардирование (в основном) не добавляет отказоуствойчивости, это способ масштабирования нагрузки
отказоустойчивость достигается через репликацию: у вас в разных местах копии данных и если одна из копий не доступна, можно обратиться к другим
Viktar
Согласен. Шарды это не про отказоустойчивость
максим
шардирование (в основном) не добавляет отказоуствойчивости, это способ масштабирования нагрузки
отказоустойчивость достигается через репликацию: у вас в разных местах копии данных и если одна из копий не доступна, можно обратиться к другим
не понял, за счет чего тогда достигается отказоустойчивость в монге
мне необходимо сделать неубиваемую монгу
 Arman
не понял, за счет чего тогда достигается отказоустойчивость в монге
мне необходимо сделать неубиваемую монгу
CP в CAP теореме. Почитай, может быть полезно
 999
 Nick
Viktar
не понял, за счет чего тогда достигается отказоустойчивость в монге
мне необходимо сделать неубиваемую монгу
За счет дополнительных нод(копий данных)
https://www.mongodb.com/docs/manual/replication/
максим
не понял
мне только что сказали что шардирование это про способ масштабирования нагрузки, разбиение на шарды это и есть реплика сеты
тогда в чем разница, если сделать реплика сеты и разбиение на шарды?
не совсем понял мысль
максим
смотри, у меня база на серваке 20 vCPU и вот она 10-12к RPS еле выдерживает (до 90% CPU нагрузки)
моя задача любым способом размазать нагрузку и сделать это отказоустойчивим
Nick
смотри, у меня база на серваке 20 vCPU и вот она 10-12к RPS еле выдерживает (до 90% CPU нагрузки)
моя задача любым способом размазать нагрузку и сделать это отказоустойчивим
Сейчас репликасет настроен или у вас только один сервер в стендалоне? И все еще не ответили на вопрос о профиле нагрузки
максим
Сейчас репликасет настроен или у вас только один сервер в стендалоне? И все еще не ответили на вопрос о профиле нагрузки
сейчас настроен 1 стандалоне mongodb сервер
максим
999
модель тут это абстракция над драйвером, которая позволяет сделать всякие вещи по типу контроля схемы, единого вида объектов, упрощения операций по работе с бд и т.п. что делает орм
Что посоветуете чтобы начать разбираться в этом всём? я просто не могу понять , модель изменяю но данные остаются те же, тогда как это вообще работает
Nick
Semyon
Чат, привет!
Очень, казалось бы, простой апдейт никак не могу сделать, подскажите плиз
{ arr: [ {name: 'Alice'}, {name: 'Bob'} ] }
=>
{ arr: [ {name: 'Alice', name_modified: 'Alice_1'}, {name: 'Bob', name_modified: 'Bob_1'} ] }
Пробовал просто путями с $, пробовал апдейтом-аггрегацией
Всякие find().forEach() не подходят
 Семен
А документы хранятся в строгом порядке или так как это элементы объекта полагатся на порядок нельзя?
У меня есть коллекция билетов и мне важно что бы они были в одинаковом порядке каждый раз
Или складывать их все в массив будет надежнее?
Nick
А документы хранятся в строгом порядке или так как это элементы объекта полагатся на порядок нельзя?
У меня есть коллекция билетов и мне важно что бы они были в одинаковом порядке каждый раз
Или складывать их все в массив будет надежнее?
Порядок документов в коллекции не гарантирован. Элементы в массиве внутри документа сохраняют порядок
Семен
Семен
Хранить в массиве мне показылось не очень удобным ибо вместо того что бы просто вставлять в коллецию придется в ставлять в массив каждый раз, это чуть сложнее
ГПТ подсказал, что я могу просто сортировать по дате создания и получать порядок постоянный и правильный, это меня устраивает
 Kirilll
По сути _id записи в монге есть время создания документам, можно обращаться к нему
Kirilll
По сути _id записи в монге есть время создания документам, можно обращаться к нему
_id.getTimestamp() так можно получить таймстемп
Nick
_id.getTimestamp() так можно получить таймстемп
Можно но не стоит, время в ид и какоето нормальное время, которое будет задано по бизнес правилу, очень разные по своей сути и далеко не всегда можно в бизнес процессе полагаться на какоето неконтролируемое время в бд, даже если оно ведет себя как вам надо
Самое банальное - время в отдельном поле вы можете поменять в случае чего, время в ид без пересоздания дока и потенциально попав на дубль не получится
 Kvhqm
А документы хранятся в строгом порядке или так как это элементы объекта полагатся на порядок нельзя?
У меня есть коллекция билетов и мне важно что бы они были в одинаковом порядке каждый раз
Или складывать их все в массив будет надежнее?
сделай поле с порядковым номером, которое будет гарантировать порядок, не полагайся на "что-то там"
Kirilll
Можно но не стоит, время в ид и какоето нормальное время, которое будет задано по бизнес правилу, очень разные по своей сути и далеко не всегда можно в бизнес процессе полагаться на какоето неконтролируемое время в бд, даже если оно ведет себя как вам надо
Самое банальное - время в отдельном поле вы можете поменять в случае чего, время в ид без пересоздания дока и потенциально попав на дубль не получится
Согласен, зависит от требования к приложения
Но если нужна просто дата создания документа, то почему бы и нет
Nick
к монге не относится, поэтому где угодно в гугле. Монга может использоваться как хранилище, но как правило выбирают кэши аля редис
Семен
Опа, оказывается максимальный размер документа 16мб я не знал этого((
Я делаю пдд тестирование и админку к нему, где юзер сможет закружать картинку к каждому вопросу
Я конечно делаю оптимизацию картинок вплоть до 90% на беке, но храню я их в конечном итоге в base64 строках прямо в бд
в теории это может вызвать проблемы и придется что-то делать, но это будет потом
На сколько это неправильно хранить их таким образом?
Просто выглядит логично что все что касается билета находится централизовано в бд
Tetra
Опа, оказывается максимальный размер документа 16мб я не знал этого((
Я делаю пдд тестирование и админку к нему, где юзер сможет закружать картинку к каждому вопросу
Я конечно делаю оптимизацию картинок вплоть до 90% на беке, но храню я их в конечном итоге в base64 строках прямо в бд
в теории это может вызвать проблемы и придется что-то делать, но это будет потом
На сколько это неправильно хранить их таким образом?
Просто выглядит логично что все что касается билета находится централизовано в бд
Картинки или другие бинари размер которых может быть больше 16мб в монге модно хранить через абстракцию gridfs. Так же замечу что картинки это не части документа и в нем должна быть только ссылка на то где взять сам бинарь будь то gridfs, ссылка на s3 или какой еще url
Александр
Опа, оказывается максимальный размер документа 16мб я не знал этого((
Я делаю пдд тестирование и админку к нему, где юзер сможет закружать картинку к каждому вопросу
Я конечно делаю оптимизацию картинок вплоть до 90% на беке, но храню я их в конечном итоге в base64 строках прямо в бд
в теории это может вызвать проблемы и придется что-то делать, но это будет потом
На сколько это неправильно хранить их таким образом?
Просто выглядит логично что все что касается билета находится централизовано в бд
Разве не проще хранить ссылку на файл или его название? А сами картинки сохранять рядом с сервером на диске
Семен
Разве не проще хранить ссылку на файл или его название? А сами картинки сохранять рядом с сервером на диске
наверное проще, но пока что я не знаю как выгружать файлы на сторонние диски и сервера, а потом это все деплоить
Вопрос только в обучении
А вообще вопрос был скорее про best practice
и судя по ответам это bed practice
Александр
наверное проще, но пока что я не знаю как выгружать файлы на сторонние диски и сервера, а потом это все деплоить
Вопрос только в обучении
А вообще вопрос был скорее про best practice
и судя по ответам это bed practice
Я не эксперт, но кажется что это лучшее решение
Если изображения привязаны к пользователю хранить их в директории в папке с юзер-id, чтобы не забивать все фотки в одну папку и ускорить поиск нужного изображения файловой системой
А ссылку на картинку хранить в базе у юзера
Александр
наверное проще, но пока что я не знаю как выгружать файлы на сторонние диски и сервера, а потом это все деплоить
Вопрос только в обучении
А вообще вопрос был скорее про best practice
и судя по ответам это bed practice
А, не заметил. Если вы используете базу не локально то да, возможно это не лучшее решение из-за передачи файла между несколькими узлами. Тогда наверное GridFS будет удобнее
Семен
Спасибо за ответы, на досуге изучу этот вопрос
Пока что для первых тестов будет так, пока не перееду на решение получше
Tor
всем привет! кто нибудь испытывает проблемы с соединением монго через атлас. я использую удаленное соединение с монго в своем проекте. код не менялся, но запросы на монго привышают и не получать ответы даже через постман. интернет есть, скорость нормальная. но соединение в БД монго нет. вчера отлично все работало, но сегодня с утра испытываю проблемы. типа таких ошибок: "Error: queryTxt ETIMEOUT cluster0.lgtepjy.mongodb.net
at QueryReqWrap.onresolve [as oncomplete] (node:internal/dns/promises:275:17)"
Tor
у меня соединение с атласом через раз, запросы тоже не уходят. превышает время ожидания, вчера только нормально работало
максим
 yopp
всем привет! кто нибудь испытывает проблемы с соединением монго через атлас. я использую удаленное соединение с монго в своем проекте. код не менялся, но запросы на монго привышают и не получать ответы даже через постман. интернет есть, скорость нормальная. но соединение в БД монго нет. вчера отлично все работало, но сегодня с утра испытываю проблемы. типа таких ошибок: "Error: queryTxt ETIMEOUT cluster0.lgtepjy.mongodb.net
at QueryReqWrap.onresolve [as oncomplete] (node:internal/dns/promises:275:17)"
Здравствуйте! Error: queryTxt ETIMEOUT говорит о проблемах с DNS. Попробуйте сменить на 1.1.1.1 или 8.8.8.8
Tor
Здравствуйте! Error: queryTxt ETIMEOUT говорит о проблемах с DNS. Попробуйте сменить на 1.1.1.1 или 8.8.8.8
спасибо! развернул монго локально через докер контейнер на своем удаленном сервере))) производительность улучшилась в разы. но за совет спасибо!
Nick
максим
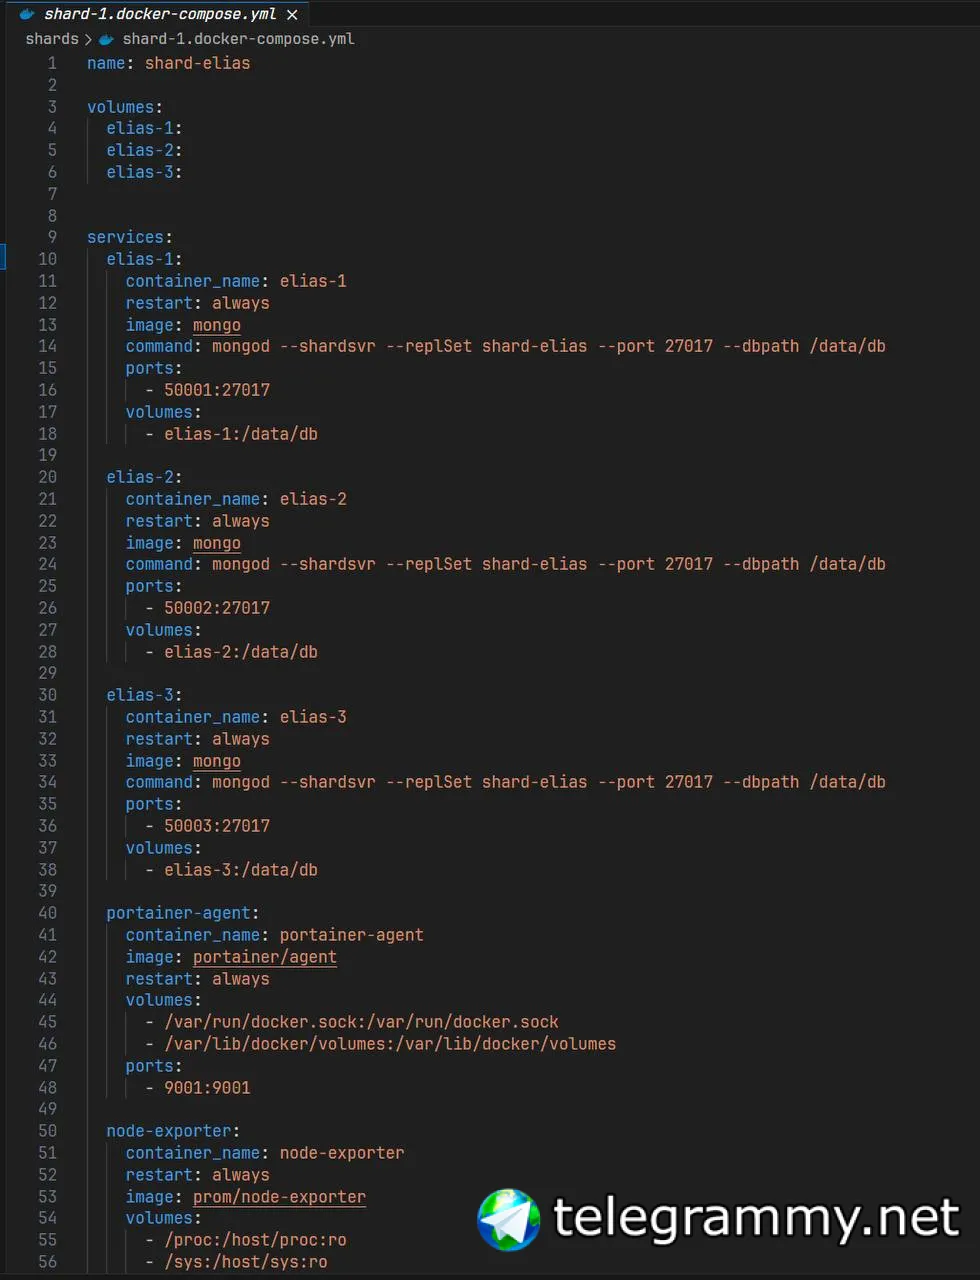
Не запускать больше одной сущности монги на одном сервере кроме как для тестов. А на тестах все что угодно и как угодно можно запускать
что значит сущности? это же реплика сет он состоит из 3-ех экземпляров
Нуриддин
что значит сущности? это же реплика сет он состоит из 3-ех экземпляров
Mongod или mongos если по простому
Nick
что значит сущности? это же реплика сет он состоит из 3-ех экземпляров
имеется в виду процесс монги независимо от того это просто запуск с разными конфигами, или обернут он докером, или другими способами контейнеризации для параллельного запуска - для прода такое не годится и смысла в композе ровно столько на сколько это упрощает сценарий тестирования
максим
имеется в виду процесс монги независимо от того это просто запуск с разными конфигами, или обернут он докером, или другими способами контейнеризации для параллельного запуска - для прода такое не годится и смысла в композе ровно столько на сколько это упрощает сценарий тестирования
оки, я уже посмотрел че такое ansible, буду через него монгу на все сервера устанавливать
 Alikhan
Всем привет! Прошу без негатива🙏🏻
У меня есть коллекция books. У документов есть ключь:
type: int32
Для type создан индекс:
schema.index({ type: 1 });
Но у некоторых документов ключ type не существует. Для этих документов индекс не был создан.
Если я напишу такой запрос:
booksCollection.find().sort(type: -1)
Как поведет себя mongodb?
Mongodb сразу по индексом отсортирует и вернет ответ
или
будет проверять каждый документ по ключу type потому что для некоторых документов индекс не был создан
Мне нужно явно создать поле type: null чтобы индекс был создан?