да, самая прямая. Разработчик приходит к ДБА и говорит "вот мне надо собрать такую эксельку, но с твоей структурой черт ногу сломит, сроку два дня, таска вон там"
Разработчик чего? Сайта? Ну.. офигеть. Но хорошо, а кто тогда будет заниматься бэкапами, репликасетами и шардами?
 andreyvsc


 free my soul
не разработчик)
andreyvsc
не разработчик)
Это понятно. Но и не dba по логике @yatoba - он запросы должен писать :)))
free my soul
возможно в стенах компании @yatoba это так, но по моему это прямая обязанность админа
andreyvsc
Давайте в терминах разберемся :)
Dba - это DataBase Administrator (сюрприз!) :)
 Nick
Разработчик чего? Сайта? Ну.. офигеть. Но хорошо, а кто тогда будет заниматься бэкапами, репликасетами и шардами?
ДБА это роль, которая нужна когда есть необходимость одного человека посадить на ответы по всем вопросам по БД со стороны организации и взаимодействия с ней. Бэкапы и репликасеты настраиваются рядовым админом за неделю ничего не зная о монге для дев стенда и еще за две недели для пром стенда после НТ. После чего админ уже не нужен и нужен саппорт-админ. Если на вашем проекте ДБА берет на себя задачи обычных админов, то это лишь ваше разделение ролей, но в обычном мире стоимость ДБА такова, что ег ослишком дорого иметь для таких простых задач
Nick
Интересная логика :) хорошо что у нас не так :)
расскажите как у вас, чтобы лучше понимать какие варианты бывают. А то на девопсов понавешают и они во всем прям эксперты и все делают
andreyvsc
У нас админы занимаются железом, осями, сетями. Дба занимаются бэкапами и перфомансом баз/кластеров. А разрабы пишут запросы, за которые получаю по рукам от dba, если запрос кладет cpu в полку.
А девопсеры... девопсеры играются в своих песочницах в кубики. Но когда дело доходит до эксплуатации и до денег - см. первый абзац.
Nick
У нас админы занимаются железом, осями, сетями. Дба занимаются бэкапами и перфомансом баз/кластеров. А разрабы пишут запросы, за которые получаю по рукам от dba, если запрос кладет cpu в полку.
А девопсеры... девопсеры играются в своих песочницах в кубики. Но когда дело доходит до эксплуатации и до денег - см. первый абзац.
ну если ДБА можно заменить на два скрипта и полтора аллерта, то в моем понимании это саппорт админ с навыками работы с бд
Nick
главное, что для вашей компании они решают задачи и закрывают проблемы с БД, значит такое разделение тоже имеет смысл
andreyvsc
ну если ДБА можно заменить на два скрипта и полтора аллерта, то в моем понимании это саппорт админ с навыками работы с бд
Ну если вы считаете что алерт от мониторинга и бездумный скрипт - это максимум, что можно сделать на базе, то конечно.
Nick
Ну если вы считаете что алерт от мониторинга и бездумный скрипт - это максимум, что можно сделать на базе, то конечно.
просто из перечисленного только перформанс имеет место быть, но как раз тут те самый ДБА и должны писать запросы или исправлять запросы разрабов, а не просто бить по рукам. Потому что по рукам как раз должен бить алерт, который триггерится по тяжелы запросам.
Есть еще редкая когорта ДБА, которая понимает что можно крутить внутри БД, но например в той же монге можно крутить пару ручек и это делается опять же один два раза и больше не трогается и тут нет потребности в целом человеке с ролью ДБА
andreyvsc
просто из перечисленного только перформанс имеет место быть, но как раз тут те самый ДБА и должны писать запросы или исправлять запросы разрабов, а не просто бить по рукам. Потому что по рукам как раз должен бить алерт, который триггерится по тяжелы запросам.
Есть еще редкая когорта ДБА, которая понимает что можно крутить внутри БД, но например в той же монге можно крутить пару ручек и это делается опять же один два раза и больше не трогается и тут нет потребности в целом человеке с ролью ДБА
Ну... не знаю. Дба не может и не должен знать логику аппликухи. И запрос который порождает эта аппликуха может быть плохим. Поймать алерт - дело дба. Посмотреть на запрос и предложить индекс наложить (или запрос переписать) - тоже дело дба. А вот писать его с 0 - не его задача.
А насчет ручки покрутить... я а монгу не сильно пока, но в том же клике и постгресе ой как не одну ручку можно покрутить. И это дело дба :)
Nick
Ну... не знаю. Дба не может и не должен знать логику аппликухи. И запрос который порождает эта аппликуха может быть плохим. Поймать алерт - дело дба. Посмотреть на запрос и предложить индекс наложить (или запрос переписать) - тоже дело дба. А вот писать его с 0 - не его задача.
А насчет ручки покрутить... я а монгу не сильно пока, но в том же клике и постгресе ой как не одну ручку можно покрутить. И это дело дба :)
повторюсь, такое разделение имеет место быть. В моем мире видимо по другому
Nick
Ну... не знаю. Дба не может и не должен знать логику аппликухи. И запрос который порождает эта аппликуха может быть плохим. Поймать алерт - дело дба. Посмотреть на запрос и предложить индекс наложить (или запрос переписать) - тоже дело дба. А вот писать его с 0 - не его задача.
А насчет ручки покрутить... я а монгу не сильно пока, но в том же клике и постгресе ой как не одну ручку можно покрутить. И это дело дба :)
в целом, если у вас есть доступы к управлению бюджетами, то можете поиграться в разбивке текущих обязанностей, их частоты и затрат времени и требуемой для этого квалификации. Потом пересоберите уже относительно квалификации и получите другой ФОТ с другими ролями
andreyvsc
в целом, если у вас есть доступы к управлению бюджетами, то можете поиграться в разбивке текущих обязанностей, их частоты и затрат времени и требуемой для этого квалификации. Потом пересоберите уже относительно квалификации и получите другой ФОТ с другими ролями
Мы... куда-то уже в сторону ушли.
Я собственно дба. И такое положение дел с таким разделением обязанностей меня полностью устраивает.
Оно просто много где. Я понимаю, что в мире девопсов может и другой расклад, но меня он удивляет немного.
Я потому и спросил "почему дба должен писать запрос". В смысле "а разраб тогда что пишет"?
Nick
А запрос (который вызван из кода) это не код?
Тут сложно. Простые запросы это не код, километровые джойны без бизнес логики не код, с бизнес логикой - код. Запросы со спец фичами конкретной БД не код, т.к. по сути простые, но вполне потребует участия дба, т.к. он может обладать сакральными знаниями
andreyvsc
Тут сложно. Простые запросы это не код, километровые джойны без бизнес логики не код, с бизнес логикой - код. Запросы со спец фичами конкретной БД не код, т.к. по сути простые, но вполне потребует участия дба, т.к. он может обладать сакральными знаниями
Я хотел подловить на ситуации попроще: когда разраб написал db.connect(); а потом написал db.execSql('...'); должен ли он ждать дба там где '...'? :)))
andreyvsc
Про запросы с хинтами - согласен, без дба - сложно :)
Nick
Я хотел подловить на ситуации попроще: когда разраб написал db.connect(); а потом написал db.execSql('...'); должен ли он ждать дба там где '...'? :)))
поэтому и сложно, потому что задача разработчика облачить бизнес логику в коде. Если запрос очевидно содержит сложную бизнес логику, с которой у разраба нет опыта и понимания как он повлияет на "производительность" БД, то да можно смело идти к ДБА. Тут всегда можно апеллировать к тому что разработчик должен уметь сам в БД, но он как раз и не занимает роль ДБА и не обязан самостоятельно решать такие вопросы самостоятельно раз роль ДБА выделена на проекте
andreyvsc
"Что такое экзамен? - это разговор двух умных людей" 😂
В общем мы друг друга поняли 😂 наверное 🙄
Nick
да, конечно
 Умид
Я здесь прочитал ваш спор и задаюсь вопросом так называемый DBA сотрудник, Разраб и т.д должны владеть несколькими языками На подобии SQL и NoSQL или это не обязательно
Nick
Я здесь прочитал ваш спор и задаюсь вопросом так называемый DBA сотрудник, Разраб и т.д должны владеть несколькими языками На подобии SQL и NoSQL или это не обязательно
не обязательно, но желательно, это кругозор, который работает как и в обычно жизни - гдето проще потом разбираться, гдето проще решение принять, гдето проще вырасти за счет наличия навыка
andreyvsc
Я здесь прочитал ваш спор и задаюсь вопросом так называемый DBA сотрудник, Разраб и т.д должны владеть несколькими языками На подобии SQL и NoSQL или это не обязательно
для DBA - зависит от специфики. Ну вот мне по сути надо по-верхам уметь в диалекты SQL от Microsoft, Postgres, ClickHouse (они таки разные) ну и знать что-то большее чем show collections в Монге :)
andreyvsc
Но писать восьмикратный INNER JOIN я не умею и не буду :)))
Умид
Очень интересно спасибо вам большое
Vladimir
Но писать восьмикратный INNER JOIN я не умею и не буду :)))
Стоит только начать и не остановишься потом 😁
 yopp
Как ДБА консультант, могу сказать, что роль DBA — это роль системного инженера и немного системного архитектора
База данных, это не просто процесс запущеный в какой-то ОС, это ещё и железо, его внутренней устройство, куча протоколов по которому это железо внутри работает и общается с внешним миром.
Ну вот зачем кому-то знать что у SATA протокола вообще нет мультиплексации запросов, по SAS параллельно может выполнятся два запроса, а NMVe позволяет 64k × 64k. Или почему увеличение логических уровней у NAND Flash ячеек ведёт к увеличению времени и напряжения для записи и стирания из-за того что в /подзатворном диэлектрике/ после каждой program/erase операции начинает накапливать отрицательный заряд, который нужно компенсироваь. А это даёт понимание как производители втыкая DRAM кеш, за которым стоит SLC кеш, рисуют на графиках красивые цифры, но в реальности они будут совсем не такие красивые и только какое-то время. А без этого не понять, как правильно замерить стоит ли платить в прямом смысле бешенные миллионы за замену древнего Optane на новый пестрый Samsung PM1743 на вашем кластере который занимает по 4 стойки в 5 дц по всему миру 🙂 (да, но ещё больший профит от замены всего остального оборудования на новое, которое в 5 раз уменьшит счёт за электричество)
Ну или Percona Performance Manager. В 99% случаев оно бесполезено для разработчиков и девопсов. За 15 лет работы с MongoDB я знаю, какие графики и что показывают, что они значат и как на них можно повлиять (и каких графиков нет, а надо бы)
Но DBA роль не нужна в 95% проектов, особенно с монгой. У монги по сути нет языка запросов, а есть API, который более-менее одинаковый на всех языках и агрегации, которые пишутся на привычном всем json и сложность не в том каким синтаксисом их описывать, а что от них в итоге хочется получить
До состояния когда у вас проблемы где реально нужен DBA доходят _очень_ редко. Либо у вас небольшая команда и много данных, либо большая команда и мало данных или вы победили во всех лотереях и у вас и команда большая и данных много.
По этой причине нет особого смысла обучать каким-то там особенностям проектирования и хитрые паттерны или ещё какие чудеса.
Всё сводится к нехитрым советам:
Не складывайте данные в названия полей, потому что на них индекс нормально не сделать. Если запрос тормозит посмотрите в explain и если там collscan или сортировка в памяти сделайте по полям из запроса индекс. Всегда дешевле делать индексы, пока не начнёт тормозить вставка. Когда начнёт тормозить вставка удалите ненужные индексы. Если вы считает по большим объёмам документов и это сильно тормозит, используйте covered query. Транзакции в 95% случаев не нужны. Если кажется что нужны, проблема скорее всего решается атомарными обновлениями, так что попробуйте ещё как-то иначе сформулировать проблему. Если иначе не получается, то писать внутри транзакции и только с read/writeConcern: majoritу и обратно читать только с readConcern:majority. Роллбэки это нормально, просто повторите операцию.
Дешевле всего вообще не хранить данные 🙂
Удаляйте всё ненужное, особенно PII. Если совсем удалить нельзя, оставьте только самые необходимые поля и удалите остальное. Всегда дешевле слить исторические данные в виде файлов в s3/wasabi или ещё куда-то (и пожалуйста, не надо архивировать в кликхаус!), чем хранить их в СУБД. CSV занимает меньше места чем JSON, zstd отлично их сжимает. Дата-аналитики со своим пандасом и прочими нампаями отлично умеют туда ходить, парсить cvs и привыкли часами смотреть на прогрессбар.
Всё, поздравляю теперь вы Database Developer и сэкономили несколько сотен тысяч долларов на услугах DBA. Просите повышение в зарплате!
yopp
Personal Identifying Information ака персональные данные
 Alexander
Andrey
Мы... куда-то уже в сторону ушли.
Я собственно дба. И такое положение дел с таким разделением обязанностей меня полностью устраивает.
Оно просто много где. Я понимаю, что в мире девопсов может и другой расклад, но меня он удивляет немного.
Я потому и спросил "почему дба должен писать запрос". В смысле "а разраб тогда что пишет"?
дба, это что за «наречье», что-то из 90х-2000х?
Понятно, что специфика присутствует, но в большинстве случаев, решается разрабами самостоятельно с помощью документации и ресерча с тестовыми данными, большими тестовыми данными, если это необходимо. С текущим уровнем и доступностью железа, эти эксперименты можно легко и быстро проводить, стмулируя любую нагрузку.
andreyvsc
дба, это что за «наречье», что-то из 90х-2000х?
Понятно, что специфика присутствует, но в большинстве случаев, решается разрабами самостоятельно с помощью документации и ресерча с тестовыми данными, большими тестовыми данными, если это необходимо. С текущим уровнем и доступностью железа, эти эксперименты можно легко и быстро проводить, стмулируя любую нагрузку.
А мне лично кажется что все что вы пишете - это девопс-наречье родом из 2010 :)
Andrey
А мне лично кажется что все что вы пишете - это девопс-наречье родом из 2010 :)
Вообще к девопсам отношения не имею. Вам высказали мнение, что в большинстве случаев дба - не нужен, если разраб выбирает монгу или сцилу и постгрес, что угодно, он «чем-то» руководствуется, ему в конечном итоге писать код под данные и работу с ними.
andreyvsc
Вообще к девопсам отношения не имею. Вам высказали мнение, что в большинстве случаев дба - не нужен, если разраб выбирает монгу или сцилу и постгрес, что угодно, он «чем-то» руководствуется, ему в конечном итоге писать код под данные и работу с ними.
Мнение высказали... и? Поработайте 10+ лет в непрерывной эксплуатации того что девопсеры (тогда еще просто разрабы) когда-то там понаписали :)
Andrey
Мнение высказали... и? Поработайте 10+ лет в непрерывной эксплуатации того что девопсеры (тогда еще просто разрабы) когда-то там понаписали :)
Вы как то на личности перешли. Причем тут девопсеры и разрабы. У вас какая-то неприязнь к девопсерам? у девопсеров от разрабов, только автоматизация процессов, но не архитектура и разработка систем. Какие 10 лет, в ит лет 18, и в последние н лет большинство(не все) вопросов решается разрабами с помощью документации и обменом опыта. «Базы данных» пишут разрабы, но ни как не дба.
andreyvsc
Вы как то на личности перешли. Причем тут девопсеры и разрабы. У вас какая-то неприязнь к девопсерам? у девопсеров от разрабов, только автоматизация процессов, но не архитектура и разработка систем. Какие 10 лет, в ит лет 18, и в последние н лет большинство(не все) вопросов решается разрабами с помощью документации и обменом опыта. «Базы данных» пишут разрабы, но ни как не дба.
Где?
Хотя к девопсерам есть вопросы, да. Но эти вопросы за рамками этого обсуждения. А вот то что "базы данных пишут разрабы" - это очень дурная практика. Которая на 10+ эксплуатации (это после того как разрабы понаписали) выражается в "заливании" ресурсами и деньгами, вместо вдумчивого анализа. Если дба нет.
Andrey
Где?
Хотя к девопсерам есть вопросы, да. Но эти вопросы за рамками этого обсуждения. А вот то что "базы данных пишут разрабы" - это очень дурная практика. Которая на 10+ эксплуатации (это после того как разрабы понаписали) выражается в "заливании" ресурсами и деньгами, вместо вдумчивого анализа. Если дба нет.
Простите, какая-то незрелость, ничего дурного в «заливании» ресурсами и деньгами нет, если бизнес решает свои вопросы и его устраивает бюджет, то значит все ок, не устраивает решение и бюджет - ищется решение, вроде так это работает.
andreyvsc
Простите, какая-то незрелость, ничего дурного в «заливании» ресурсами и деньгами нет, если бизнес решает свои вопросы и его устраивает бюджет, то значит все ок, не устраивает решение и бюджет - ищется решение, вроде так это работает.
И вы мне говорите про переход на личности? 😂
Бизнес решает, ага. И это решение как ра и называется дба. Проанализировать и оптимизировать что есть и начать бить по рукам тем кто говорит "чот не вывозит - купите сервер"
Nick
холиварненько сегодня)
Andrey
Ну зеркальный ответ. Хорошо что есть разность мнений. От слов «бить по рукам» веет чем-то несвежим.
andreyvsc
andreyvsc
А про pitr в монгк мне так никто и не ответил :))
Andrey
Жизнь жестока :)))
Я вам прямо скажу, у вас все плохо, если «тяжелые» запросы имеют шанс проходить в прод. Такие вопросы уже давно продуманы и решаются зачастую простыми мерами.
yopp
Пожалуйста, уважительно относитесь к своим коллегам
Amine
 Amine
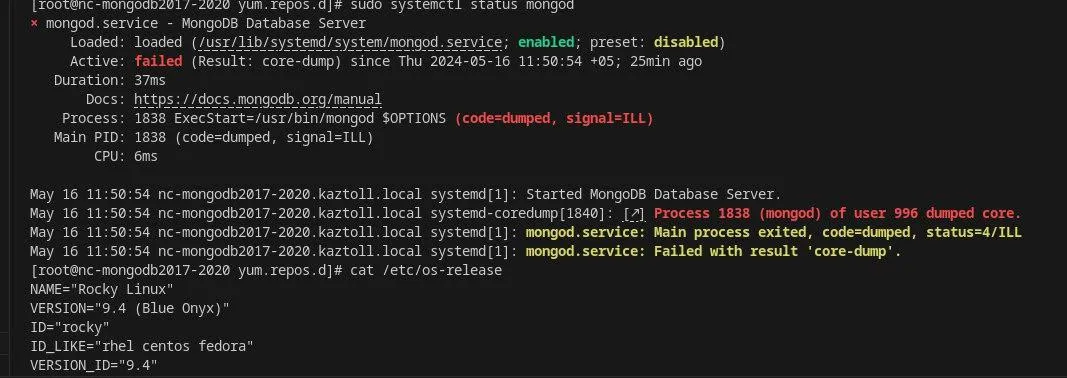
What can be the issue runing Ubuntu v22
yopp
А про pitr в монгк мне так никто и не ответил :))
Тут в первую очередь вопрос в том какие риски вы хотите закрыть: повреждение данных, потеря данных или недоступность данных (например блекаут в основном дц)
Но всё всегда упирается в деньги: сколько RPO и RTO вы себе можете позволить на доступный вам бюджет.
Если хочется спокойно спать, то взять атлас с бекапами. Это кажется дорогим, но на самом деле это самое дешевое решение из возможных, если посчитать все косты на содержание монги. Дорого только если у вас _очень_ много данных. Но обычно когда столько данных, это выглядит очень даже не дорого. В редких случаях успешность бизнеса зависит от того чтоб дешево хранить много данных, но тогда из сути бизнеса вытекает необходимость своих собственных инженерных решений.
Если атлас нельзя, но есть $25,000 × %число_нод в год, то enterprise edition + ops manager
Если атлас нельзя, на enpterprise бюджета нет то
1) дешевле и проще всего mongodump --oplog
В большинстве случаев реально критичных данных которые могут повлиять на бизнес очень мало и их можно просто дампить в цикле, а для всего остального обеспечить избыточность разложив реплики по разным местам и сделав delayed реплику, на случай если к вам придёт db.PAY_BTC_TO_RESTORE_DATA или кто-то сделает неудачный апдейт
2) если вы умеете варить LVM так чтоб он не ломался или готовы крутить монгу на любой другой фс которая надежно умеет в снепшоты, то hidden replica и дергать снепшоты с неё
3) Percona Backup Manager: очень странный инструмент. Если вы будете его поднимать, то на мой взгляд нужно систематически отрабатывать recovery процедуры на клоне кластера, чтоб понять сколько RPO какое RTO вам будет стоить в вашем конкретном слепке данных.
Ещё есть куча всяких полуживых инструментов на гитхабе, на их базе можно что-то своё собрать
Если у вас большой шард, то атлас или EE с опс менеджером.
Если нет бюджета на EE, но есть тысяч пять евро, то можете нанять меня я вам расскажу что надо удалить, выгрузить в холодное хранилище и вообще не нужно бэкапить.
(а за десять расскажу ещё и бизнесу на пальцах в евро 😉
Если всё оставшееся не влезет на primary шард, то расскажу про схему по которой вы сможете написать своё решение, которое даёт вменяемый RPO и RTO и почти никак не влияет на доступность кластера.
yopp
What can be the issue runing Ubuntu v22
Sadly, but it seems like your CPU doesn't support AVX instruction set and AVX is required starting from v5.0.
Worse, is that you don't have much options here:
0) find a way to run on cpu with AXV support. Maybe try another VM class if you are in a cloud, or even other cloud provider if they don't have VM's with AVX. If you are running on bare metal — update your hardware. Unfortunately, this is the only option to have mainline mongo from official sources
1) you can try to find pre-built mongo without AVX instruction set, there are few projects around who tried to that
2) build it yourself, you might find few repositiories on gihtub that attempted to simplify build pricess
3) try mongodb atlas. if you are just starting with mongo, free tier is more than enough
4) rollback to 4.4.27
Sorry for breaking bad news
Amine
I'm already moving from MySQL and I'm tired from all this types resources
 Дмитрий
Всем привет, грузил большой файл и под конец полетела ошибка:
connect ECONNREFUSED 127.0.0.1:27017, connect ECONNREFUSED ::1:27017
Нагуглил, что у меня не запущен сервер, попытался его запустить через службу. Выдает 1053 ошибку
Я почистил место на жестком диске, обновил комп, поковырялся в конфиге, но ничего не помогает
Кто-то решал такую проблему?
Дмитрий
Читайте логи монги
Я прочитал, но не понял
{"t":{"$date":"2024-05-23T12:37:15.018+03:00"},"s":"E", "c":"WT", "id":22435, "ctx":"conn146","msg":"WiredTiger error message","attr":{"error":28,"message":{"ts_sec":1716457035,"ts_usec":17895,"thread":"3812:140719994906448","session_dhandle_name":"file:collection-56--7020511409404362867.wt","session_name":"WT_CURSOR.insert","category":"WT_VERB_DEFAULT","category_id":9,"verbose_level":"ERROR","verbose_level_id":-3,"msg":"int __cdecl __win_file_write(struct __wt_file_handle *,struct __wt_session *,__int64,unsigned __int64,const void *):435:D:\\mag\\diplom\\mongodb\\files\\collection-56--7020511409404362867.wt: handle-write: WriteFile: failed to write 32768 bytes at offset 3407855616: Íåäîñòàòî÷íî ìåñòà íà äèñêå.\r\n","error_str":"No space left on device","error_code":28}}}
Дмитрий
Нет места на диске
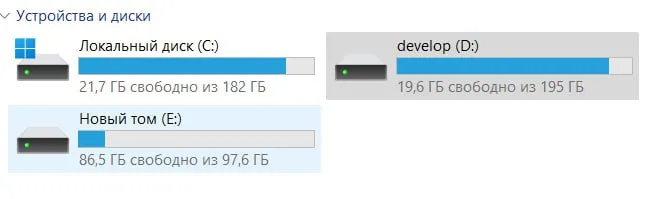 Nick
Nick
Дмитрий
Но прежде перезапустите службу и посмотрите свежий лог
кнопка перезапуска неактивна, можно только запустить и получить 1053
Дмитрий
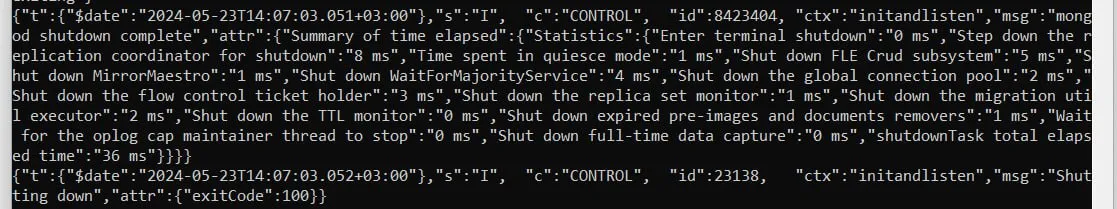
Надо запустить с флагом repair разово https://www.mongodb.com/docs/manual/tutorial/recover-data-following-unexpected-shutdown/
 Дмитрий
Ничего, последняя запись 1.5 часа назад
{"t":{"$date":"2024-05-23T12:37:15.018+03:00"},"s":"E", "c":"WT", "id":22435, "ctx":"conn146","msg":"WiredTiger error message","attr":{"error":28,"message":{"ts_sec":1716457035,"ts_usec":17895,"thread":"3812:140719994906448","session_dhandle_name":"file:collection-56--7020511409404362867.wt","session_name":"WT_CURSOR.insert","category":"WT_VERB_DEFAULT","category_id":9,"verbose_level":"ERROR","verbose_level_id":-3,"msg":"int __cdecl __win_file_write(struct __wt_file_handle *,struct __wt_session *,__int64,unsigned __int64,const void *):435:D:\\mag\\diplom\\mongodb\\files\\collection-56--7020511409404362867.wt: handle-write: WriteFile: failed to write 32768 bytes at offset 3407855616: Íåäîñòàòî÷íî ìåñòà íà äèñêå.\r\n","error_str":"No space left on device","error_code":28}}}
Nick
Nick
Всем привет, грузил большой файл и под конец полетела ошибка:
connect ECONNREFUSED 127.0.0.1:27017, connect ECONNREFUSED ::1:27017
Нагуглил, что у меня не запущен сервер, попытался его запустить через службу. Выдает 1053 ошибку
Я почистил место на жестком диске, обновил комп, поковырялся в конфиге, но ничего не помогает
Кто-то решал такую проблему?
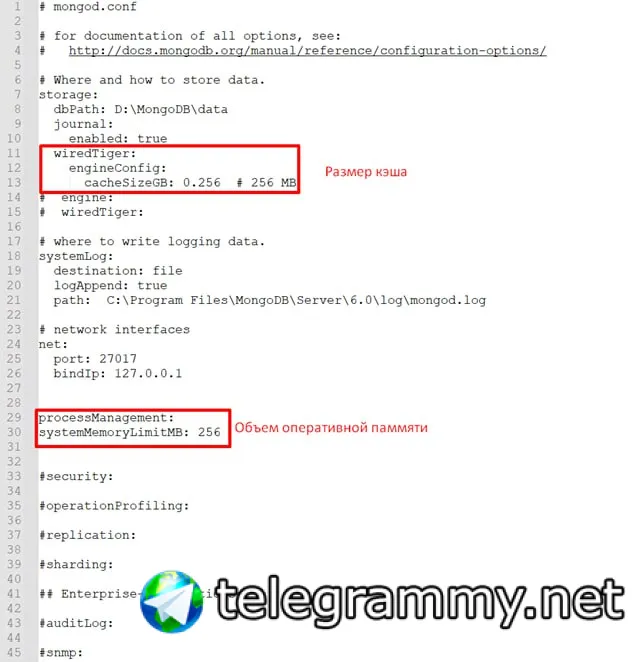
А что в конфиг файле делали? Еще может быть что он теперь кривой
Дмитрий
сейчас он такой:
Дмитрий
Но конфигу я менял
Дмитрий
когда выскачила ошибка, был такой
Дмитрий
 Дмитрий
я хотел убрать сохранение кэша
Nick
Дмитрий
Сформировать строку запуска монги с указанием пути к конфиг файлу текущему, либо явно указать путь к файлам бд
я извиняюсь, а можете подсказать как это делается? Я зашел в cmd в ту же папку, где лежит conf и ввел mongod --repair
Дмитрий
Вот кривой файл сразу видно, нельзя оставлять висящие поля без значений, и проверьте отступы
вы про то, что закоменчено?