 Nor


Точнее, есть составной _id, что должен покрывать _id.c
 Nick
Точнее, есть составной _id, что должен покрывать _id.c
_id.c намекает что это ключ-объект с полем c. Индексы в таком случае покрывают только сравнение объекта целиком и отдельные поля он не выделяет для индексации
 yopp
Точнее, есть составной _id, что должен покрывать _id.c
индекс покрывает содержимое поля как bson объекта. т.е в вашем случае _id работает как индекс на полное побайтовое совпадение двух bson представлений ключа, например {a: 1, c: 1}.
В вашем случае как выше указали нужен индекс который явно указывает содержимое какого ключа индексировать, т.е _id.c
yopp
в целом составной _id в большинстве случаев только создаёт очень большие проблемы, не принося какой-то реальной пользы
Nor
Окак. Спасибо пойду тюнить.
 Andrey
в целом составной _id в большинстве случаев только создаёт очень большие проблемы, не принося какой-то реальной пользы
А какие проблемы? С учетом, что подразумевается, например вставка, будет только уникальных. И как раз уникальность по 2 полям составного _id. Что может, потому что «переезжаю» сам на такой вариант.
 T~B
Привет, коллеги. Есть два сервера. Нужно отказоустоичивый кластер mongo. Хочу сделать replicaset. Подскажите арбитр где лучше располагать на мастере или слейве?
 Дмитрий
Nick
А какие проблемы? С учетом, что подразумевается, например вставка, будет только уникальных. И как раз уникальность по 2 полям составного _id. Что может, потому что «переезжаю» сам на такой вариант.
проблемы косвенные:
1. размер индекса больше, т.к. содержит весь объект
2. раньше было ограничение на размер индексируемого поля и требовало дополнительного контроля при работе с объектами
3. необходимость строго следовать порядку и набору полей в объекте для корректного поиска. Например переход на другую json либу, которая вдруг начнет менять порядок полей в запросе вам гарантирвоанно сломает работу.
4. к 3 изменение полей в таком _id выливается в определенный прикол
5. невозможность пользоваться индексом для поиска по отдельным полям как в случае выше, что выливается в добавлении еще одного индекса - что можно было бы сразу и сделать
6. если данные из этой коллекции надо кудато лить, то работа с _id как уникальным ключом на стороне приемника тоже становится увлекательным занятием
Andrey
проблемы косвенные:
1. размер индекса больше, т.к. содержит весь объект
2. раньше было ограничение на размер индексируемого поля и требовало дополнительного контроля при работе с объектами
3. необходимость строго следовать порядку и набору полей в объекте для корректного поиска. Например переход на другую json либу, которая вдруг начнет менять порядок полей в запросе вам гарантирвоанно сломает работу.
4. к 3 изменение полей в таком _id выливается в определенный прикол
5. невозможность пользоваться индексом для поиска по отдельным полям как в случае выше, что выливается в добавлении еще одного индекса - что можно было бы сразу и сделать
6. если данные из этой коллекции надо кудато лить, то работа с _id как уникальным ключом на стороне приемника тоже становится увлекательным занятием
Про порядок и json либу, да, соглашусь, но с таким не сталкивался.
А Если логикой как раз и нужна уникальность пары значений в полях, то к индексу по _id прибавляется индекс по объекту, пусть - v с этими полями, и при объемах в(от) млрд, уже индекс просто по _id прям напрягает, когда он только для аыгрузки данных, и никакого смысла более не несет, почему бы это “v” не заменить на _id?
Nick
Про порядок и json либу, да, соглашусь, но с таким не сталкивался.
А Если логикой как раз и нужна уникальность пары значений в полях, то к индексу по _id прибавляется индекс по объекту, пусть - v с этими полями, и при объемах в(от) млрд, уже индекс просто по _id прям напрягает, когда он только для аыгрузки данных, и никакого смысла более не несет, почему бы это “v” не заменить на _id?
если вы будете работать только с объектом целиком и нет потребности делать выборки по составляющим этого ключа то норм. Но тогда можно и дальше пойти, почему вообще такая сложная конструкция нужна, сформируйте просто бинарь из этого объекта, сэкономив на накладные расходы
Andrey
если вы будете работать только с объектом целиком и нет потребности делать выборки по составляющим этого ключа то норм. Но тогда можно и дальше пойти, почему вообще такая сложная конструкция нужна, сформируйте просто бинарь из этого объекта, сэкономив на накладные расходы
Да, но нужно искать по 1 из 3 вынутоеннихполей. Поэтому и уникальность 3-ки при вставке, избегаем дублирование и остается возможность искать по 1 из составляющих.
Nick
Nick
Да, но нужно искать по 1 из 3 вынутоеннихполей. Поэтому и уникальность 3-ки при вставке, избегаем дублирование и остается возможность искать по 1 из составляющих.
ну и опять что мешает это поле вытащить как самостоятельное, а в _id положить упакованный бинарь
Andrey
ну вот вам опять нужен еще один индекс
Так уникальность тоже нужна, это все равно будет составной, но на другое поле, пусть v. А сворачивать в условных бинарь, это означает терять, 2 других значения, верней не терять, или их просто отдельно хранить. Так я понял, то есть от них делать хэш - его писать в _id, и их хранит отдельно по полям? Но ведь база все равно их во что то условно «хэширует» ?
Andrey
Условно, если хэш - от этой уникальной n (пары , тройки …) - перевести в int64, а их значения хранить отдельно, это будет лучше если в поле _id просто их писать как поля со значениями?
Nick
Так уникальность тоже нужна, это все равно будет составной, но на другое поле, пусть v. А сворачивать в условных бинарь, это означает терять, 2 других значения, верней не терять, или их просто отдельно хранить. Так я понял, то есть от них делать хэш - его писать в _id, и их хранит отдельно по полям? Но ведь база все равно их во что то условно «хэширует» ?
не хэширует, просто сериализует bson в байты вместе с названиями полей. Этот бинарь уже идет в индекс b-tree. При поиске соответственно поиск идет тоже сриализумого в бинарь объекта
Nick
Так уникальность тоже нужна, это все равно будет составной, но на другое поле, пусть v. А сворачивать в условных бинарь, это означает терять, 2 других значения, верней не терять, или их просто отдельно хранить. Так я понял, то есть от них делать хэш - его писать в _id, и их хранит отдельно по полям? Но ведь база все равно их во что то условно «хэширует» ?
имел в виду в _id пишем f(a,b,c), и c еще отдельным полем в сам док и индекс еще по нему для поиска
Nick
Условно, если хэш - от этой уникальной n (пары , тройки …) - перевести в int64, а их значения хранить отдельно, это будет лучше если в поле _id просто их писать как поля со значениями?
в целом да, главное помнить что не каждый хэш на ваших данных будет хорош и может жрать больше места чем тот же объект изза рендомности содержимого, ну и коллизии
Andrey
имел в виду в _id пишем f(a,b,c), и c еще отдельным полем в сам док и индекс еще по нему для поиска
Да да я понял, интересно. А чего мы (в данном случае производительность?) добиваемся от «ограничения» на размер по полю _id. Ну ок, то есть гарантируем размер _id. Но ведь для может же быть так, они в сумме будет чаще давать, меньший размер, а мы всегда гарантируем 1 и тот же? Разве нет?
Andrey
Nick
Да да я понял, интересно. А чего мы (в данном случае производительность?) добиваемся от «ограничения» на размер по полю _id. Ну ок, то есть гарантируем размер _id. Но ведь для может же быть так, они в сумме будет чаще давать, меньший размер, а мы всегда гарантируем 1 и тот же? Разве нет?
это уже от ваших потребностей зависит, решение же не выбирается просто так в вакууме
Nick
Да да я понял, интересно. А чего мы (в данном случае производительность?) добиваемся от «ограничения» на размер по полю _id. Ну ок, то есть гарантируем размер _id. Но ведь для может же быть так, они в сумме будет чаще давать, меньший размер, а мы всегда гарантируем 1 и тот же? Разве нет?
и да добиваемся уменьшения размера, как это было сказано вот тут https://t.me/mongodb_ru/133811
 Danil
 Danil
 Danil
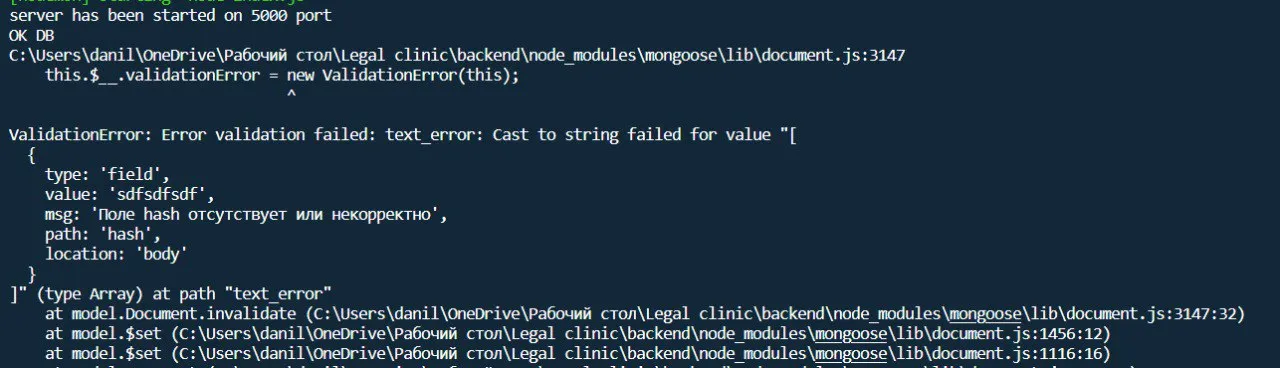
в чем дело?
Nick
Danil
В ошибке написано что пытаетесь массив к строке кастануть
не могу понять где я это пытаюсь сделать
 Александр
Очень долго с получением count
+6.100.000 записей по regex
Есть параметр title, по нему очень долго ищет именно количество найденых записей. (.find(…).count() или .countDocuments(…), значение не имеет)
Но вот по
history.titles
Который выглядит как массив с объектами
[{title: "", date: Date}, …]
работает все быстро
И там и там есть индекс
title_1 и title_text
history.$**_1
Может я не то делаю, может индекс не верный, может запрос не правильный и можно оптимизировать
Именно с количеством проблема а не с получением документов
Я уже думал может от количества влияет, но нет, даже 1 он ищет долго
А по названиям в историях быстро даже если 200000 записей находит
Александр
db.chats.find({title: /test/i}).count(); // долго
db.chats.find({"history.titles.title": /test/i}).count(); // быстро
Александр
из за этого приходится использовать $text $search но он не такой точный как tegexp
Александр
И пересоздавал индексы к title и что только не делал, очень долго, секунд 10 а то и больше занимает поиск (именно количества)
Сотрудник 236
может из-за доп.индекса?
Сотрудник 236
Попробоуй аггрегейшн сделать
Сотрудник 236
Кстати, может не везде есть history. поэтому быстро.
Сотрудник 236
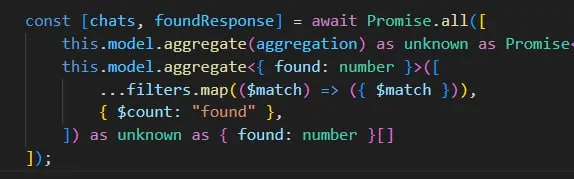
ты юзаешь find. попробуй db.chats.aggregate([]) и там через match
Александр
Говорю, его и использую
Не помогает, find был как пример что бы было понятно
Александр
Дома позже буду покажу
 Ящик водки
Эээ, откровенно сложно понять, что вы тестировали и как, общие моменты только, а зачем вам skip?, вы типа «пагинацию» через skip реализовываете?
пагинация через скип + лимит, да
есть другой способ лучше?
Ящик водки
Хорошая работа по тестированию драйвера для питона, сходите ишью напишите, может доработают
можно отправлять команды напрямую и через explain смотреть время.
результаты тестирования одинаковые.
find работает быстрее, чем аггрегация
Ящик водки
из за этого приходится использовать $text $search но он не такой точный как tegexp
что значит не такой точный?
это в принципе 2 разных типа поиска.
нужно начать с основ и почитать про виды текстовых поисков, а потом уже куда-либо лезть, особенно в регулярки, что является самым крайним способом реализовывать текстовый поиск...
Andrey
пагинация через скип + лимит, да
есть другой способ лучше?
я пишу свои "велосипеды" и стараюсь избегать скип.
Игорь
Привет!
Debian 11, ставлю mongodb 7.0 по официальной инстукции.
Устанавливается, но не стартует. В логах есть только такое:
Started MongoDB Database Server.
systemd[1]: mongod.service: Main process exited, code=killed, status=4/ILL
systemd[1]: mongod.service: Failed with result 'signal'.
kernel: [ 6736.315052] traps: mongod[55040] trap invalid opcode ip:560ef34c08fc sp:7fff6abcb6d0 error:0 in mongod[560eef305000+4286000]
Где еще что можно посмотреть, в чем проблема?
Устанавливал через
http://repo.mongodb.org/apt/debian bullseye/mongodb-org/7.0 main
Игорь
Привет!
Debian 11, ставлю mongodb 7.0 по официальной инстукции.
Устанавливается, но не стартует. В логах есть только такое:
Started MongoDB Database Server.
systemd[1]: mongod.service: Main process exited, code=killed, status=4/ILL
systemd[1]: mongod.service: Failed with result 'signal'.
kernel: [ 6736.315052] traps: mongod[55040] trap invalid opcode ip:560ef34c08fc sp:7fff6abcb6d0 error:0 in mongod[560eef305000+4286000]
Где еще что можно посмотреть, в чем проблема?
Устанавливал через
http://repo.mongodb.org/apt/debian bullseye/mongodb-org/7.0 main
если вручную выполнить
/usr/bin/mongod --config /etc/mongod.conf
получаю "Недопустимая инструкция" 🤨
Danil
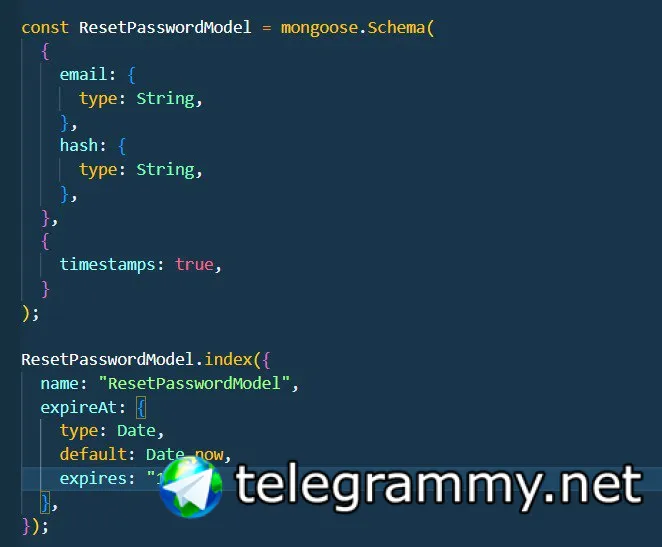
ребят, как в монго удалить запись через определенное время автоматически, нашел только как удалять коллекции
-
 -
 Danil
 -
Монга проверяет с интервалом 1 минуту, тут как повезет
Danil
вообще я думаю есть такие кейсы, когда данные нужно хранить очень малый срок и с точностью до секунды
 Нуриддин
Max
Всем привет)
Коллеги, кто знает, почему метод у Mongoose .findOneAndUpdate перезаписывает документ в базе?
Через $set или просто положив целевые поля, метод перезаписывает документ, т.е.удаляет те поля, которые не обновляю.
В доке подобное поведение не нашёл.
Max
Всем привет)
Коллеги, кто знает, почему метод у Mongoose .findOneAndUpdate перезаписывает документ в базе?
Через $set или просто положив целевые поля, метод перезаписывает документ, т.е.удаляет те поля, которые не обновляю.
В доке подобное поведение не нашёл.
Есть кто подсказать по методу, может я что-то не так делаю?)
Nick
Всем привет)
Коллеги, кто знает, почему метод у Mongoose .findOneAndUpdate перезаписывает документ в базе?
Через $set или просто положив целевые поля, метод перезаписывает документ, т.е.удаляет те поля, которые не обновляю.
В доке подобное поведение не нашёл.
меняет только то что сказано менять. Если будет использован $unset то тогда уберет указанные поля. Для полной замены документа нужно использовать replaceOne
Max
меняет только то что сказано менять. Если будет использован $unset то тогда уберет указанные поля. Для полной замены документа нужно использовать replaceOne
Да вот тоже так думал, но этот код:
.findOneAndUpdate(
{ _id },
{ ...updatingData },
{ new: true, runValidators: true }
);
удаляет те поля, которые я не обновляю
Ivan
Max
это не надо new: true,
так это лишь для того, чтобы обновлённый док вернуть, это же не для логики обновления
Ivan
так это лишь для того, чтобы обновлённый док вернуть, это же не для логики обновления
updatingData тут что?
Max
updatingData тут что?
объект с полями, который нужно обновить, но у этого объекта могут быть поля, у которых значение объект
Ivan
объект с полями, который нужно обновить, но у этого объекта могут быть поля, у которых значение объект
$set должно быть для обновления полей