.


он тебе в ответ такое {"dataset": [195028, 196197, 202654, 183856, 203057, 215141, 198738, 193167, 207001, 186703, 193454, 184391, 213854, 185221, 193604, 204119, 191233, 204853, 204879, 205226, 184966, 196745, 189114, 194652, 205045, 181561, 188096, 188238, 194070, 207361, 202717, 201722, 182251, 185000, 202045, 221695, 190610, 185631, 203336, 184199, 200647, 208605, 196755, 191361, 186224, 208372, 195264, 201341, 191392, 205334, 188764, 204274, 200164, 206936, 195279, 191601, 188486, 193448], "labels": ["2022-10-04 00:00:00", "2022-10-19 00:00:00", "2022-11-15 00:00:00", "2022-11-16 00:00:00", "2022-10-07 00:00:00", "2022-10-27 00:00:00", "2022-11-25 00:00:00", "2022-11-29 00:00:00", "2022-11-17 00:00:00", "2022-11-11 00:00:00", "2022-11-24 00:00:00", "2022-11-05 00:00:00", "2022-10-13 00:00:00", "2022-10-18 00:00:00", "2022-11-12 00:00:00", "2022-11-19 00:00:00", "2022-11-28 00:00:00", "2022-10-24 00:00:00", "2022-11-13 00:00:00", "2022-11-26 00:00:00", "2022-10-16 00:00:00", "2022-10-17 00:00:00", "2022-10-23 00:00:00", "2022-10-25 00:00:00", "2022-11-07 00:00:00", "2022-10-11 00:00:00", "2022-10-26 00:00:00", "2022-10-31 00:00:00", "2022-10-14 00:00:00", "2022-11-04 00:00:00", "2022-11-08 00:00:00", "2022-11-03 00:00:00", "2022-11-09 00:00:00", "2022-10-28 00:00:00", "2022-11-23 00:00:00", "2022-10-22 00:00:00", "2022-10-05 00:00:00", "2022-11-10 00:00:00", "2022-11-06 00:00:00", "2022-11-22 00:00:00", "2022-10-20 00:00:00", "2022-10-08 00:00:00", "2022-10-21 00:00:00", "2022-10-09 00:00:00", "2022-10-10 00:00:00", "2022-10-15 00:00:00", "2022-10-12 00:00:00", "2022-11-14 00:00:00", "2022-11-21 00:00:00", "2022-11-30 00:00:00", "2022-11-27 00:00:00", "2022-11-18 00:00:00", "2022-10-30 00:00:00", "2022-10-29 00:00:00", "2022-11-01 00:00:00", "2022-11-02 00:00:00", "2022-11-20 00:00:00", "2022-10-06 00:00:00"]}
.
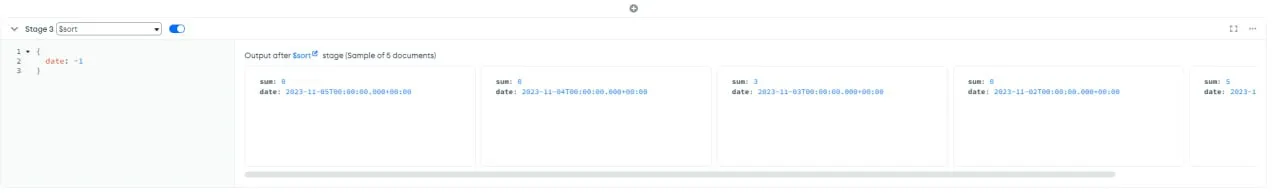
и вот здесь он пропускает 4 дня, в которых сумма значений равна 0
-
и вот здесь он пропускает 4 дня, в которых сумма значений равна 0
Помогла группировка через dateTrunc?
.
'$project': {
'_id': 0,
'day': {
'$dateTrunc': {
'date': "$date",
'unit': "day"
}
},
'sum_value': 1
}
.
мне кажется я что-то не так делаю
-
В group
-
Там где _id
.
уже делал
.
не помогло
.
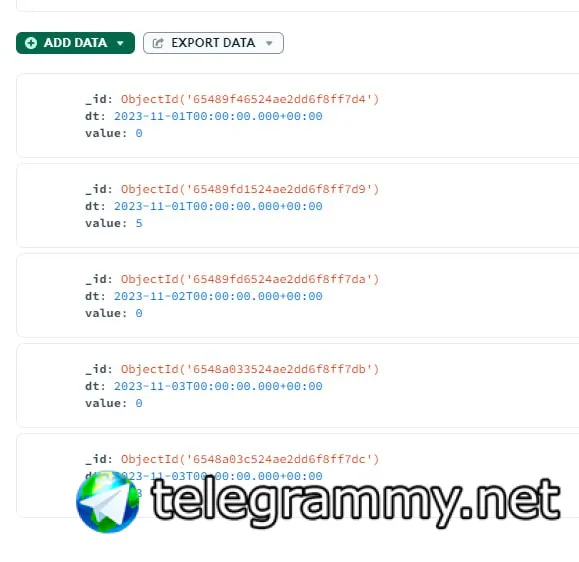
я так понимаю если в записи значение равно 0, то монго не учитывает эту запись?
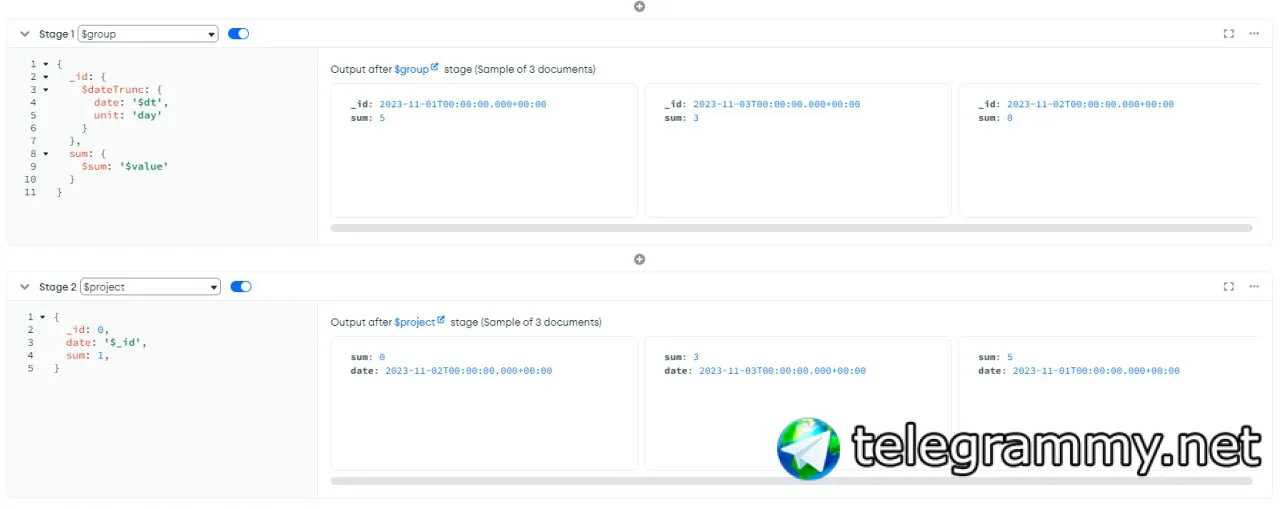 .
а попробуй например что бы в 1 из дней были только 0
.
он не должен отдать тогда тот день
.
а да, сори
 .
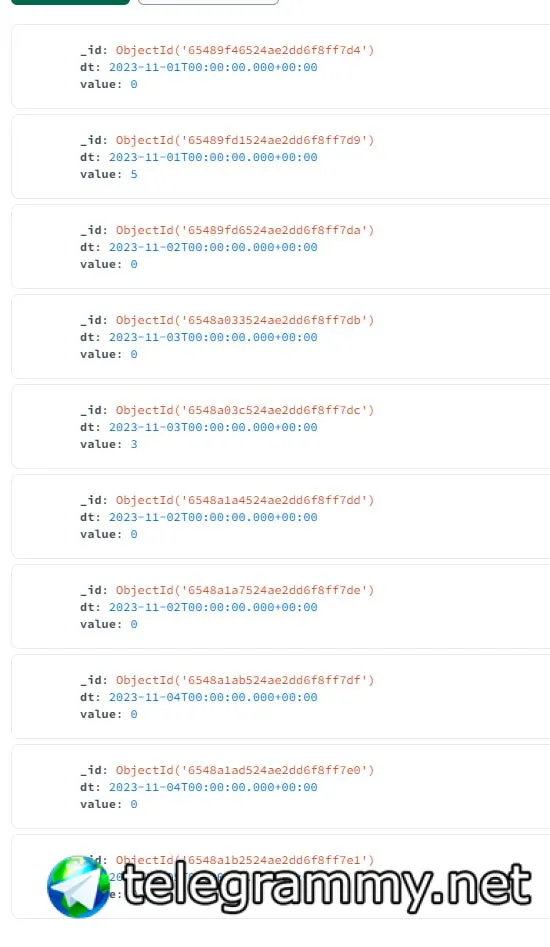
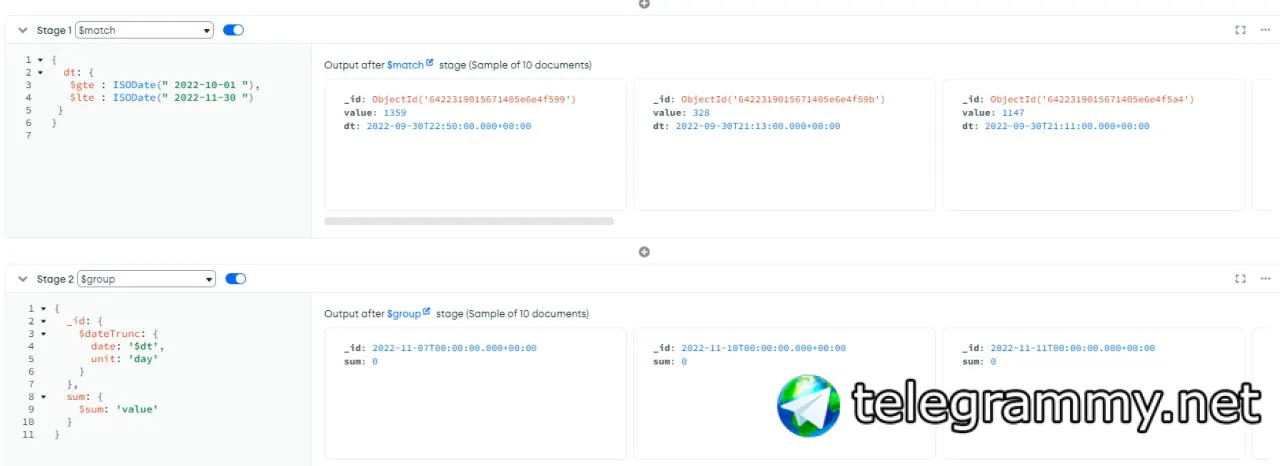 -
Есть же 0
.
но всезде нули)
.
все суммы равны 0
-
Так Compass показывает часть значений, причем он иногда и с сортировкой не показывает некоторые значения, хотя если делать запрос с бека, то всё ОК
-
А стоп
-
Ты $ пропустил
-
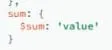 .
а все
.
спасибо большое)
Artem
Всем доброго дня, подскажите по архитектуре. Такой кейс, имеем каждый день некий отчет в котором примерно 5млн однотипных json объектов, по ним надо искать и агрегировать. Но только по этому конкретному отчету за 1 день.
Имеет смысл каждый день создавать новую коллекцию типа report1 или в одну коллекцию складывать с индексом report_id?
Как будет правильнее и где лучше будет перфоманс при поиске и агрегации, допустим при таком объеме через год в одной коллекции будет 1.8 млрд документов. Может у кого то есть опыт с примерным кейсом
.
Так Compass показывает часть значений, причем он иногда и с сортировкой не показывает некоторые значения, хотя если делать запрос с бека, то всё ОК
хахах, представь, не помогло) все равно сумм равных 0 нет)
.
Так Compass показывает часть значений, причем он иногда и с сортировкой не показывает некоторые значения, хотя если делать запрос с бека, то всё ОК
"dataset": [203336, 185221, 188238, 203057, 186224, 188764, 198738, 184966, 215141, 190610, 193167, 193448, 191392, 206936, 196755, 191601, 205226, 202717, 196745, 204879, 201341, 207001, 204853, 195028, 221695, 185000, 194652, 189114, 191361, 194070, 195279, 202045, 205045, 185631, 186703, 213854, 200164, 191233, 196197, 207361, 181561, 202654, 208605, 184391, 200647, 204119, 204274, 184199, 201722, 182251, 193454, 188096, 195264, 188486, 205334, 208372, 183856, 193604]
.
только отличные от 0
-
Может их нет на самом делел?
.
есть) вот что выдает другой бот за тот же период времени)
.
{"dataset": [0, 0, 0, 195028, 190610, 193448, 203057, 208605, 191361, 186224, 181561, 195264, 213854, 194070, 208372, 184966, 196745, 185221, 196197, 200647, 196755, 221695, 189114, 204853, 194652, 188096, 215141, 185000, 206936, 200164, 188238, 195279, 191601, 201722, 207361, 184391, 203336, 205045, 202717, 182251, 185631, 186703, 193604, 204879, 201341, 202654, 183856, 207001, 204274, 204119, 188486, 191392, 184199, 202045, 193454, 198738, 205226, 188764, 191233, 193167, 205334]
.
все сходится кроме первых 0 нулей
.
ладно, спасибо за помощь, буду дальше разбираться
.
если будет время, попробуй на моей базе
Mllse
Здравствуйте. Есть либа: https://github.com/Dashride/mongoose-auto-increment, но судя по всему, последнее обновление было с 2018 года. Стоит ли ее использовать и есть актуалочка?
-
Mllse
Да задача требует auto increment
Mllse
можно конечно по своему делать, но хочется через плагин как то прогонять
Artem
Всем доброго дня, подскажите по архитектуре. Такой кейс, имеем каждый день некий отчет в котором примерно 5млн однотипных json объектов, по ним надо искать и агрегировать. Но только по этому конкретному отчету за 1 день.
Имеет смысл каждый день создавать новую коллекцию типа report1 или в одну коллекцию складывать с индексом report_id?
Как будет правильнее и где лучше будет перфоманс при поиске и агрегации, допустим при таком объеме через год в одной коллекции будет 1.8 млрд документов. Может у кого то есть опыт с примерным кейсом
Ребят, хелп плиз, может кто проектировал и сталкивался с таким?
Artem
а если есть возможность только mongodb использовать то что бы посоветовали?
Anton
а если есть возможность только mongodb использовать то что бы посоветовали?
Записывай в одну коллекцию под разными айдт
 Nick
Да задача требует auto increment
пишите что за задача такая, требущая автоинкременты, собираю коллекцию где без них релаьно никак
Mllse
пишите что за задача такая, требущая автоинкременты, собираю коллекцию где без них релаьно никак
Требования со стороны заказчика, CRM. Где номер заказа должен идти авто инкременты, а не ObjectId
Nick
Требования со стороны заказчика, CRM. Где номер заказа должен идти авто инкременты, а не ObjectId
в чем проблема сходить к заказчику и спросить на кой ему автоинкремент и где именно используется этот номер и почему он должен быть именно таким?
Mllse
в чем проблема сходить к заказчику и спросить на кой ему автоинкремент и где именно используется этот номер и почему он должен быть именно таким?
Номер будет в логистике, при оплате, при админстратирования, короче система там жирная, ему бы хотелось бы эту читабельность
Nick
Номер будет в логистике, при оплате, при админстратирования, короче система там жирная, ему бы хотелось бы эту читабельность
отлично, читабельность != автоинкремент, значит там достаточно чтобы просто были числа например. Как много заказов в день формируется?
Mllse
отлично, читабельность != автоинкремент, значит там достаточно чтобы просто были числа например. Как много заказов в день формируется?
Это маркетплейс по типу озона, а сколько заказов в день я не могу сказать, но судя по товаром, которые мне прислали таблицу, там штук 1800
-
Самое банальное это Math.ceil(Date.now / 1000)
Nick
Это маркетплейс по типу озона, а сколько заказов в день я не могу сказать, но судя по товаром, которые мне прислали таблицу, там штук 1800
хех, ну объемов озона явно не будет, значит за глаза юникстайма с секундами
-
На работе подключал платежные системы и там банки требуют orderId типа Int32 (Number) поэтому чтобы не делать велосипед, сделал timestamp с секундами + округление
Nick
можно вычитать например таймштамп начала 2023 года, чтобы цифра не была супер большая. Или просто перевести в строку вида 231107-112233
Mllse
хм, использовать таймшап это как идея, чет не додумался до этого) Спасибо большое за совет
 Easy Rider
Кто работал с текстовыми индексами? Там язык надо указывать или пофиг, и монга сама определяет язык?
Easy Rider
Например у меня есть некая лента с бесконечной прокруткой и при скролле показываются очередные 50 заголовков некого агрегатора. Я хочу чтобы можно было навесить еще на фильтр фразу и чтобы показывались (если она есть в фильтре) только те заголовки которые соответствуют фразе. Но при этом заголовки могут быть на разных языках и фраза тоже
Ilya
Такой вопрос
У меня на сервере бот с монго запущенные в докере, сервер VPS не GUI, можно ли как нибудь с локальной машины с помощью монго компоса подключиться к серверу в докер к монге?)
 Yaro
Такой вопрос
У меня на сервере бот с монго запущенные в докере, сервер VPS не GUI, можно ли как нибудь с локальной машины с помощью монго компоса подключиться к серверу в докер к монге?)
Можно прокинуть порт по ssh -L
Затем запустить контейнер с —network=host
И подключиться на локальный порт
 Асель
А еще вопрос. Бэкапы че-то не отменяются по cancel. Отдает сообщение, что стартовала отмена бэкапа и до свидания, бэкап идёт, отмена вечна. Только килять агентов приходится. У вас норм отменяется?
Здравствуйте! Подскажите пожалуйста, в итоге пробовали восстанавливать физ бэкап перконы на большом объеме?
Maksim Drazdou
привет, а в atlas нужно регаться и входить через vpn?
Maksim Drazdou
бле
 Богдан
 Nick
Nick
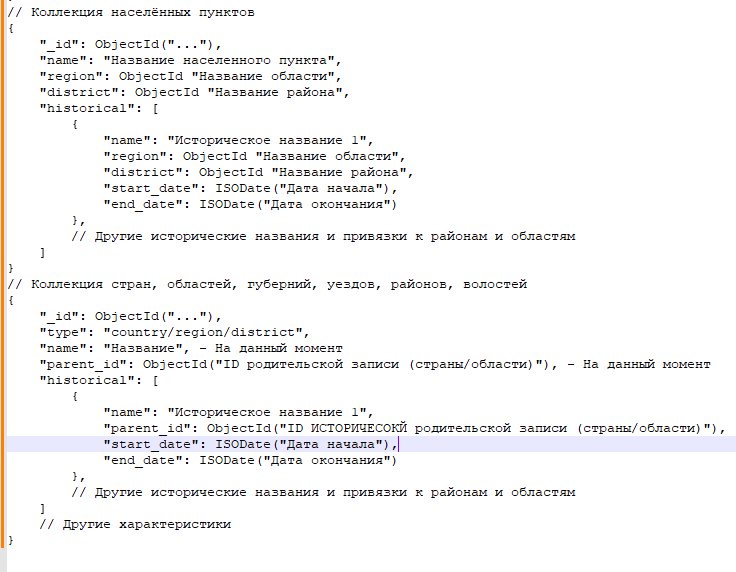
ну и ест ьсомнения что реально можно покрыть линейной историей объекты которые не только укрупняются, но и делятся и выносятся в новые сущности
Богдан
нормально выглядит. Единственный тонкий момент это хранение истории в массиве и будет ли это удобным не только для ведения информации, но и для какихто запросов с аналитикой
А как можно по другому записывать исторические изменения? Вчера я сделал немного сложнее структуру, так голову сломал делая запросы. Сегодня решил упростить пока что
Богдан
ну и ест ьсомнения что реально можно покрыть линейной историей объекты которые не только укрупняются, но и делятся и выносятся в новые сущности
Да, всё верно. К примеру Москва включила в себя сотни деревень вокруг неё. По сути можно сделать сущность старой деревни и сделать связь ,что она сейчас в составе Москвы. Если нас пункт делится, то это вопрос. Но думаю, пока что не усложнять так сильно. Сейчас проект хочу вывести на MVP
Nick
А как можно по другому записывать исторические изменения? Вчера я сделал немного сложнее структуру, так голову сломал делая запросы. Сегодня решил упростить пока что
по другому - это есть мысль сделать развернуть массивы исторические в отдельные самостоятельные записи, и фактически у вас кроме связи с родителем по территориальной иерархии появится родитель по истории. Но это кажется что усложнит на стадии mvp.
Но вообще видится что здесь должна быть сложная многоуровневая графовая структура отношений и ее наверное будет сложно закодить в лоб даже в монге, точнее закодить можно, но работать наверняка будет ужасно сложно. В этом варианте можно было бы просто глянуть на графовые бд. Но без понимания как система будет использоватсья сложно однозначно советовать, на mvp достаточно и вашего варианта
Богдан
по другому - это есть мысль сделать развернуть массивы исторические в отдельные самостоятельные записи, и фактически у вас кроме связи с родителем по территориальной иерархии появится родитель по истории. Но это кажется что усложнит на стадии mvp.
Но вообще видится что здесь должна быть сложная многоуровневая графовая структура отношений и ее наверное будет сложно закодить в лоб даже в монге, точнее закодить можно, но работать наверняка будет ужасно сложно. В этом варианте можно было бы просто глянуть на графовые бд. Но без понимания как система будет использоватсья сложно однозначно советовать, на mvp достаточно и вашего варианта
Благодарю за обратную связь!! Да, что-то сложное я делать пока не готов, да и знаний не хватит. Тогда оставляю пока как есть, а уже потом буду привлекать спеца по базам, чтобы всё красиво было)
Kenya-West
Всем привет!
Веду записи в базе, например, вот такие:
{
userId: String // ну гуид;
name: String;
phone: String;
chatId: String;
chatType: 'group' | 'tetatet';
}
У одного userId может быть несколько chatId. Точнее, если заселектить {userId: <идшник>}, то chatId могут быть разные.
Задача: получить список chatId для конкретного userId. Записей может быть как 0, так и 100000000000.
Проблема: я простая фронтенд-макака, которая задницей чует, что селектить миллиард записей ради составления списка chatId - какой-то явно не тот способ. Как эта тривиальная проблема решается в Монге?
 Kvhqm
Kenya-West
Ну в параметрах поиска указать что тебе нужно
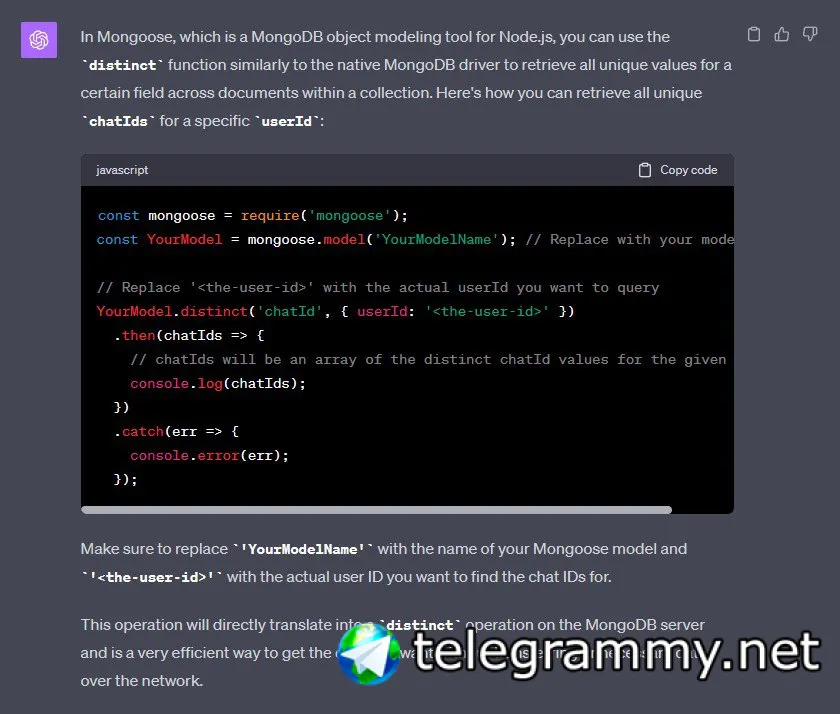
Прочитал про distinct, вроде оно самое. То есть мне не надо всякие там отдельные сущности по chatId создавать и поддерживать. Удобненько! Круто!
Nick
Всем привет!
Веду записи в базе, например, вот такие:
{
userId: String // ну гуид;
name: String;
phone: String;
chatId: String;
chatType: 'group' | 'tetatet';
}
У одного userId может быть несколько chatId. Точнее, если заселектить {userId: <идшник>}, то chatId могут быть разные.
Задача: получить список chatId для конкретного userId. Записей может быть как 0, так и 100000000000.
Проблема: я простая фронтенд-макака, которая задницей чует, что селектить миллиард записей ради составления списка chatId - какой-то явно не тот способ. Как эта тривиальная проблема решается в Монге?
ну если нужны все то тащим все, не нужно все то оффсетами и лимитами определяем что именно надо. Можно еще агргеаты накрутить чтобы например количества подсчитать