 -


Лучше в докере запустить
 հ९९հօօժ
в C:\\vkbase.db
հ९९հօօժ
пробывал
 Alex
Всем привет! Подскажите, пожалуйста, можно ли восстановить моего дамп через моего шел?
 yopp
Всем привет! Подскажите, пожалуйста, можно ли восстановить моего дамп через моего шел?
Здравствуйте. Нет, только через mongorestore
Alex
Здравствуйте. Нет, только через mongorestore
Спасибо. При восстановлении старые данные затрутся?
yopp
Спасибо. При восстановлении старые данные затрутся?
Нет. Но если документы с таким _id будут существовать, то при восстановлении вы увидите ошибки duplicate key. Такие документы не будут вставлены. Т.е существующие и в бэкапе и в базе документы не будут обновлены
Roman
Привет всем.
Столкнулся со странной проблемой, может кто-то подскажет, в чем дело.
Есть локальная база и дев база в кубернетесе. Обе версии 5.0.0
В обе базы шлю одинаковый запрос:
db.mycollection.find({},{"entries":{"$slice":[0,10]},"totalEntries":{"$size":"$entries"}});
В локальной базе получаю ожидаемый ответ - список entries c размером списка.
В дев базе получаю ошибку “Query failed with error code 2 with name ‘’ and error message ‘Unknown projection operator $size’ on server”
вроде и логично, такого projection оператора нет, но тогда как оно работает в первом случае? Неужели в монго есть какой-то механизм, который может фиксить запросы и в первом случае он запрос пофиксил?
 Hellomik
Хай как делать replica set с логином и паролем ?
 Владислав
С чего начать изучение монги и для каких сервисов её использование максимальный профит доставляет?
Сейчас имею знания SQL, сложно ли будет привыкать к MDB?
(Знаю банальный вопрос, но просто хочу сменить профиль работы, в печёнках уже SQL)
Ну с metanit можно начать, а дальше по накатанной в интернетах. Главное понять и перенять принцип (идеологию) данных, а не делать в монге базу аналог sql-льной)
Владислав
Хотя я сам до сих пор голову ломаю пытаясь в той же голове схему sql в моновую перестроить)
Даже как-то страх берет, что "а как так все данные в одном документе. Почему без связей!?"
Владислав
 Alex
Ребят, есть такая задачка:
Есть 2 коллекции: товары и пользователи (они к примеру).
У каждого товара есть овнер (_id пользователя).
Как написать запрос в базу, чтобы получить список пользователей, у которых ещё нет товаров?
 Ilya
В агрегации сделать лукап товаров по овнеру, и потом отфильтровать тех у кого нет товаров
 Магомед
В агрегации сделать лукап товаров по овнеру, и потом отфильтровать тех у кого нет товаров
Затратно, если товаров много
Магомед
Alex
Это не совсем то, что нужно
Alex
В агрегации сделать лукап товаров по овнеру, и потом отфильтровать тех у кого нет товаров
Это сожрёт всю производительность, т.к. товаров может быть сотни тысяч.
И потом планирую проверять не только коллекцию с товарами, но и другие коллекции
Магомед
Это не совсем то, что нужно
Для получения списка пользователей, у которых еще нет товаров, можно использовать запрос с использованием метода agreggate и оператора $lookup.
Вот пример запроса на языке MongoDB:
db.users.aggregate([
{
$lookup: {
from: "products", // Название коллекции товаров
localField: "_id", // Поле для связи с пользователем
foreignField: "owner", // Поле для связи с владельцем товара
as: "products" // Поле, в которое будет помещен результат связи
}
},
{
$match: {
products: { $size: 0 } // Проверяем, что поле products пустое
}
}
])
Этот запрос объединяет коллекции "users" и "products" по полю "id" и "owner" соответственно. Затем он фильтрует результаты, чтобы показать только те документы пользователей, у которых поле "products" пустое (т.е. у которых нет товаров).
Магомед
Если этих самых products будет несколько тысяч, насколько это критично?
Думаю по сравнению с получением всей продукции и последующей фильтрации такой запрос будет гораздо эффективнее (log n)
Alex
Магомед
 Али
Всем салам
В общем я "чайник" в аналитике данных - если че можете поржать 😂
Только собираюсь пройти курс.
Прежде чем поступлю, необходимо было пройти демо курс и показать результаты демо курса.
Во втором уроке необходимо было создать базу данных с помощью LibreOffice Base в папке - C:\Work\DataAnalyst
Под названием:
1) BoreiWork.odb
2) Новая база данных1.odb
В третем демо уроке необходимо настроить UWamp и SQLyog.
Теперь сам вопрос:
Ранее созданные базы данных BoreiWork.odb и Новая база данных1.odb - они должны отображаться в списке баз данных в SQLyog?
 Sergey
Коллеги, приветствую!
Может быть кто-нибудь сталкивался с такой проблемой в mongorestore.
Пробую поменять параметр--numParallelCollections=<int> а он почему-то игнорируется и по дефолту все равно ресторит 4 коллекции.
Пробовал менять в большую и меньшую сторону от дефолтового параметра 4, но результата никакого.
 Nick
Коллеги, приветствую!
Может быть кто-нибудь сталкивался с такой проблемой в mongorestore.
Пробую поменять параметр--numParallelCollections=<int> а он почему-то игнорируется и по дефолту все равно ресторит 4 коллекции.
Пробовал менять в большую и меньшую сторону от дефолтового параметра 4, но результата никакого.
- сколько коллекций в дампе?
- есть ли еще параметры запуска?
- дамп делался без доп опций?
Sergey
- сколько коллекций в дампе?
- есть ли еще параметры запуска?
- дамп делался без доп опций?
mongodump "$oplog_flag" \
--archive \
--gzip \
--readPreference="$MONGODB_READ_PREFERENCE" \
--uri "$MONGODB_URI" | \
mc $insecure_flag pipe minio/"$S3_BUCKET"/"$backup_archive"
Sergey
Коллекций большое кол-во))) уж точно более 4
Sergey
Ресторю соответственно
mc --insecure cat minio/$S3_BUCKET/mongodump_20230905_010001.gz | mongorestore --archive --gzip --uri "$MONGODB_URI" --numParallelCollections=8 --numInsertionWorkersPerCollection=8 --oplogReplay
Nick
Ресторю соответственно
mc --insecure cat minio/$S3_BUCKET/mongodump_20230905_010001.gz | mongorestore --archive --gzip --uri "$MONGODB_URI" --numParallelCollections=8 --numInsertionWorkersPerCollection=8 --oplogReplay
судя по сырцам меньше 4 не ставится т.к. с такой параллельностью создавался бэкап, берется инфа из него, а там дефолтное 4. А вот почему больше не ставится хз. Пока могу рекомендовать включить логи и искать "number of parallel collections" и "collections in parallel"
Sergey
Спасибо за помощь
yopp
Ресторю соответственно
mc --insecure cat minio/$S3_BUCKET/mongodump_20230905_010001.gz | mongorestore --archive --gzip --uri "$MONGODB_URI" --numParallelCollections=8 --numInsertionWorkersPerCollection=8 --oplogReplay
Это связано с тем что вы делали бэкап в формате archive
Так как это потоковый формат, возможности выбрать количество потоков или коллекций для развертки невозможно. Это возможно только на этапе создания архива
-
Он тебе прямо говорит, что ему нужен objectId, а ты пихаешь ему number
 Vladislav
Привет! А как понять, куда улетают деньги на Serverless инстанесе MongoDB Atlas? У меня ТГ бот для заказа еды в ресторанах. Там всего 400 юзеров, из которых только 100 пользуются, т.е. трафик не супер большой. При этом позапрошлый месяц был 1$ за месяц, прошлый - 5.63, а сейчас 6 день месяца и уже 2.42$. Я в шоке и не представляю что будет дальше и не могу понять, что фиксить. Я нашел только отчеты за день, где показано сколько RPU и сколько за это с меня взяли денег, но это ни о чем не говорит
 Artem
Всем привет!
А какие могут быть причины, если один и тот же запрос на разных нодах кластера, может выполняться в два раза бытсрее?
Конфигурация нод полностью идентична, по ресурсам и версиям ПО.
Версия Монги 6.0.6
 Vyacheslav
SSD/HDD?
Nick
Всем привет!
А какие могут быть причины, если один и тот же запрос на разных нодах кластера, может выполняться в два раза бытсрее?
Конфигурация нод полностью идентична, по ресурсам и версиям ПО.
Версия Монги 6.0.6
ноды кластера это ноды одного репликасета? измеряете на праймари/секондари или сек/сек? в первом случае где именно дольше исполняется?
Artem
Nick
Между секондари нодами.
ну и докучи все же попробуйте explain c executionStats параллельно смотря на нагрузку на сервере, в основном как диски юзаются
Андрей
Нужно смотреть метрики по нагрузке в окружении. Для чистоты эксперимента по очереди перевалить каждый стэндбай и выполнить запрос. В кэшах ничё не будет.
Artem
ноды кластера это ноды одного репликасета? измеряете на праймари/секондари или сек/сек? в первом случае где именно дольше исполняется?
Прошо прощения, между праймари и секондари. Разница только в чтении. Запросов пару-тройку сотен в минуту. Кеш прогревать? :)
Nick
Прошо прощения, между праймари и секондари. Разница только в чтении. Запросов пару-тройку сотен в минуту. Кеш прогревать? :)
так а быстрее на праймари или секондари?
 Aleksander
Ребят, всем привет! Подскажите пожалуйста, с монгой знакомлюсь только.
Есть задача сделать шардированный кластер монги.
Мне немного непонятно, как правильно сделать отказоустойчивую архитектуру. После чтения доки и статей я думаю сделать так:
3 отдельных хоста для конфиг сервера - они могут работать в кластере?
на 3-х хостах для конфиг сервера поднять mongos для подключения
и начать с двух шардов по 3 хоста с самими БД. То есть 2 кластера по 3 хоста и подключить их как шарды.
Подскажите пожалуйста, я правильно всё понимаю или что-то лучше сделать по другому?
Упор больше на HA.
yopp
При условии что сами реплики шардов на разных хостах
Aleksander
Спасибо! Да, планируется что всё будет на отдельных хостах, кроме mongos - он на хостах с конфиг серверами
Nick
Ребят, всем привет! Подскажите пожалуйста, с монгой знакомлюсь только.
Есть задача сделать шардированный кластер монги.
Мне немного непонятно, как правильно сделать отказоустойчивую архитектуру. После чтения доки и статей я думаю сделать так:
3 отдельных хоста для конфиг сервера - они могут работать в кластере?
на 3-х хостах для конфиг сервера поднять mongos для подключения
и начать с двух шардов по 3 хоста с самими БД. То есть 2 кластера по 3 хоста и подключить их как шарды.
Подскажите пожалуйста, я правильно всё понимаю или что-то лучше сделать по другому?
Упор больше на HA.
шарды это ортогонально от HA и про увеличение ресурсов на запись. Так что надо разбираться с простыми репликасетами и гарантиями которые можно накручивать
 Родион
Ребята, всем привет! Интересуют транзакции при рейскондишн. есть обработка запросов в цикле. если возникает ошибка WriteConflict обработка производится с начала. количество циклов естественно ограничено.. сессия транзакции стартует вначале каждой обрботки. и завершается либо commitTransaction либо abortTransaction в конце обработки.
Родион
при обработке сначала из бд выбирается запись, потом обновляется. так вот столкнулся с любопытным моментом. если выборка(findOne) делается не в сессии то теряется атомарность и полная обработка запроса делается два раза, хотя у записи меняется статус и обработка должна произойти только один раз.. на кучу конкурирующих запросов обработка полностью выполняется именно два раза.. крутил сегодня час и так и сяк.
Родион
скорее всего если в сессии делать findOne то монга дожидается коммитов предыдущих транзакций незаконченных. а если вне сессии то этот момент не учитывается и из бд данные берутся сразу какие там в данный момент есть.
правильно ли я понимаю причину?
Родион
про транзакции в связи с findOne в интернете как то совсем мало инфы )
Родион
и вообще с выборками
yopp
Вне сессии нет никаких гарантий кроме writeconcern и как следствие нет контекста текущей операции и как следствие нет информации о текущей транзакции
Родион
т.е. получается что если запущенно подряд несколько сессий то последующие сессии дожидаются окончания предыдущих? под нагрузкой несколько запросов приходят одновременно. использовал для тестирования пакет autocannon если что
Родион
запросы имею ввиду http запросы
Родион
но спасибо за информацию. обнадёжили меня )
Yevhenii
запустил команду на создание индекса в коллекции, он весьма жирный, примерно 30гб. можно ли как-то посмотреть статус или логи его создания?
Nick
запустил команду на создание индекса в коллекции, он весьма жирный, примерно 30гб. можно ли как-то посмотреть статус или логи его создания?
https://www.mongodb.com/docs/v3.0/tutorial/manage-in-progress-indexing-operations/#view-index-creation-operations
Nick
запустил команду на создание индекса в коллекции, он весьма жирный, примерно 30гб. можно ли как-то посмотреть статус или логи его создания?
то было чет старое, из актуальной доки прям пример запроса есть
https://www.mongodb.com/docs/manual/reference/method/db.currentOp/#active-indexing-operations
Aleksander
Всем привет! Подскажите пожалуйста, а кто-нибудь использует коннектор debezium с mongodb через SSL?
Mihail
 Anton K.
Mihail
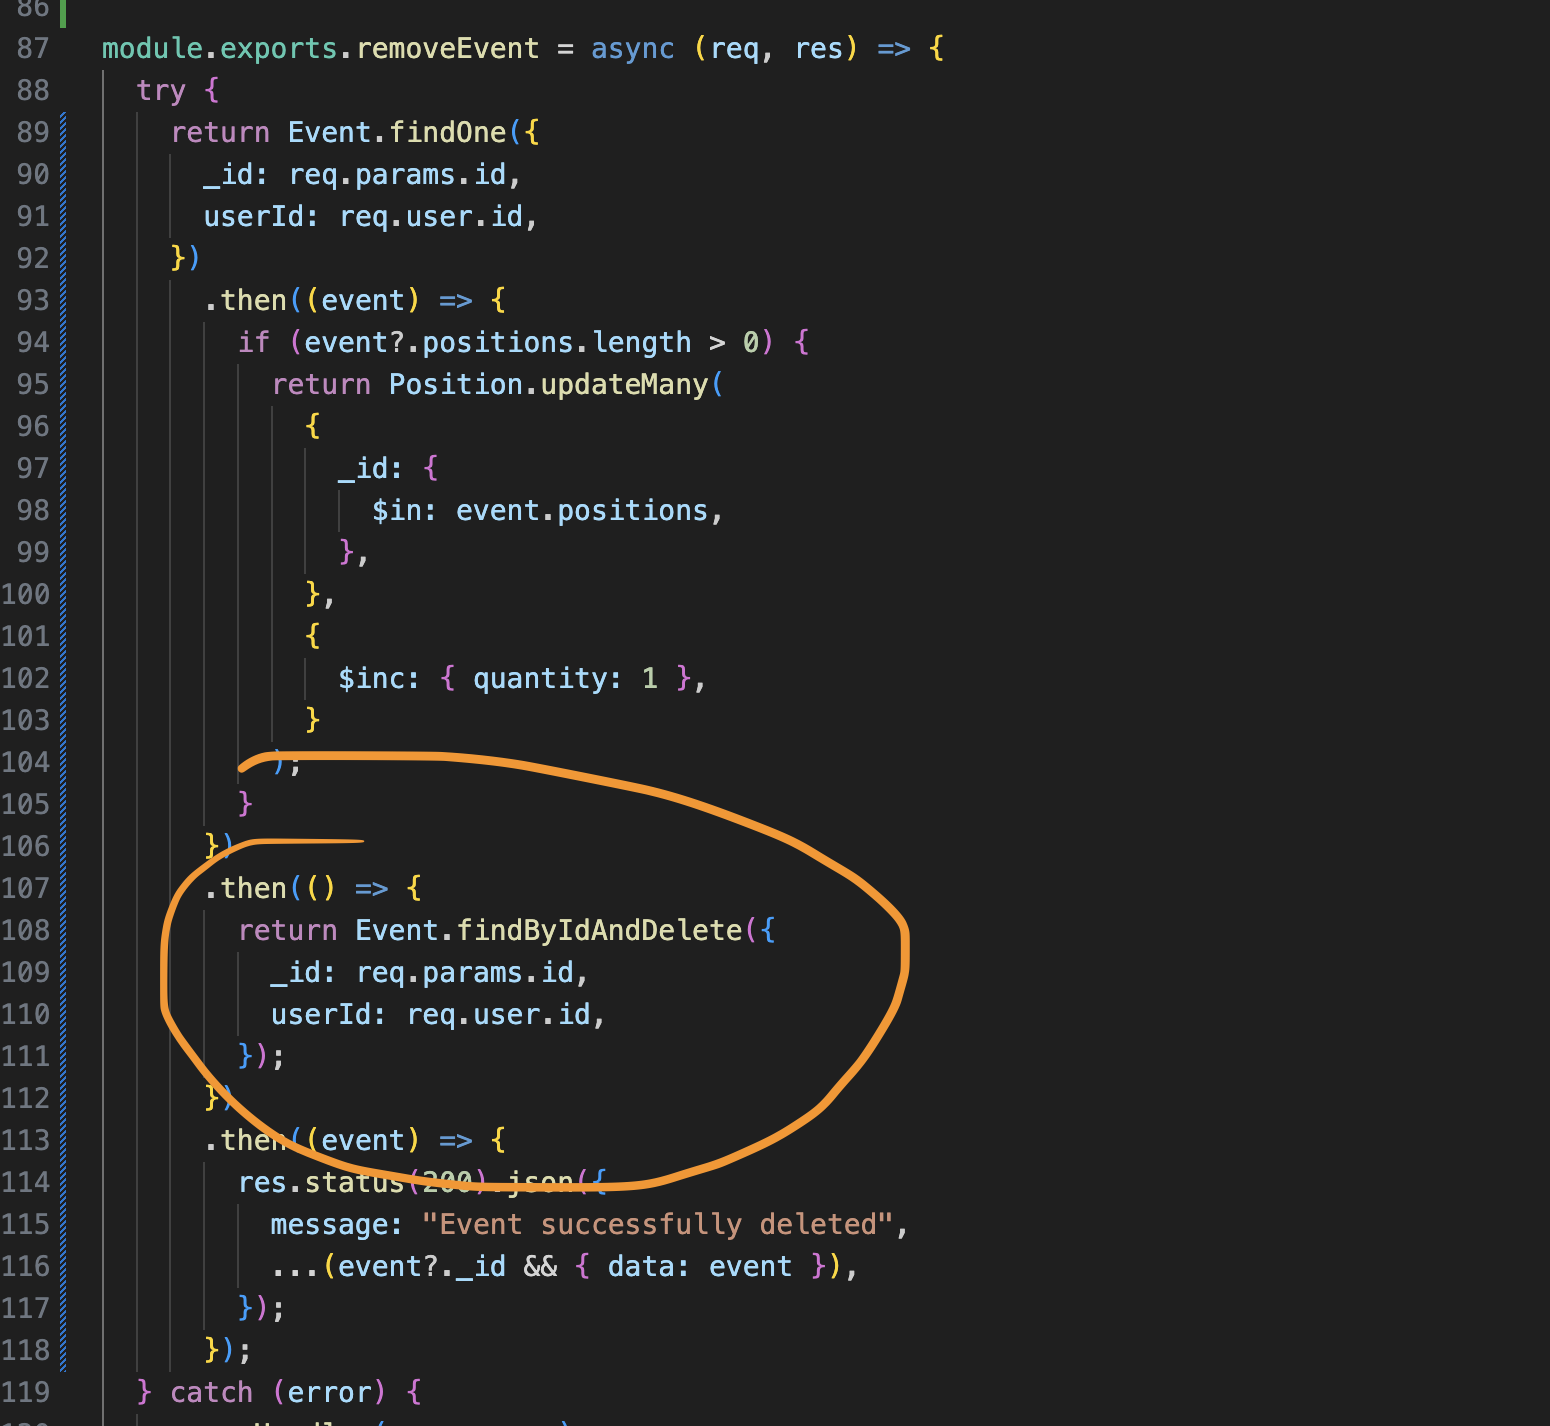
а чет уперся в метод с поиском, спс
 Kvhqm
Кстати, а можно удалять сущность целиком через поиск? Например так можно обновить (через findOne)
Т.е. логика такова
const value = await Model.findOne(option)
value = newValue
value.save()
Kvhqm
Т.е. если просто "сохранить" пустой объект, будет ошибка, или "сохранится" пустой документ, тем самым будет удалён?
Nick
Т.е. если просто "сохранить" пустой объект, будет ошибка, или "сохранится" пустой документ, тем самым будет удалён?
после value = newValue по факту вы будете вызывать метод на объекте newValue, а не на том который получили из базы. Чтобы удалить док из базы надо использовать delete* у казанимем в параметры _id дока для удаления
Nick
Т.е. если просто "сохранить" пустой объект, будет ошибка, или "сохранится" пустой документ, тем самым будет удалён?
и да будет ошибка, т.к. newValue пустой объект, который не имеет метода save()